
AI 编程工作流实践:用规格驱动开发(SDD)提升编码效率
作者: 程序员 Left @coder_left(AI Coding / 独立开发者)•发布日期: 2026-09-01•SDD 规范驱动开发实战
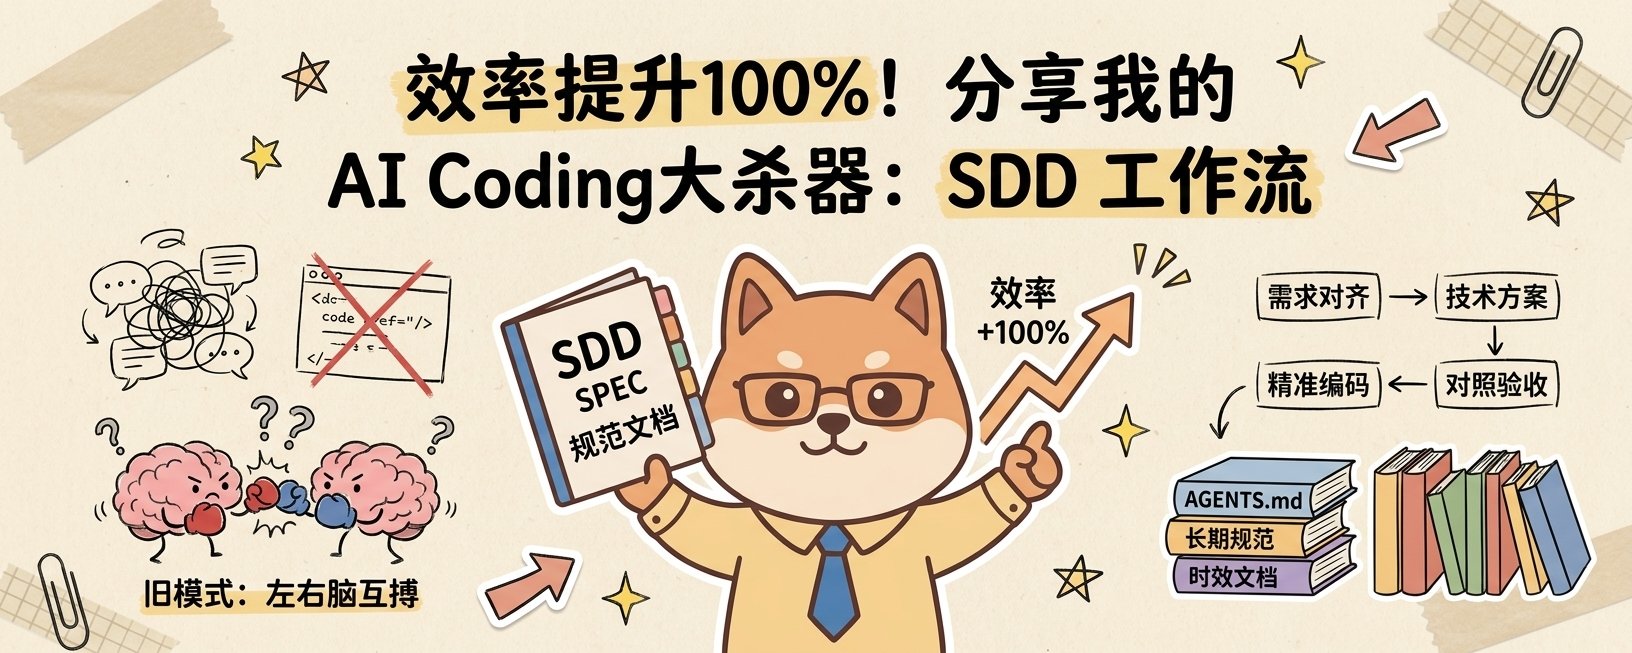 SDD 规范驱动开发工作流示意图
高强度用 AI 写代码时,你大概率遇到过这种情况:今天的 AI 推翻昨天写的代码,下一轮对话的 AI 改掉上一轮刚定好的逻辑。
明明三小时前刚和它定好接口规范,换个会话窗口或者连聊十几轮后,它突然擅自换了一套写法,把前面跑通的逻辑全部改乱。这种前后矛盾的问题,重度用 AI 写代码的人几乎都会踩坑。
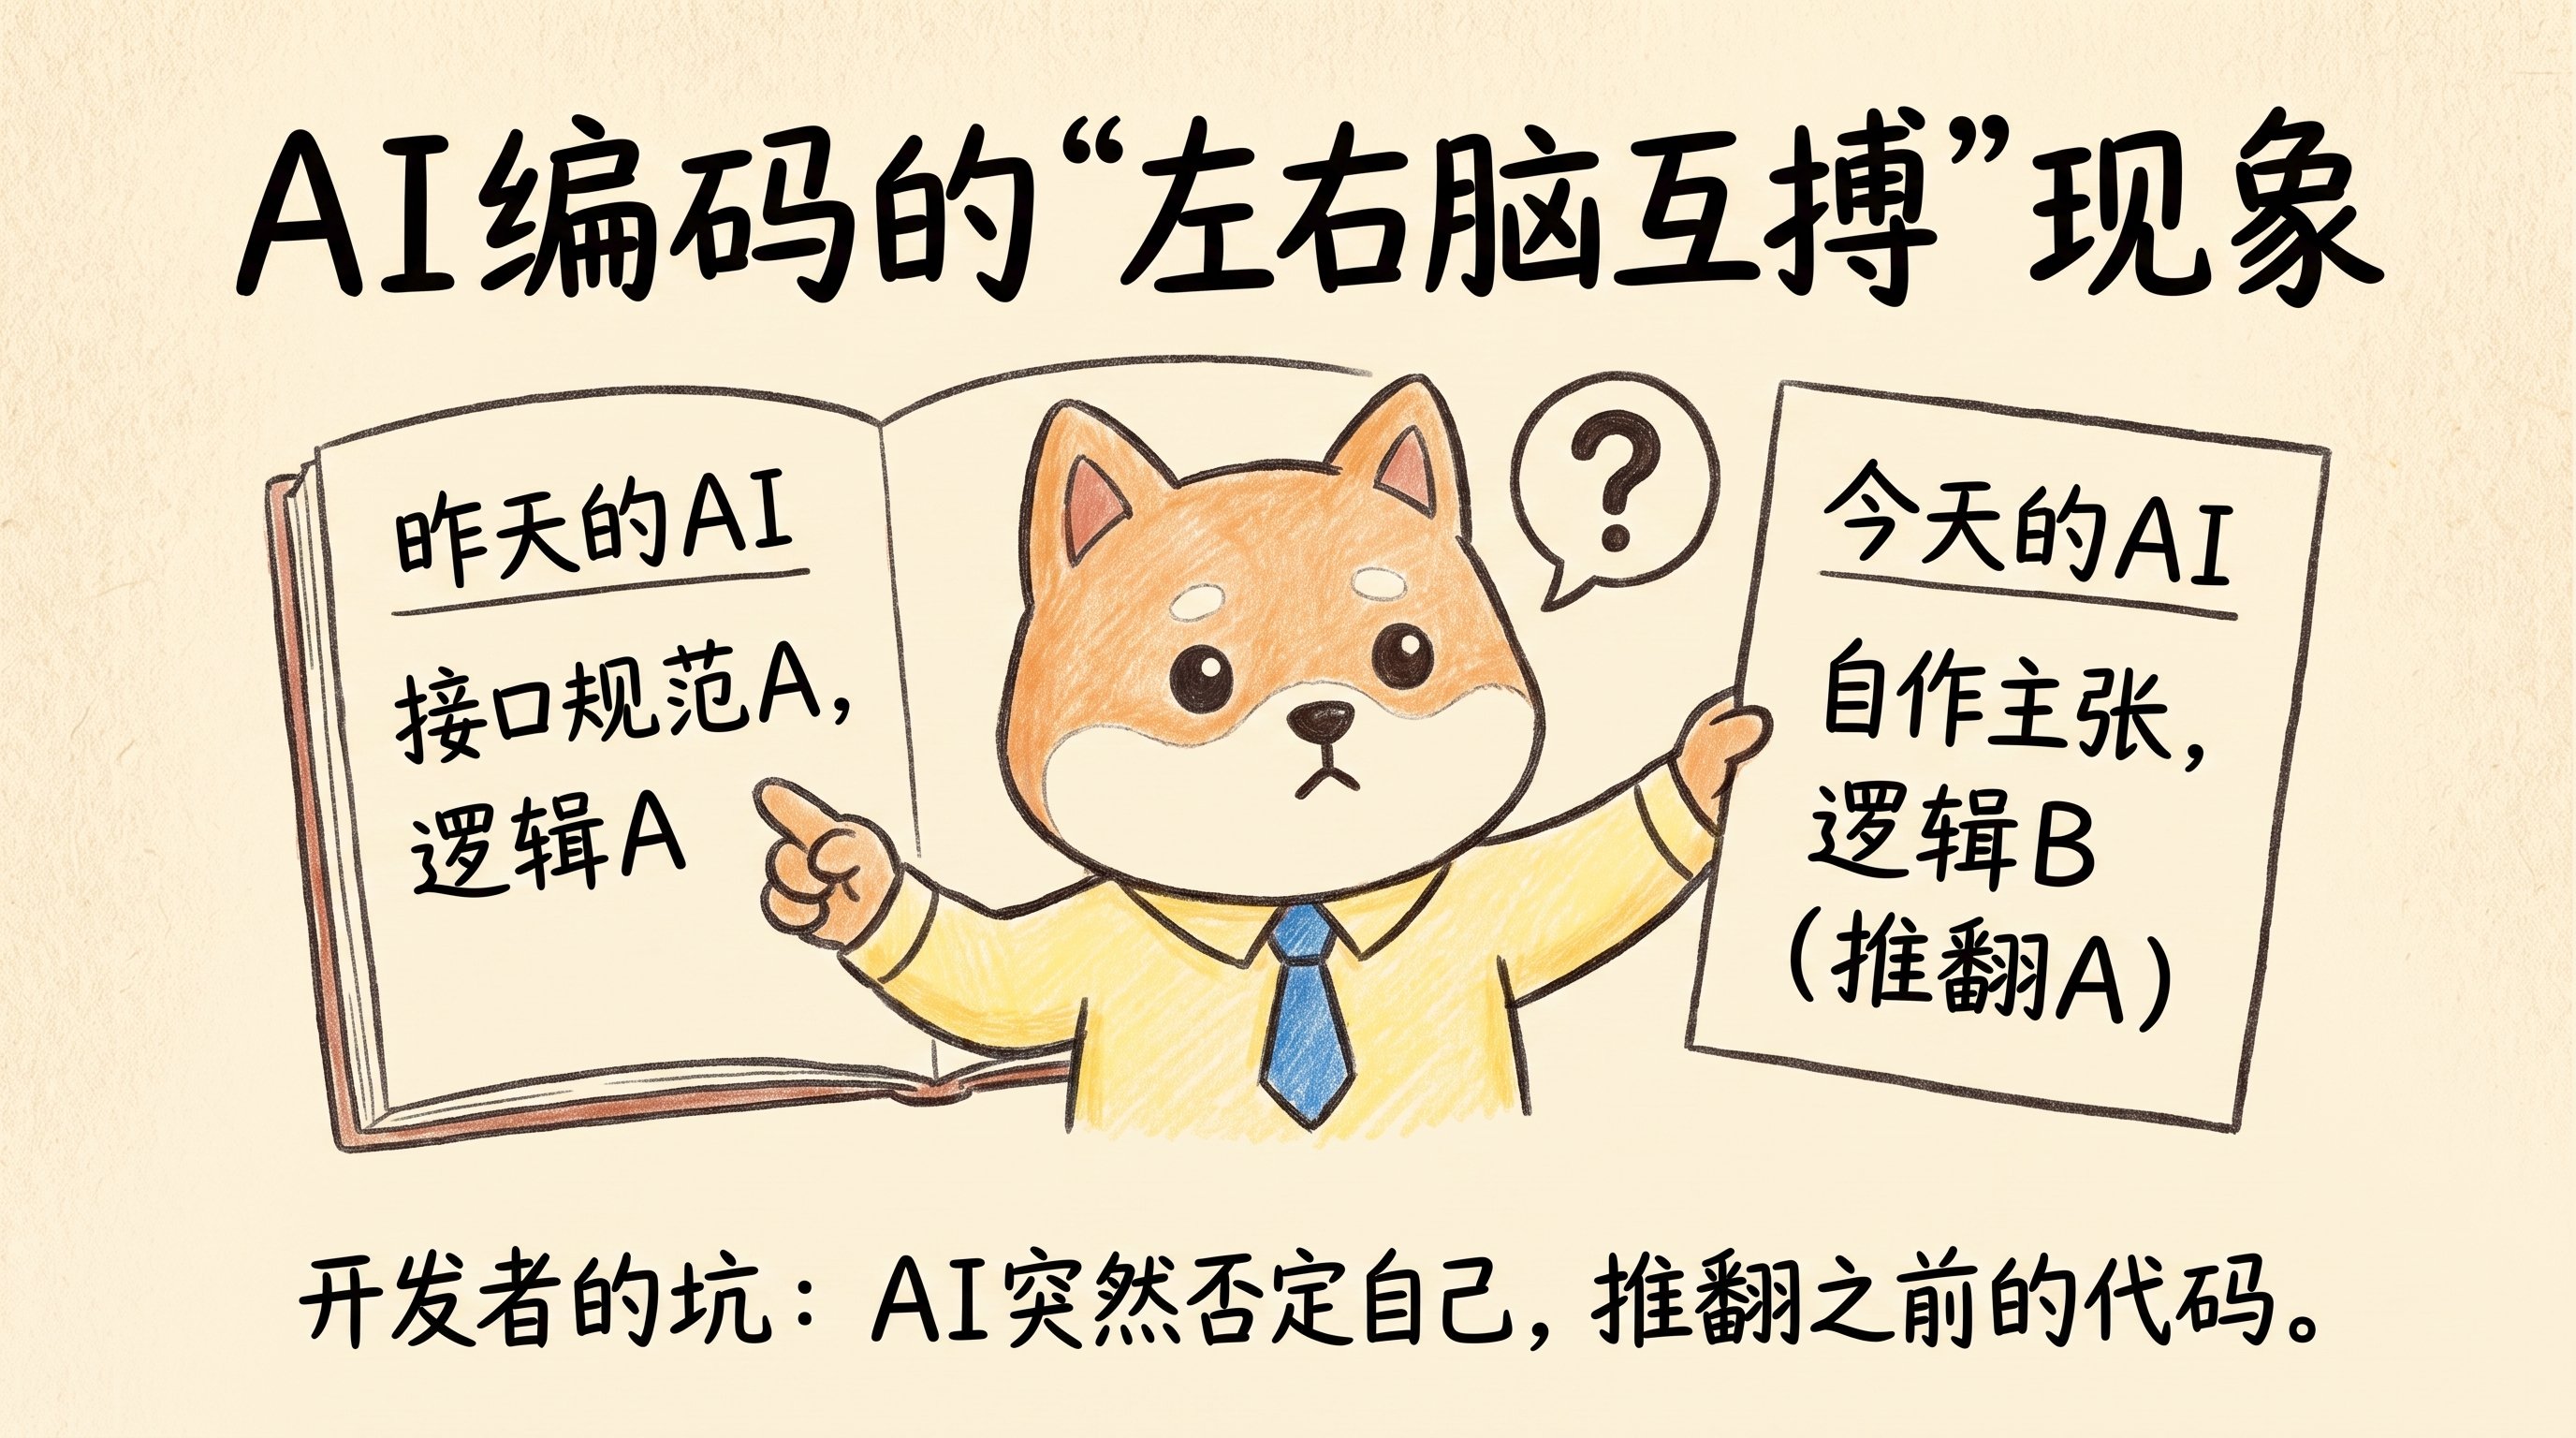 AI 编码前后冲突:今天的 AI 否定昨天的 AI
要根治 AI 编码前后冲突的问题,需要把依赖临时聊天记录的开发方式,切换为规范驱动开发(Spec-Driven Development,简称 SDD)。
一、AI 编码前后冲突的三个原因
AI 写代码容易前后冲突,主要有三个原因:
1. 上下文注意力随轮次衰减
代码实现阶段依赖前期讨论的结论,但模型注意力有限。对话越拉越长,早期关键决策越容易漏掉,写出来的代码就会跑偏。
2. 关闭窗口后历史决策丢失
每次新建会话窗口,上一轮的技术取舍就清空了。AI 拿不到当时的背景与设计意图,很容易按默认习惯乱改。
3. 缺少统一的长期编码规范
长期迭代中没有固定的代码规范文件做参照,AI 每次生成都自由发挥,项目代码风格很快就会失控。
规范驱动开发(Spec-Driven Development,简称 SDD)正是用来解决这三个问题的。
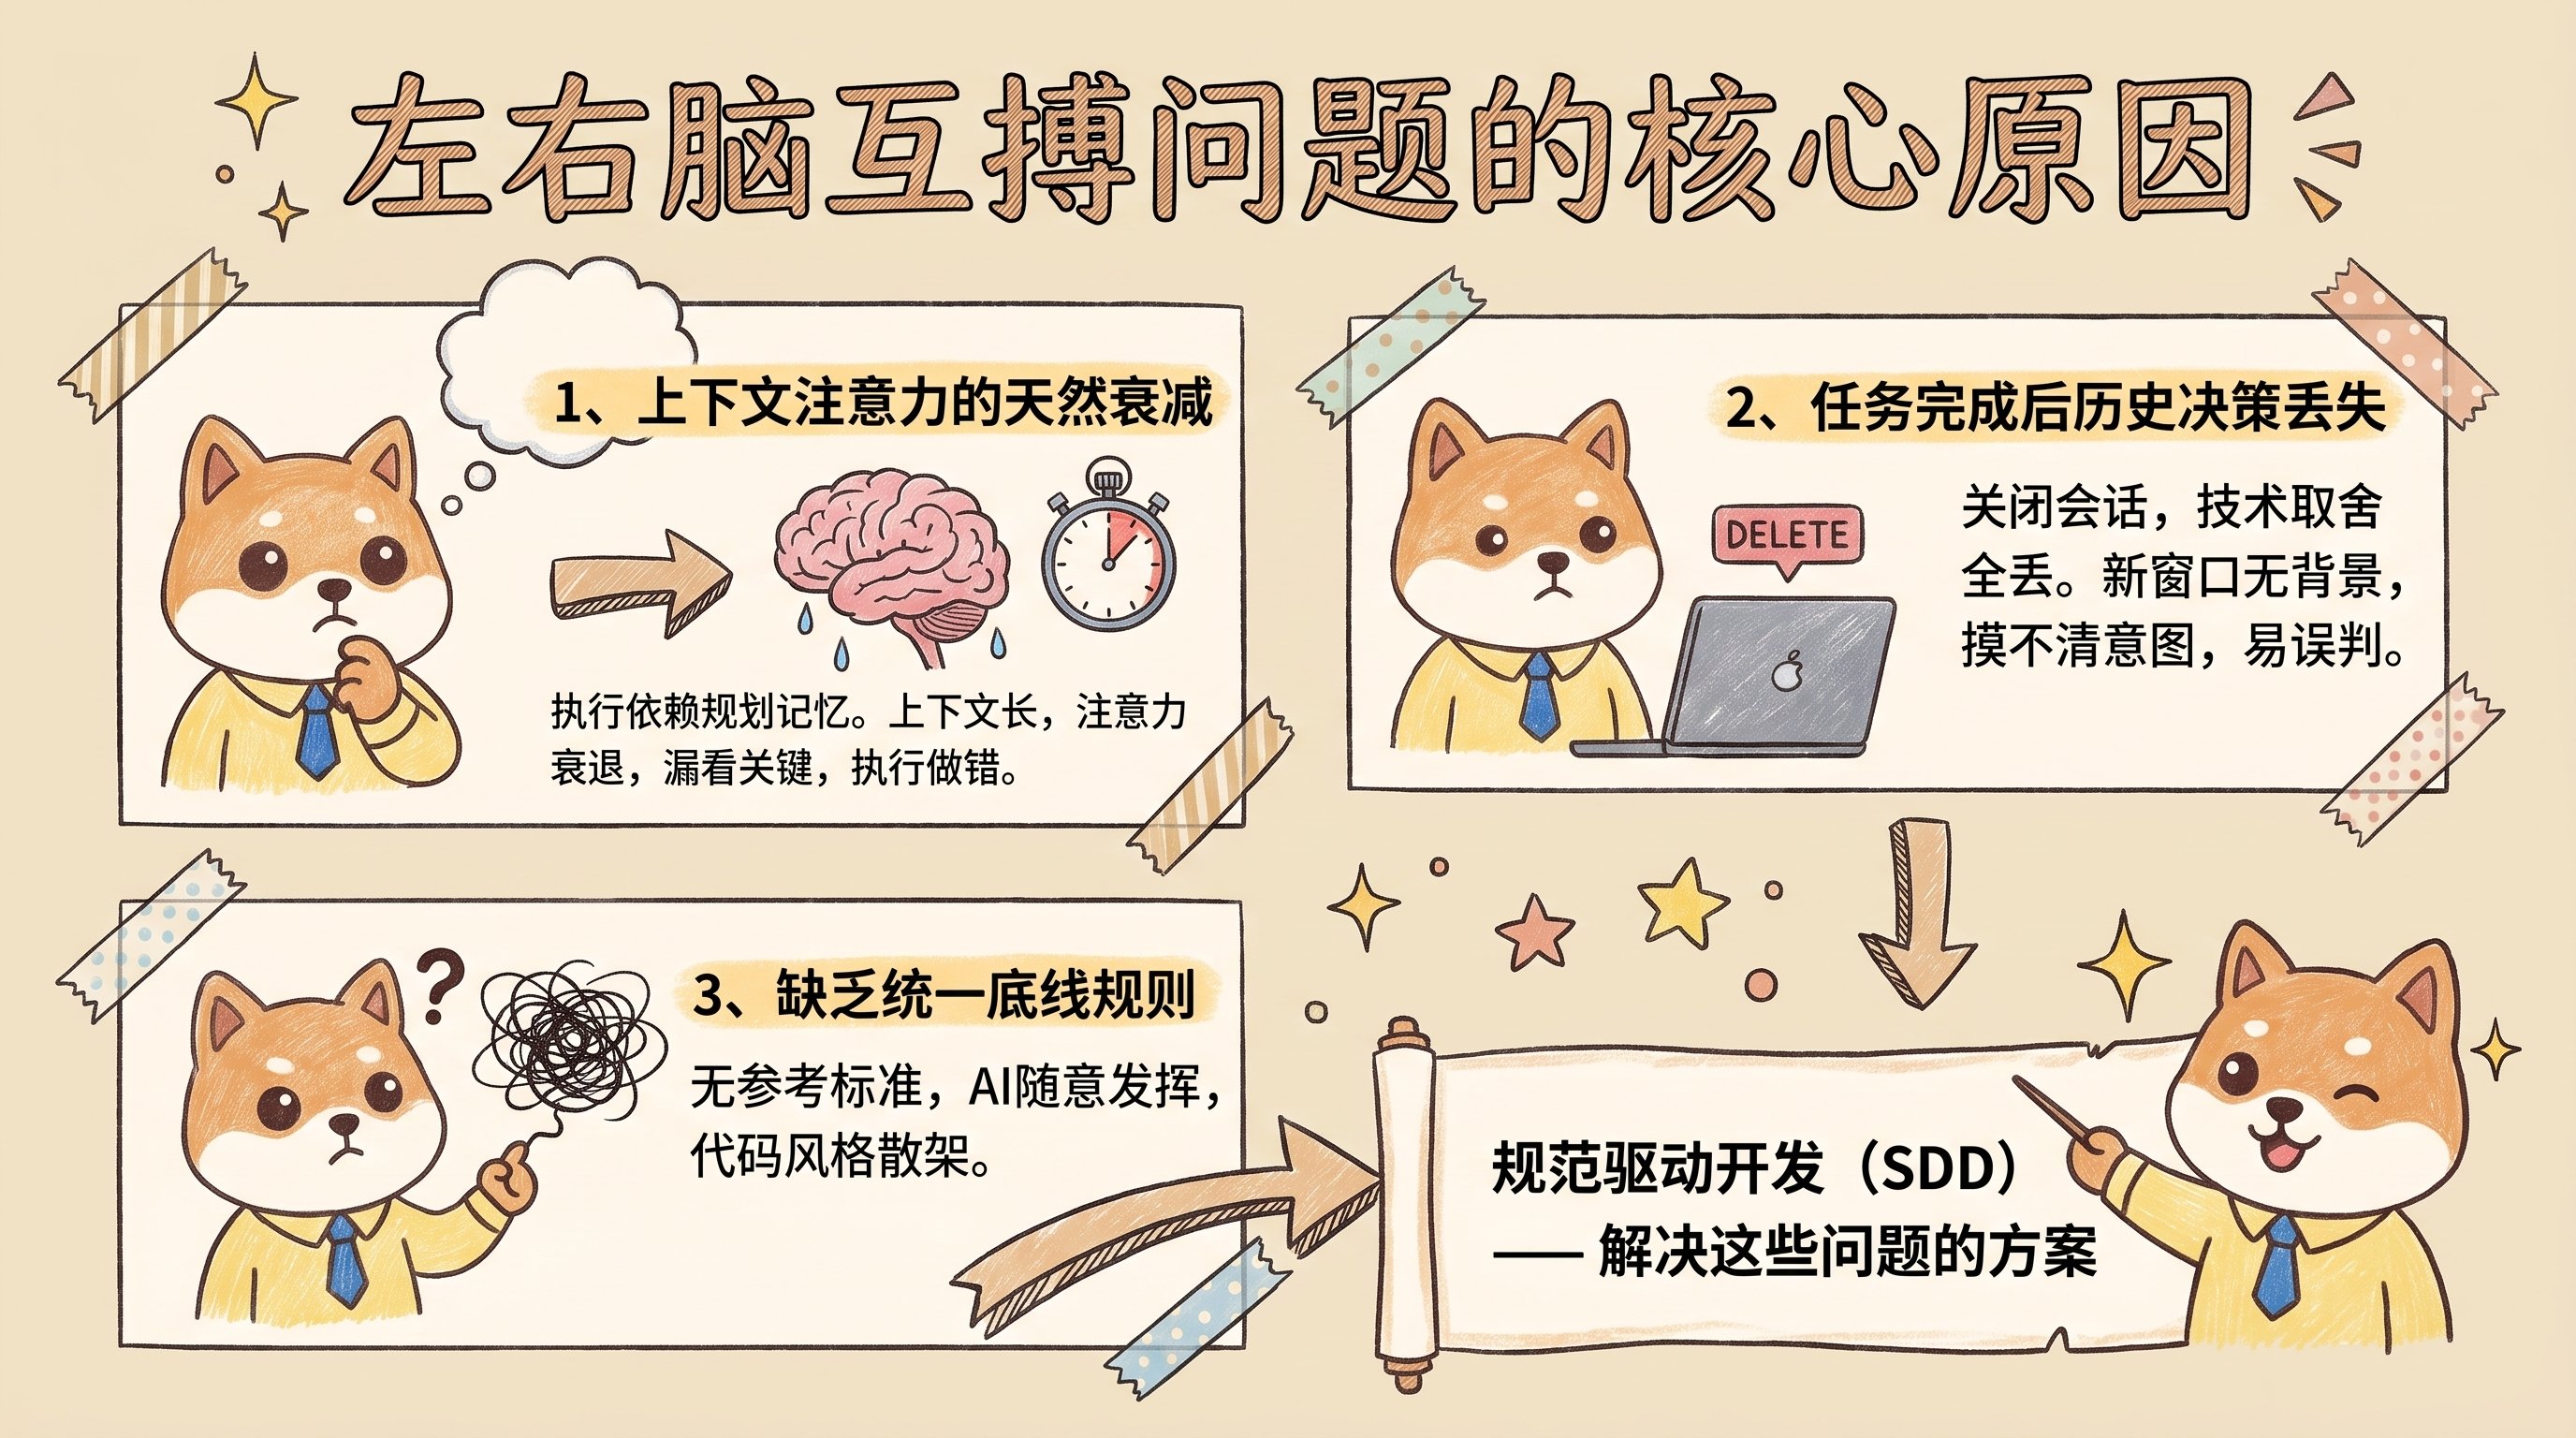 AI 编码前后冲突的三个原因
二、SDD 规范驱动开发的原理
普通 AI 编码以临时聊天记录为准,SDD 规范驱动开发以本地规范文档为准。
规范文档最终虽然也要读入模型上下文,但它和纯聊天记录有本质区别。纯聊天记录混杂了大量试错对话,聊久了很容易把关键约束冲掉;Spec 文档则是人工确认后落盘的结构化文件,就算单轮跑偏,重开窗口读取文档就能立刻拉回正轨。
SDD 把散落在海量聊天记录里的临时约定,改成了落盘保存、按需读取的白盒规范文件。
对比两种开发方式:
- 普通对话模式:每次发消息都要重复叮嘱*“用 TypeScript 写、错误用 AppError 包装、禁止写 any”*。连聊十轮后早期指令淡化,第十一轮它又开始写
any。 - SDD 模式:输入框只写业务需求*“新增一个登录接口”*,AI 自动读取项目里的
code-style.md,从第一行代码起就按规范实现。
Thoughtworks 等工程团队在 AI 研发实践中测算过:把规范前置写成文档后,返工和反复沟通的时间大幅减少,交付效率比纯对话式开发提升了 30%~50%。
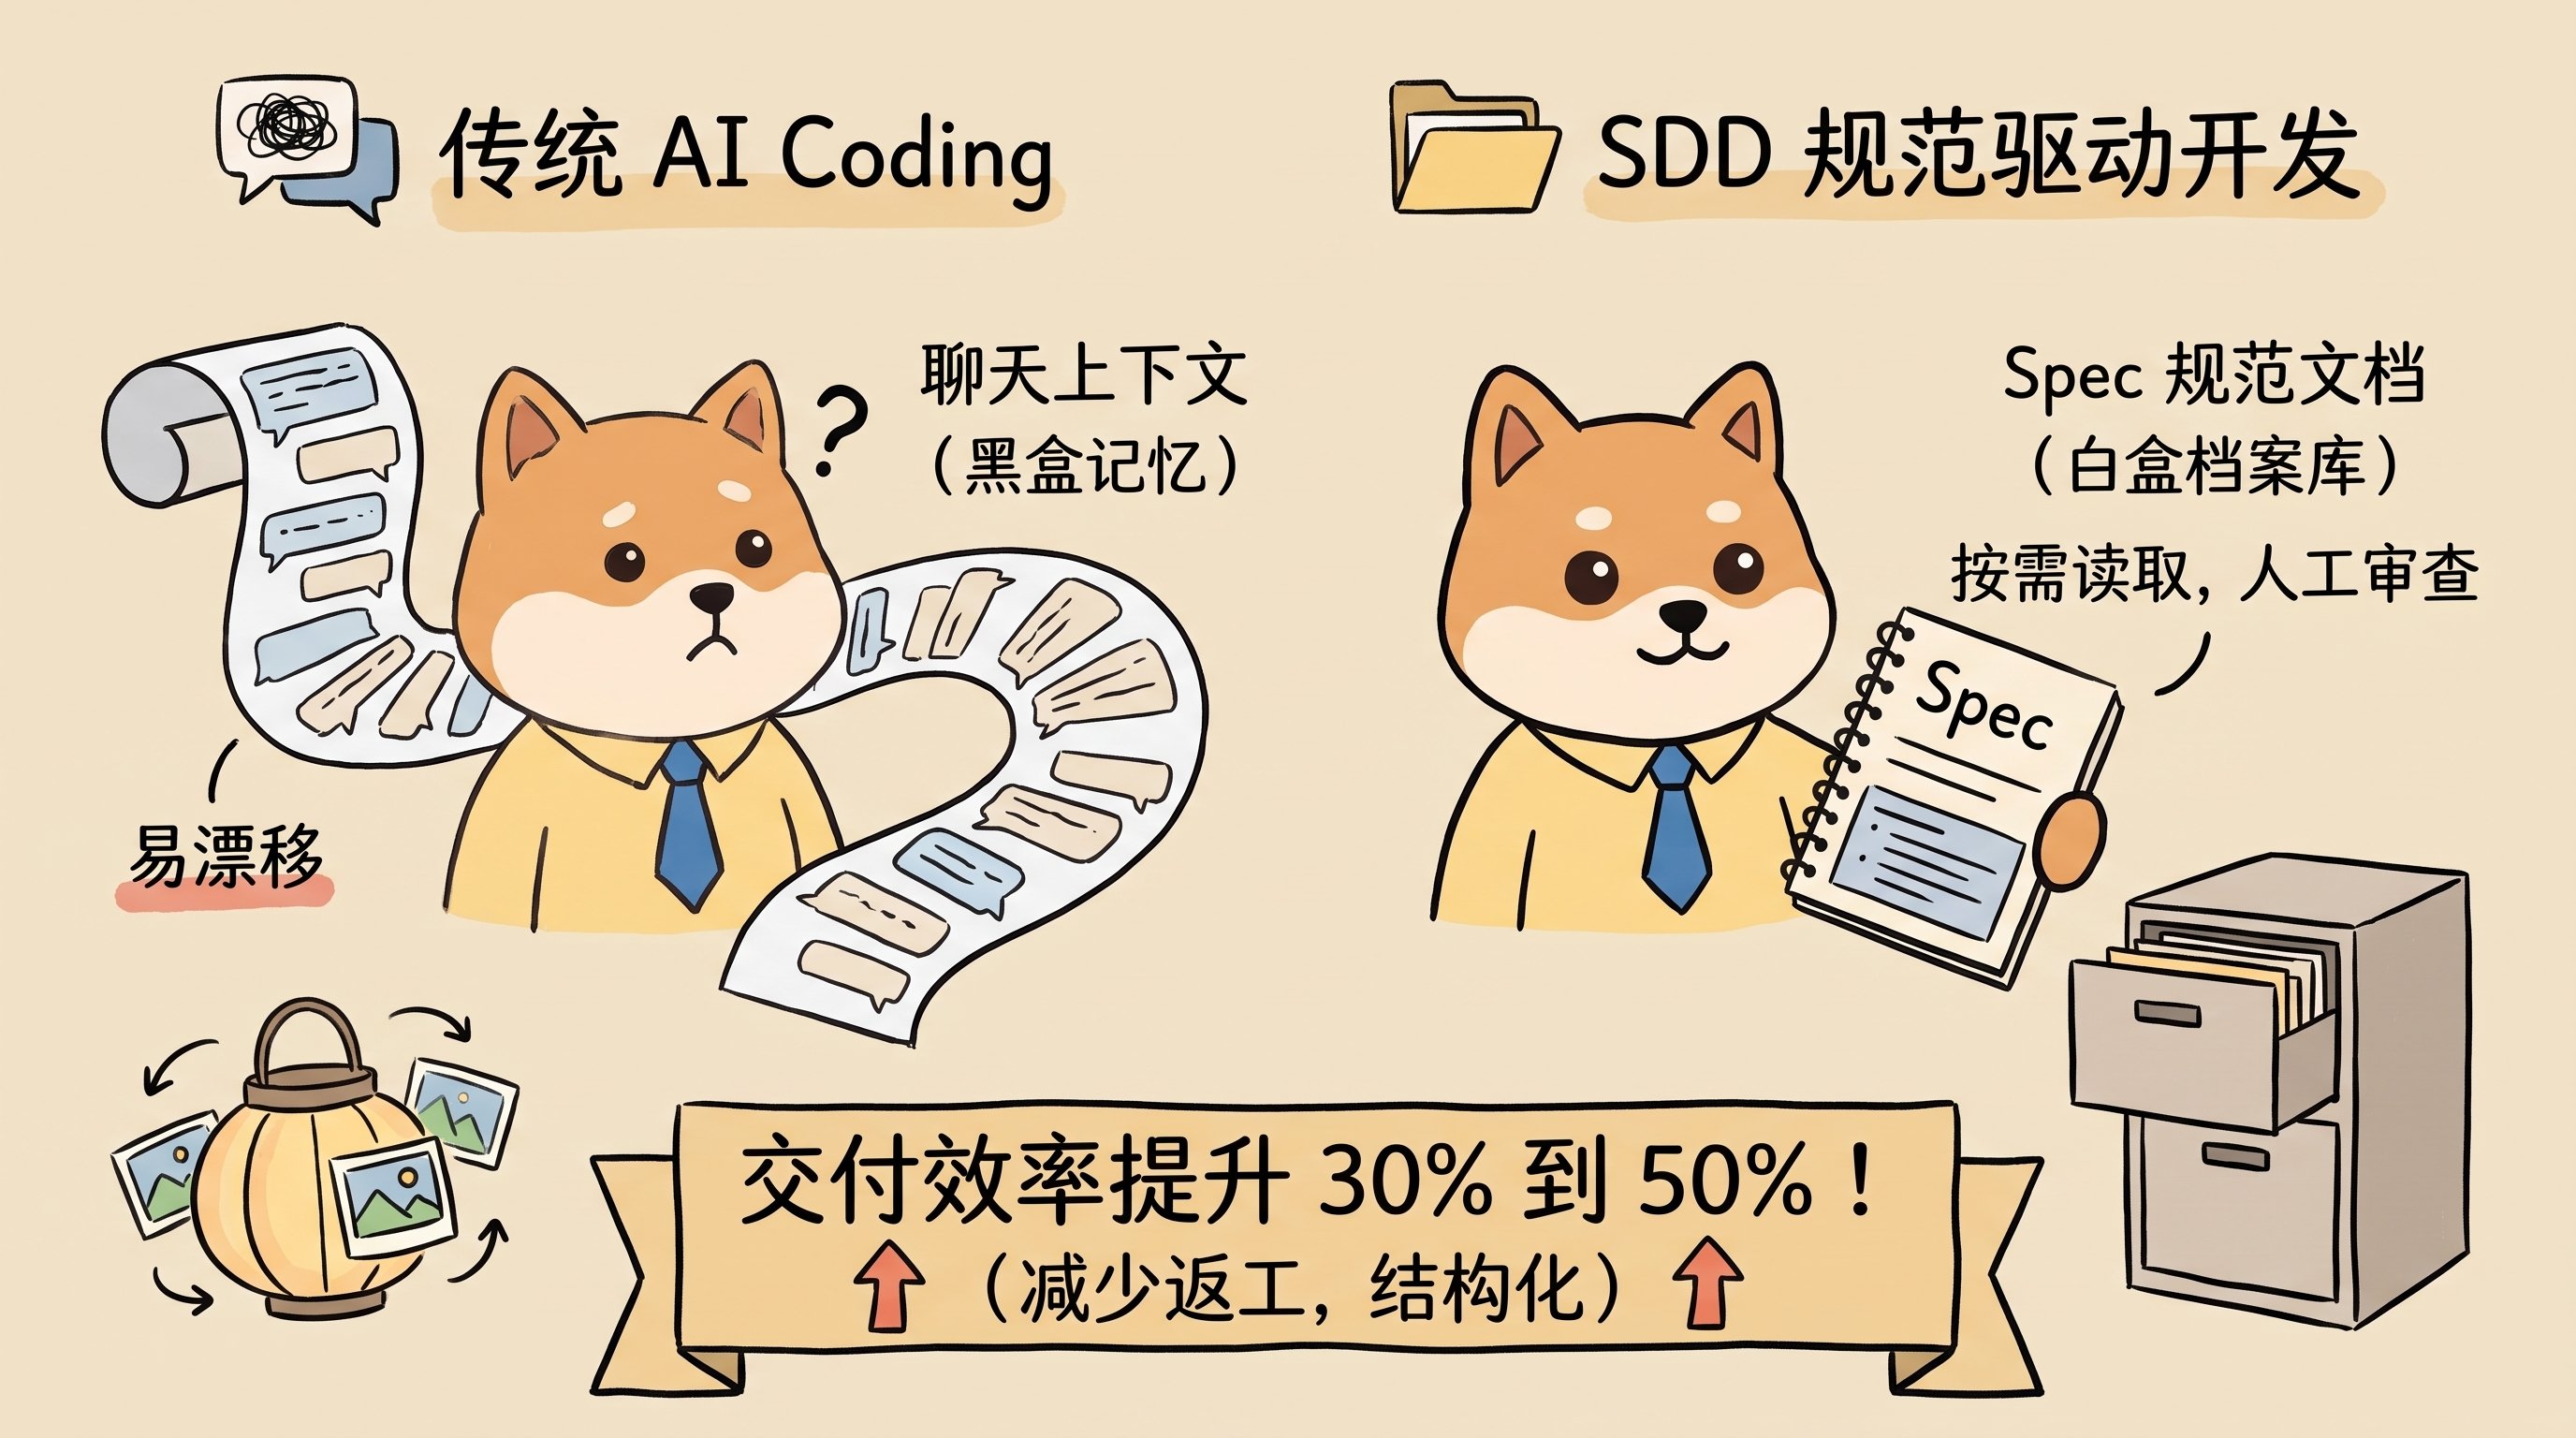 普通 AI Coding 与 SDD 规范驱动开发对比
三、SDD 四步开发流程
日常落地 SDD 只需要走完四步:
1需求澄清
先给 AI 一句话需求,让它站在产品经理角度反问:“指出这段逻辑里所有模糊或冲突的边界条件”。讨论清楚后,由 AI 整理成结构化需求文档,你只需通读确认。
2技术方案
把需求文档发给 AI,让它结合项目现有架构列出影响范围与潜在技术风险,输出技术方案与改动文件清单。
3精准编码
明确限定编码边界:“严格按上述文档执行,只允许修改清单内的文件,禁止擅自重构未提及的模块”。
4对照验收
让 AI 按照需求文档与技术文档自检,逐条核对验收项并生成交付报告。
在这套分工里,你只需把精力放在前两步的文档把关和最终验收上,具体编码与逐项自检交给 AI 对照文档完成。
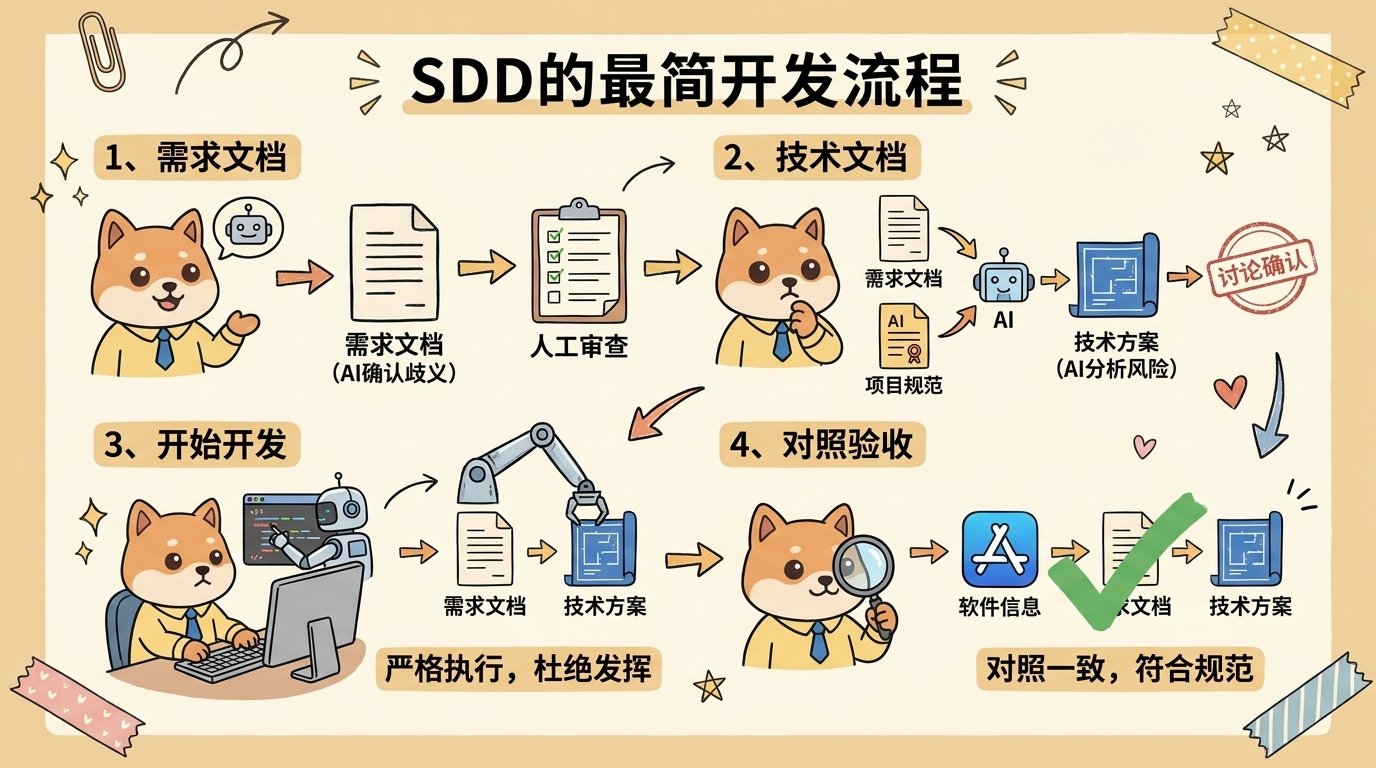 SDD 四步开发流程
四、两类 Spec 文档的划分
项目里的规范文档按生命周期分为两类:
- 事实来源(长期规范)
用来定义系统当前的真实状态与全局规则,例如代码风格、数据库表结构和路由约定。每类事实只维护唯一一份文档,长期有效,后续开发新功能都以它为准。
- 历史决策(单次迭代文档)
对应单次迭代的需求文档和技术方案,用来记录当时为什么这样设计。功能上线后即可归档,后续维护时供 Agent 查阅历史背景,避免误改旧逻辑。
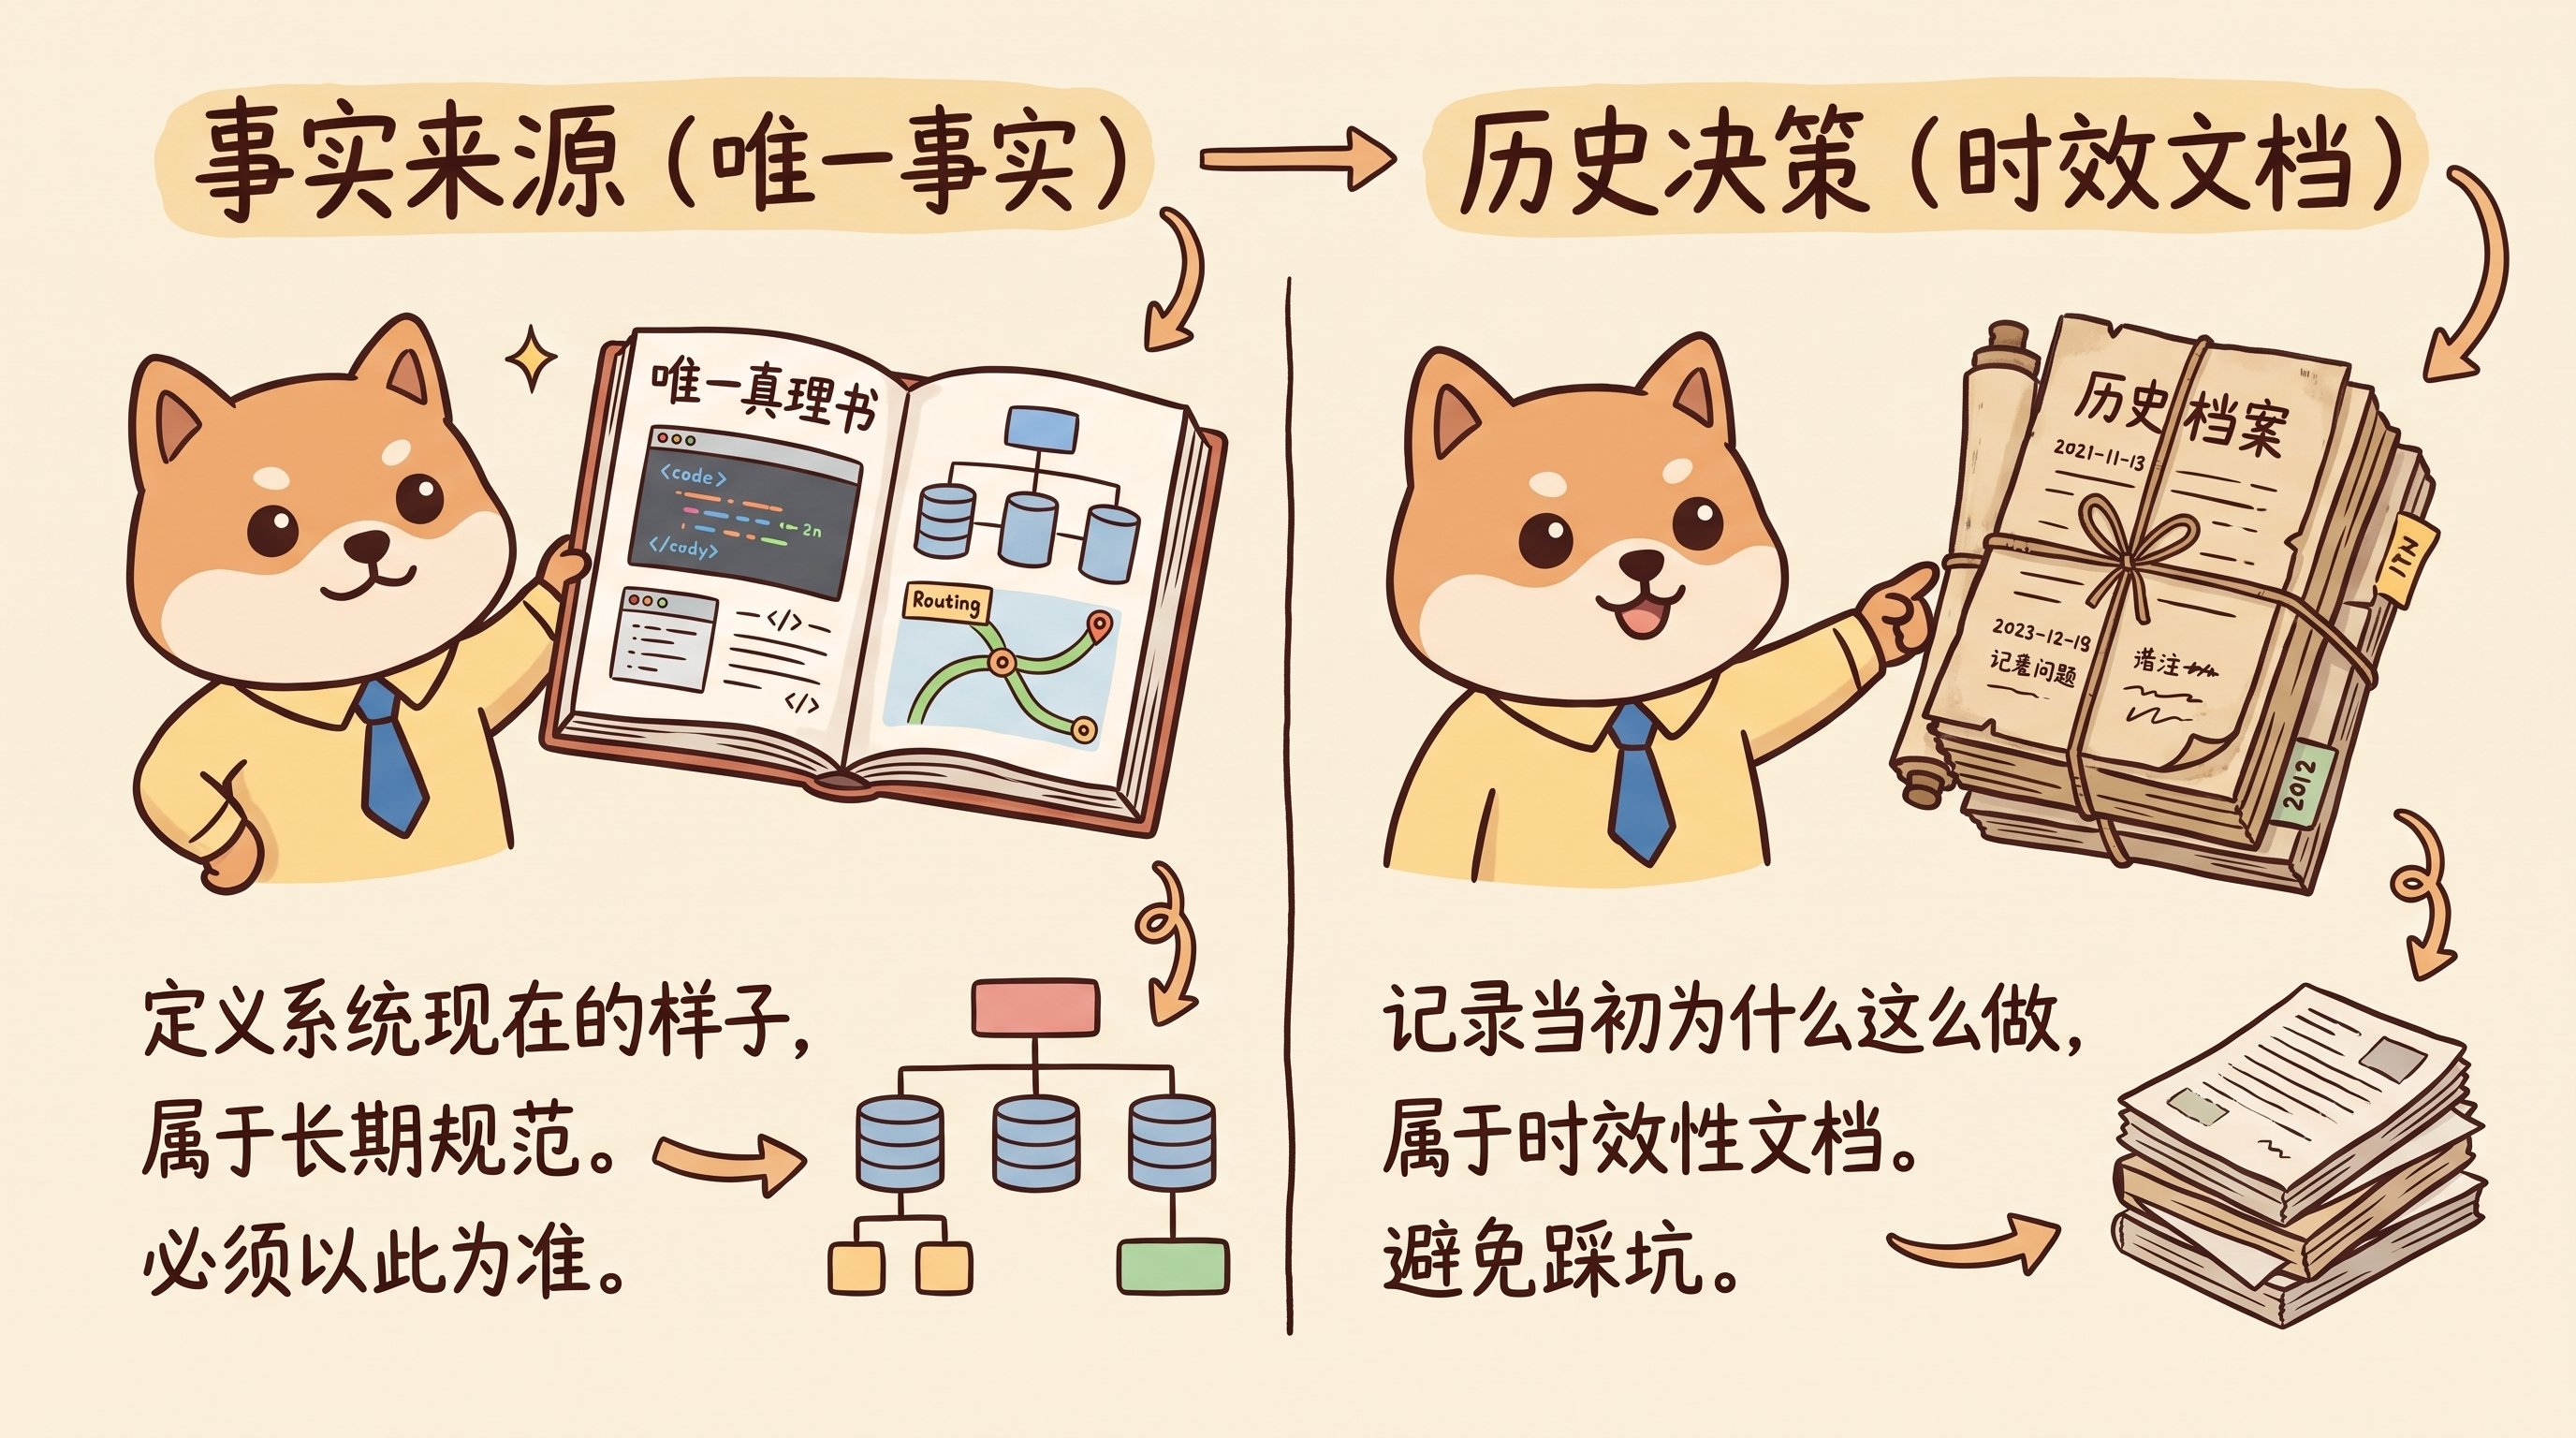 Spec 分类:事实来源与历史决策
五、用渐进式披露管理 Spec
单个会话窗口一次塞入的规则不能太多,否则模型的指令遵循率会明显下降。项目积累的规范与历史方案变多后,需要靠渐进式披露(Progressive Disclosure) 按需加载。
渐进式披露常见于各类 Agent Skill 设计:会话启动时不把所有规则全文塞进上下文,只加载一层简短的目录索引。执行具体任务时,Agent 先看索引判断需要哪份规范,再去读取对应的子文件。
SDD 目录结构同样按这个思路组织:入口规则文件只写路由索引,具体规范拆分到独立子文档中。
推荐的项目目录结构如下:
| 1 | docs/ |
| 2 | ├── specs/ # 事实来源(长期有效的全局规则) |
| 3 | │ ├── code-style.md # 代码风格与架构约束 |
| 4 | │ └── database.md # 数据库设计与现有表结构 |
| 5 | ├── requirements/ # 历史决策(按需求方案归档的时效文档) |
| 6 | │ └── 2026-03-01-auth/ # 某次具体迭代的需求方案 |
| 7 | └── technicals/ # 历史决策(按技术方案归档的时效文档) |
| 8 | └── 2026-03-01-auth/ # 某次具体迭代的技术方案 |
| 9 | AGENTS.md # 根索引:告诉 AI 什么时候该去读哪份规则 |
根目录的 AGENTS.md 只需写明触发条件与文件路径:
• 在修改数据库相关代码前,必须先完整读取
docs/specs/database.md
• 在开启新功能开发前,必须先在docs/requirements/、docs/technicals/目录下生成本次的需求和技术文档
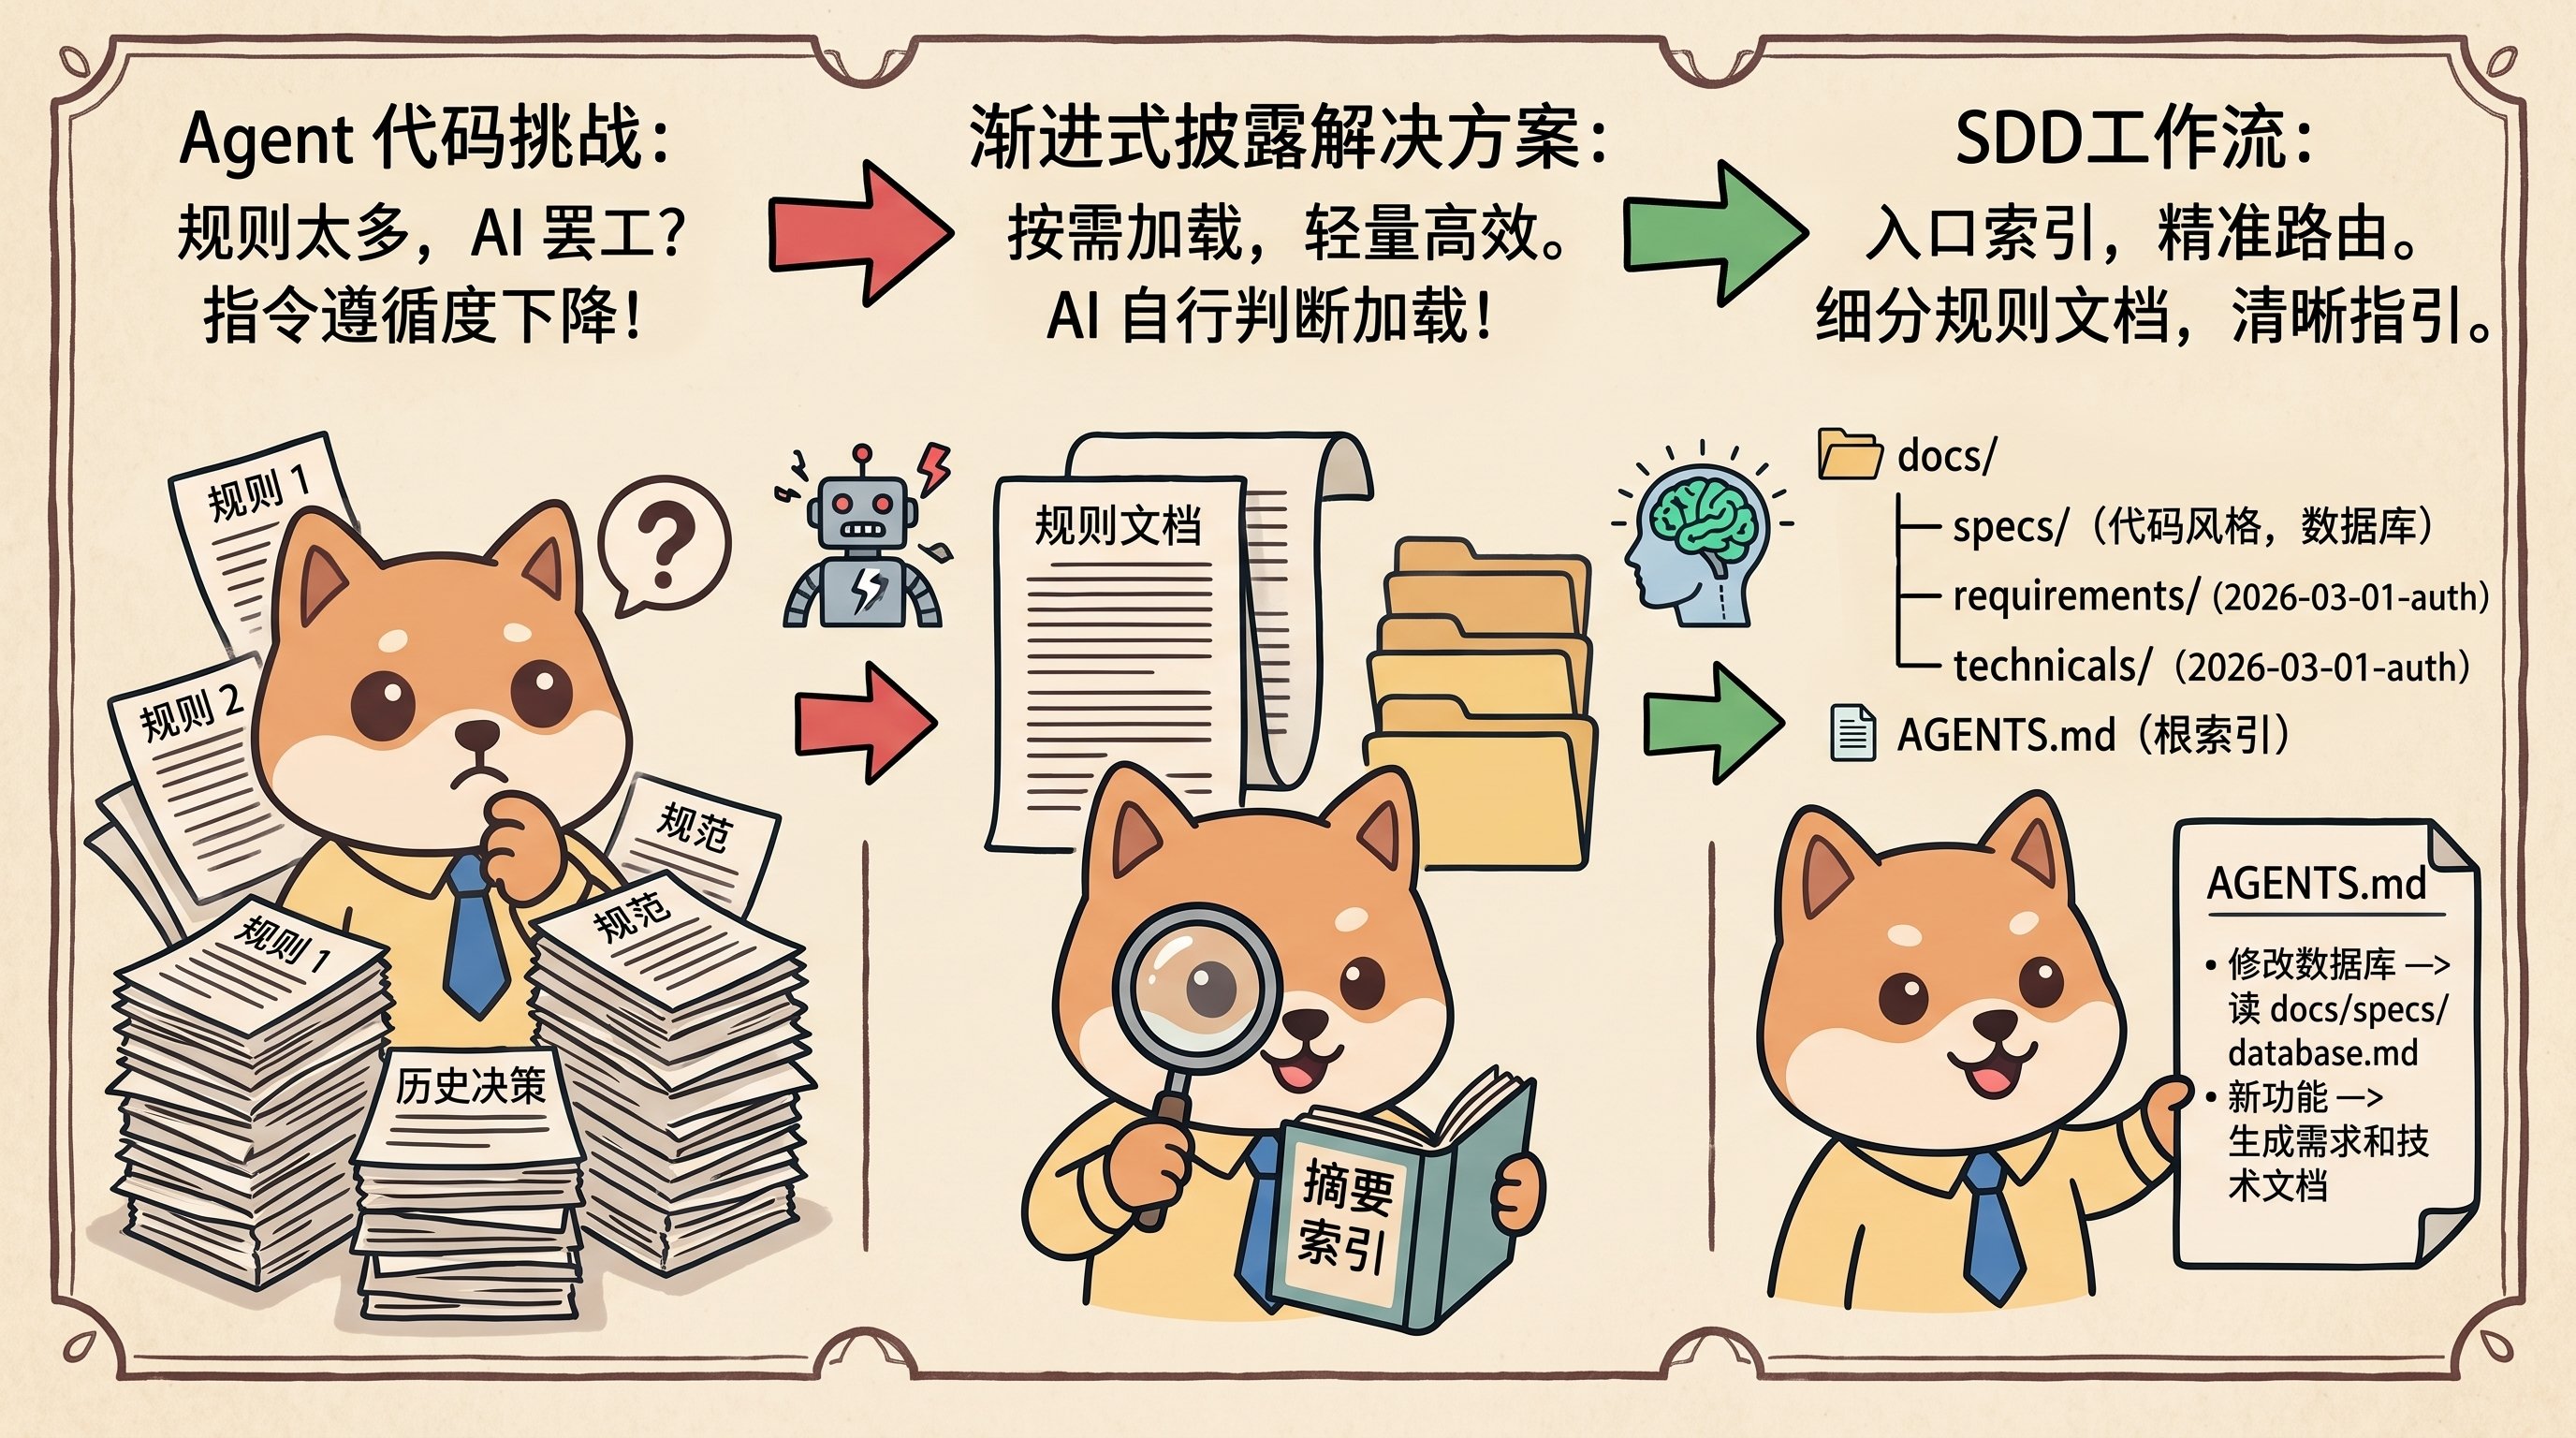 渐进式披露目录结构
根目录的 CLAUDE.md 或 AGENTS.md 会在每次新建会话时自动注入系统提示词,优先级很高。AI 准备修改代码前,会按根文件里的路由要求先读取对应的 Spec 子文档,既节省上下文空间,又能保证改到关键模块时规则准确生效。
六、开源 Spec 管理工具 agents-spec
纯靠手工维护这套目录也有麻烦:规范改名后索引路径容易失效,多份规则可能互相冲突,每次开新项目还得重搭一遍目录。
我把这套目录结构与检查脚本封装成了开源 Skill:agents-spec。
它主要包含四项功能:
1. 规范结构审计:扫描项目现有的规则文件与文档,找出散落的规则和失效索引,先输出迁移方案再执行调整。
2. 初始化标准目录:自动生成根目录 AGENTS.md,并在 docs/ 下建好 specs/(长期规范)、requirements/(需求文档)和 technicals/(技术方案)。
3. 本地与 CI 合规校验:内置零第三方依赖的 Python 校验脚本,可在本地或 CI 流水线中检查 AGENTS.md 的链接与格式完整性。
4. 多工具兼容:按通用 Agent Skills 规范编写,支持接入 Claude Code、Cursor 和 Codex。
在终端运行下面一行命令即可安装,也可以把仓库链接发给 AI 代为安装:
npx skills add https://github.com/leftzzzz/agents-spec-skill
安装完成后,直接在 Agent 对话框输入指令即可启动:
"用 agents-spec 帮我审计一下当前项目的规范索引,整理出迁移计划"
开源仓库地址:
https://github.com/leftzzzz/agents-spec-skill
七、新老项目接入建议
如果你准备新建项目,可以先在根目录建好 AGENTS.md 和 docs/specs/code-style.md,写清楚技术栈、错误处理与命名规范,再开始写业务代码。
如果已经在维护存量老项目,建议先装好 agents-spec 跑一次目录体检,把散落在各处的规则收拢归档。后续每次开发新需求,统一按“需求澄清、技术方案、限定范围编码、对照验收”四步执行即可。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。