
千问 Qwen3.8 27B 本地部署指南:量化选型与私有 API 配置
作者:Adrian Punk @AdrianPunk115(AI 工程师 / Linux 玩家)•发布日期:2026-09-01•100% GPU 本地实测
 千问 Qwen3.8 27B 本地化部署入门指南
最近拿到了一台新的 Linux 主机,装上 Ubuntu 24.04,配置是 AMD Ryzen AI MAX+ 395 处理器、Radeon 8060S 显卡和 128 GB 统一内存,适合用来测试中等规模的本地大模型。
我先装了 Qwen3.7 27B 未审查版做测试。最近 Qwen3.8 27B 发布后,我又在机器上完整跑了一遍部署流程。
 实机硬件环境与 Qwen3.8 部署
把大模型部署到本地,主要有五个实际用途:
- 隐私可控:私人文档和内部代码留在本地硬盘,无需上传第三方服务器。
- 离线可用:模型权重下载完成后,断开外网也能正常问答。
- 调用不限次:不受网页版每小时提问次数限制,适合批量跑测试。
- 本地接口集成:本地 HTTP API 可直接接入 Python 脚本、本地知识库(RAG)与 Agent 工作流。
- 摸清硬件上限:实测一遍就能确认本机内存和显卡能跑多大规模的模型。
下面记录完整的安装与验证步骤。你不需要提前掌握命令行基础,每一步都会写明参数含义、执行命令和验收标准。
跑通环境后只需一条命令,就能在 Windows 或 Linux 电脑上启动千问 Qwen3.8 27B。模型下载体积约 13 GB,支持断网对话,本地文件无需上传云端。
下文提供 Windows 和 Linux 两种安装路径:Windows 使用图形安装包,Linux 使用官方安装脚本。从拉取模型开始,两个系统使用同一条命令。
Linux 实机测试环境参数
• 系统:Ubuntu 24.04.4 LTS
• 处理器:AMD Ryzen AI MAX+ 395
• 显卡:Radeon 8060S
• 内存:128 GB 统一内存(Unified Memory)
• 运行工具:Ollama 0.33.1
• 模型:Julioa/Qwen3.8-27B-UD-Q3_K_XL
最终要运行的核心命令只有这一条:
ollama run Julioa/Qwen3.8-27B-UD-Q3_K_XL
运行命令前先核对硬件条件。27B 模型体积远大于普通软件,“能启动”和“生成流畅”对内存与显卡的要求不同。第 1 章的概念说明两个系统通用;从第 2 章开始,按 Windows 或 Linux 对应步骤操作即可。
第 1 章 部署前先认清核心概念
初次接触本地部署,常会遇到一串缩写词:Linux、Ollama、27B、GGUF、Q3、ROCm。
先把前文那条运行命令拆开看:
让 Ollama 下载 Julioa 打包的 千问 Qwen3.8 27B 量化模型,并在本机启动对话。
1.1 什么是本地部署
使用网页版 AI 时,你的问题通过网络发往云端服务器,计算完成后再传回浏览器。本地部署则是把模型权重下载到本机硬盘,直接调用本机的 CPU、GPU 和内存完成推理。
本地运行有三个直接特点:
- 模型下载完成后,断网也能继续运行。
- 日常对话和本地文档无需上传到第三方服务器。
- 没有按量计费,但生成速度、功耗和模型上限取决于本机硬件。
云端 API 像打网约车,省心但按次计费;本地部署像自己买车,数据留在手里,但要自己准备硬件空间和算力。
 千问 Qwen3.8 27B 概念命名解析
1.2 千问、Qwen3.8 和 27B 分别代表什么
- 千问(Qwen):阿里开源大模型的系列名称。
- Qwen3.8:本次部署的模型代数与版本号。
- 27B:代表约 270 亿个参数(B 即 Billion,十亿)。参数量越大,模型的表达与推理上限通常越高,运行占用的显存与内存也随之增加。
如果把 8B 模型比作随身登机箱,27B 模型就接近大号托运行李箱,启动前需要先确认内存空间够用。
1.3 Ollama 是什么
模型权重本身只是静态文件,无法直接打开聊天窗口。Ollama 主要承担三项工作:
- 下载和管理模型权重文件。
- 把模型加载进系统内存或显卡显存。
- 提供终端对话界面和本地 HTTP API,方便外部软件调用。
你可以把 Ollama 看作本地大模型的管理器与运行引擎。
1.4 Q3_K_XL 是什么
未压缩的 27B 原始权重需要 50 GB 以上的显存。为了让消费级电脑装得下,社区会对模型做量化(Quantization)。
量化类似于有损压缩图片:降低每个权重参数占用的浮点位数,在保留主要推理能力的同时,大幅缩减文件体积和显存占用。
名称中的 Q3 代表约 3-bit 量化精度,K 代表分块混合量化策略,XL 是打包者标记的混合精度档位。在 128 GB 统一内存机器上,这个版本实测占用约 29 GB 内存,全部权重层都能放进 GPU 运行。
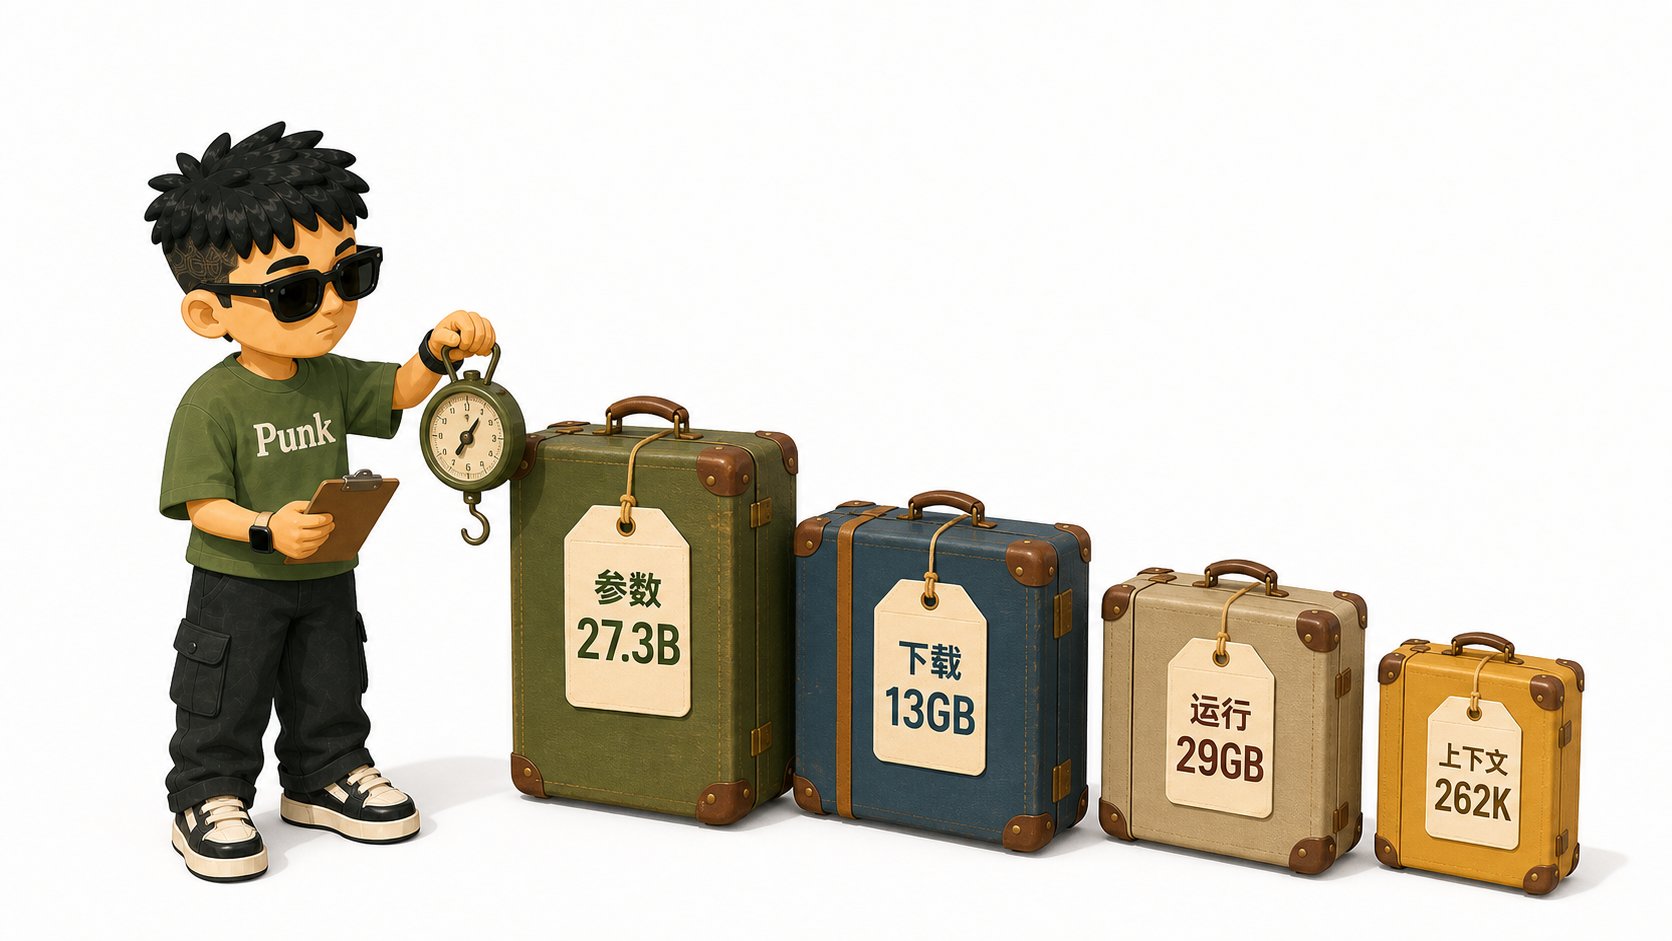 四个核心容量:27.3B / 13 GB / 29 GB / 262K
1.5 四个关键容量指标
模型规模27.3B约 273 亿参数
下载体积13 GB首次运行下载量
实测运行内存29 GB权重 + KV Cache
最大上下文262K262,144 token
Token 是模型切分文本的最小词元单位,1 个汉字通常占 1~2 个 Token。上下文长度(Context Length) 指单次会话能容纳的总词元数,涵盖当前提问、历史记录与附加文档。上下文窗口开得越大,KV Cache 占用的显存或内存就越多。
第 2 章 安装前检查硬件与系统环境
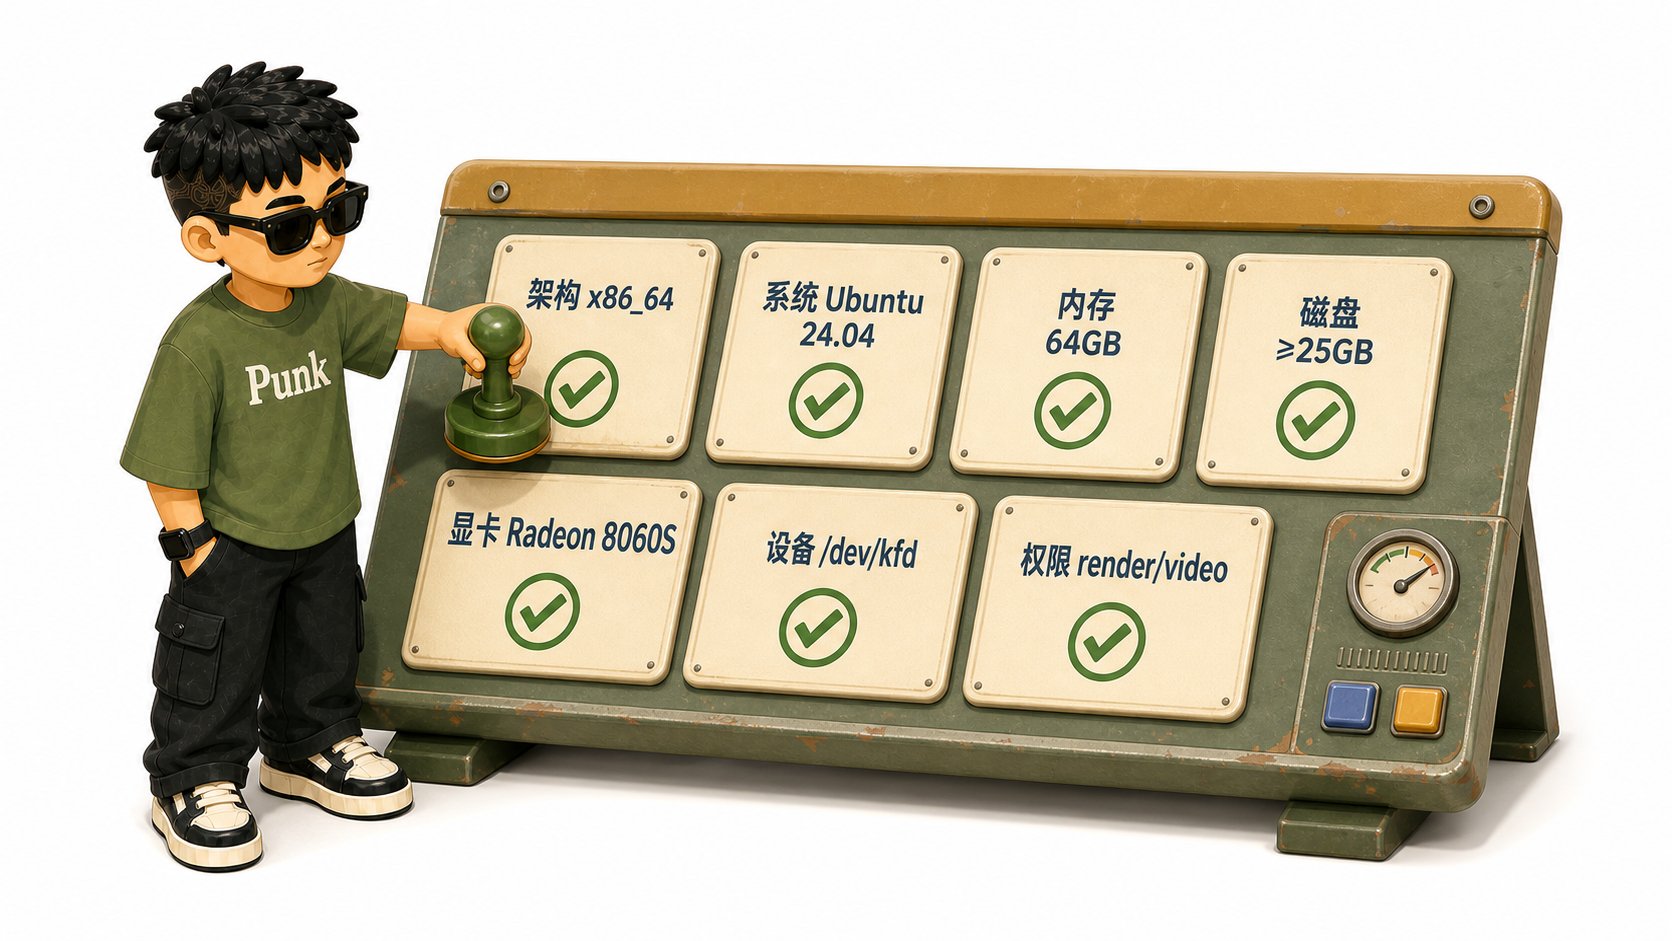
下载 13 GB 模型前,先花两分钟核对磁盘、内存和显卡状态。
2.1 Windows 和 Linux 通用的三项检查
- 内存或显存容量:独立显卡优先占用显存;AMD Ryzen AI MAX+ 395 这类平台采用统一内存架构,CPU 与集成显卡共享系统内存。本文演示的 27B 量化版运行占用约 29 GB:64 GB 内存空间充裕;32 GB 内存余量紧张,启动时不要拉满 262K 上下文。
- 磁盘剩余空间:模型下载体积约 13 GB,算上临时缓存,目标磁盘至少要留出 25 GB 空闲空间;如果后续还要测试多个模型,建议预留 100 GB 以上。
- GPU 加速支持:纯 CPU 推理也能出字,但生成速度往往只有 1~2 token/s。配好驱动后,Ollama 可以直接调用 NVIDIA(CUDA)或 AMD(ROCm)显卡加速。
 Linux 安装前环境检查命令
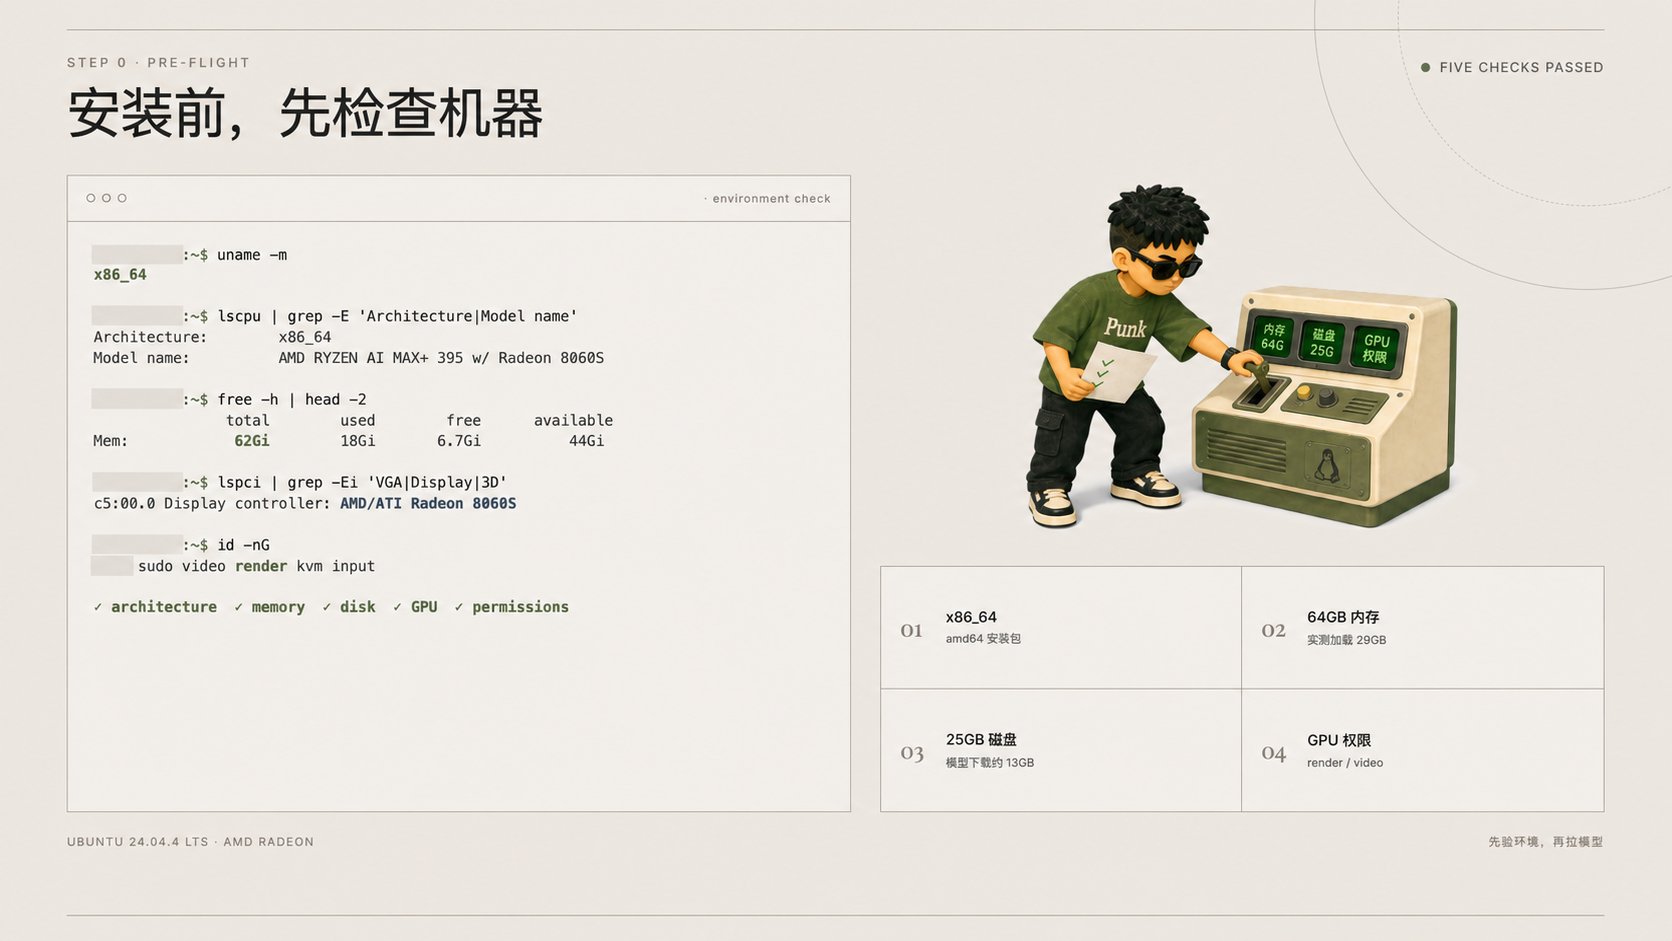 GPU 权限组 render 与 video 设置
第 3 章 安装 Ollama 运行环境
3.1 Linux(Ubuntu)安装步骤
在 Ubuntu 终端运行官方安装脚本:
| 1 | curl -fsSL https://ollama.com/install.sh | sh |
安装完成后,运行 sudo systemctl status ollama --no-pager 检查后台服务状态。终端输出包含 Active: active (running) 即表示服务已正常启动。
3.2 Windows(PowerShell)安装步骤
- 打开 Ollama Windows 官方下载页:https://ollama.com/download/windows
- 下载
OllamaSetup.exe,双击完成安装。 - 如果 C 盘剩余空间不足,可在“系统环境变量”中新建用户变量
OLLAMA_MODELS,将路径指向其他磁盘(如D:\OllamaModels)。 - 在 PowerShell 中验证安装版本:
ollama --version。
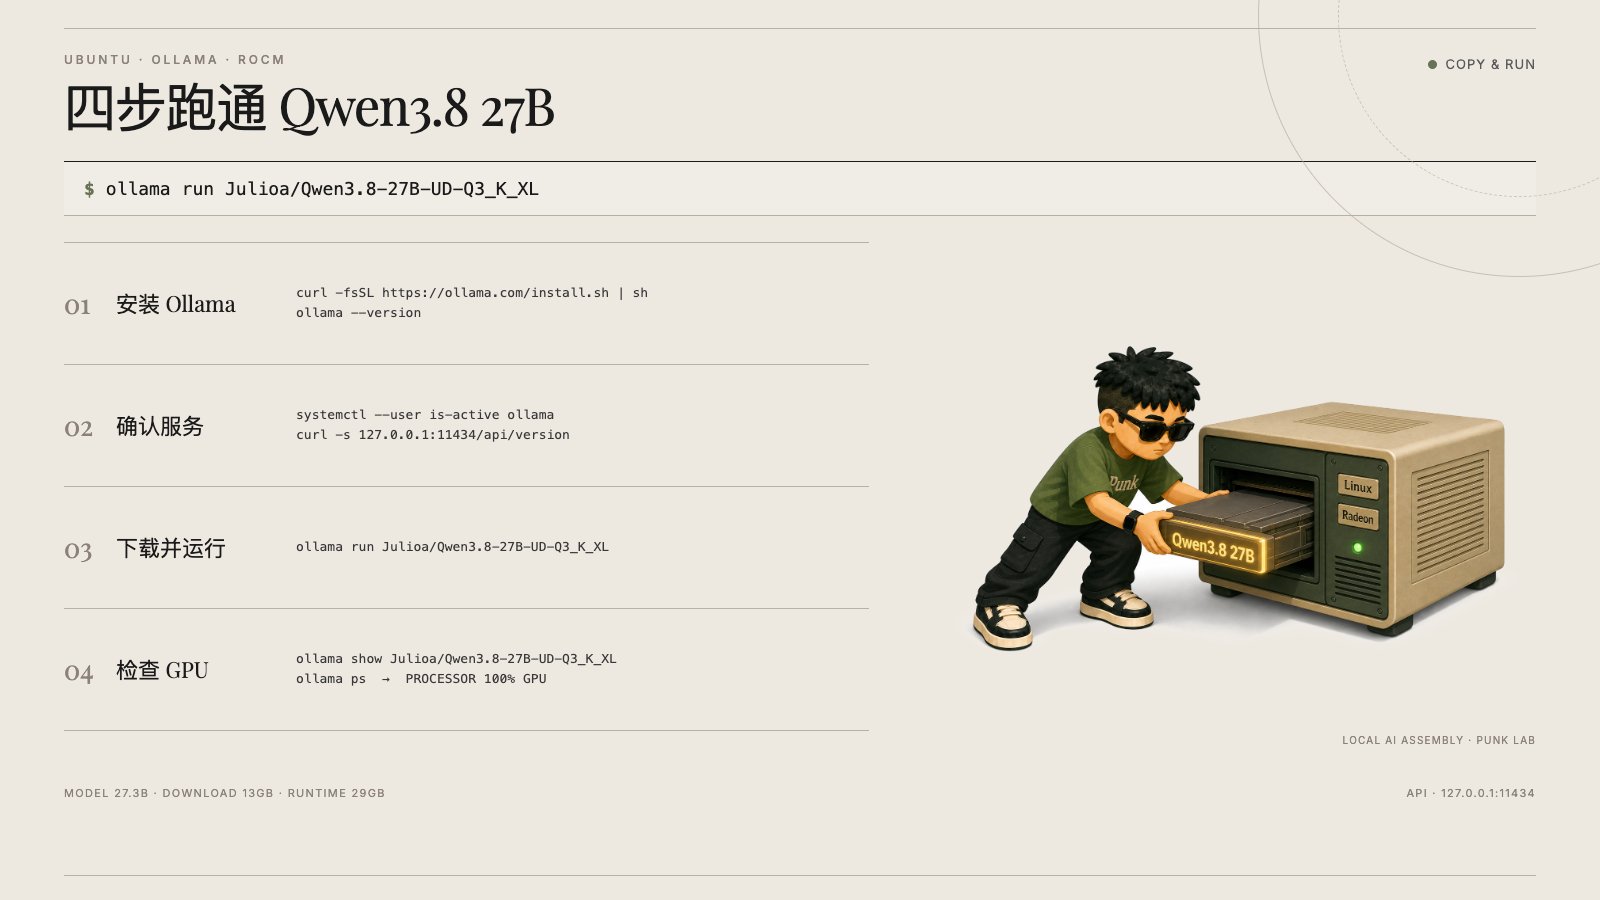 Ollama 安装与版本验证
第 4 章 拉取模型并完成首次对话
从这一步开始,Windows 和 Linux 执行同一条命令:
| 1 | ollama run Julioa/Qwen3.8-27B-UD-Q3_K_XL |
命令各字段含义:
ollama run:拉取并启动指定模型Julioa/:模型打包者的仓库命名空间Qwen3.8-27B:千问 3.8 系列,约 270 亿参数UD-Q3_K_XL:未审查变体(Uncensored)与动态 3-bit 量化档位
首次运行会自动下载约 13 GB 权重文件,支持断点续传。下载完成后终端会直接进入交互提示符,输入测试语句:
请只回复一句:千问 Qwen3.8 27B 已在这台电脑本地运行。
收到中文回复即表示模型已在本地正常推理。输入 /bye 可退出当前对话。
第 5 章 验证 GPU 加速状态
能输出文字只说明模型跑起来了。纯 CPU 推理速度通常只有 1~2 token/s,接下来需要确认模型权重是否已全部加载到 GPU 上。
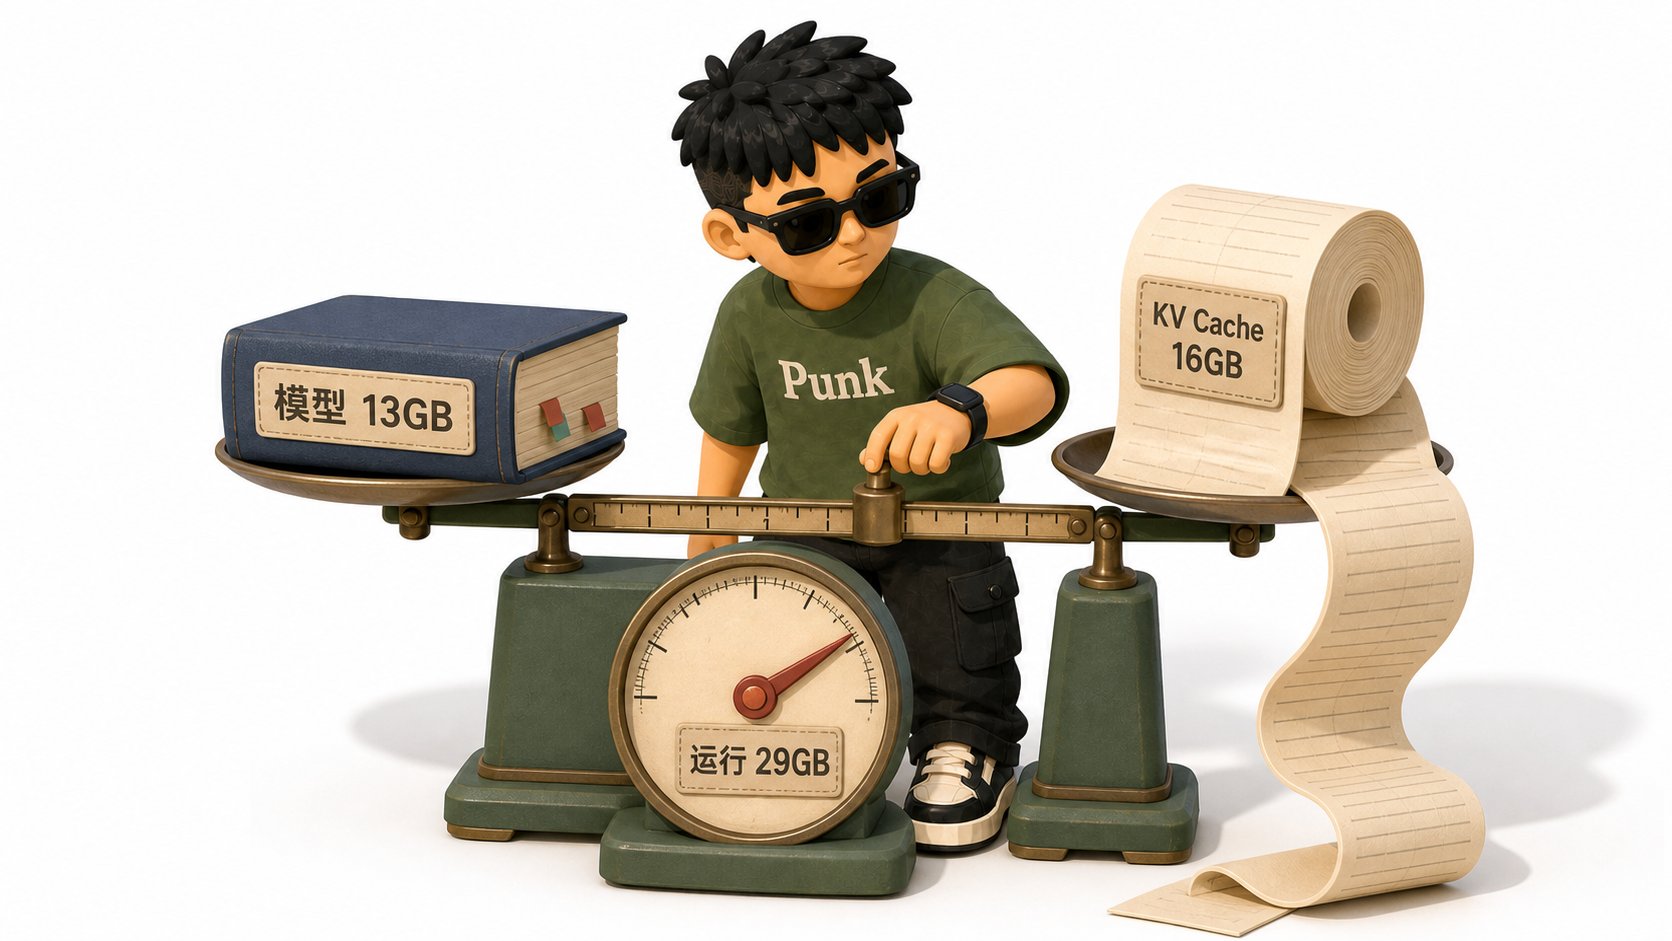 KV Cache 与 29 GB 内存实测占用
保持对话窗口不关闭,另开一个终端或 PowerShell 窗口执行:
| 1 | ollama ps |
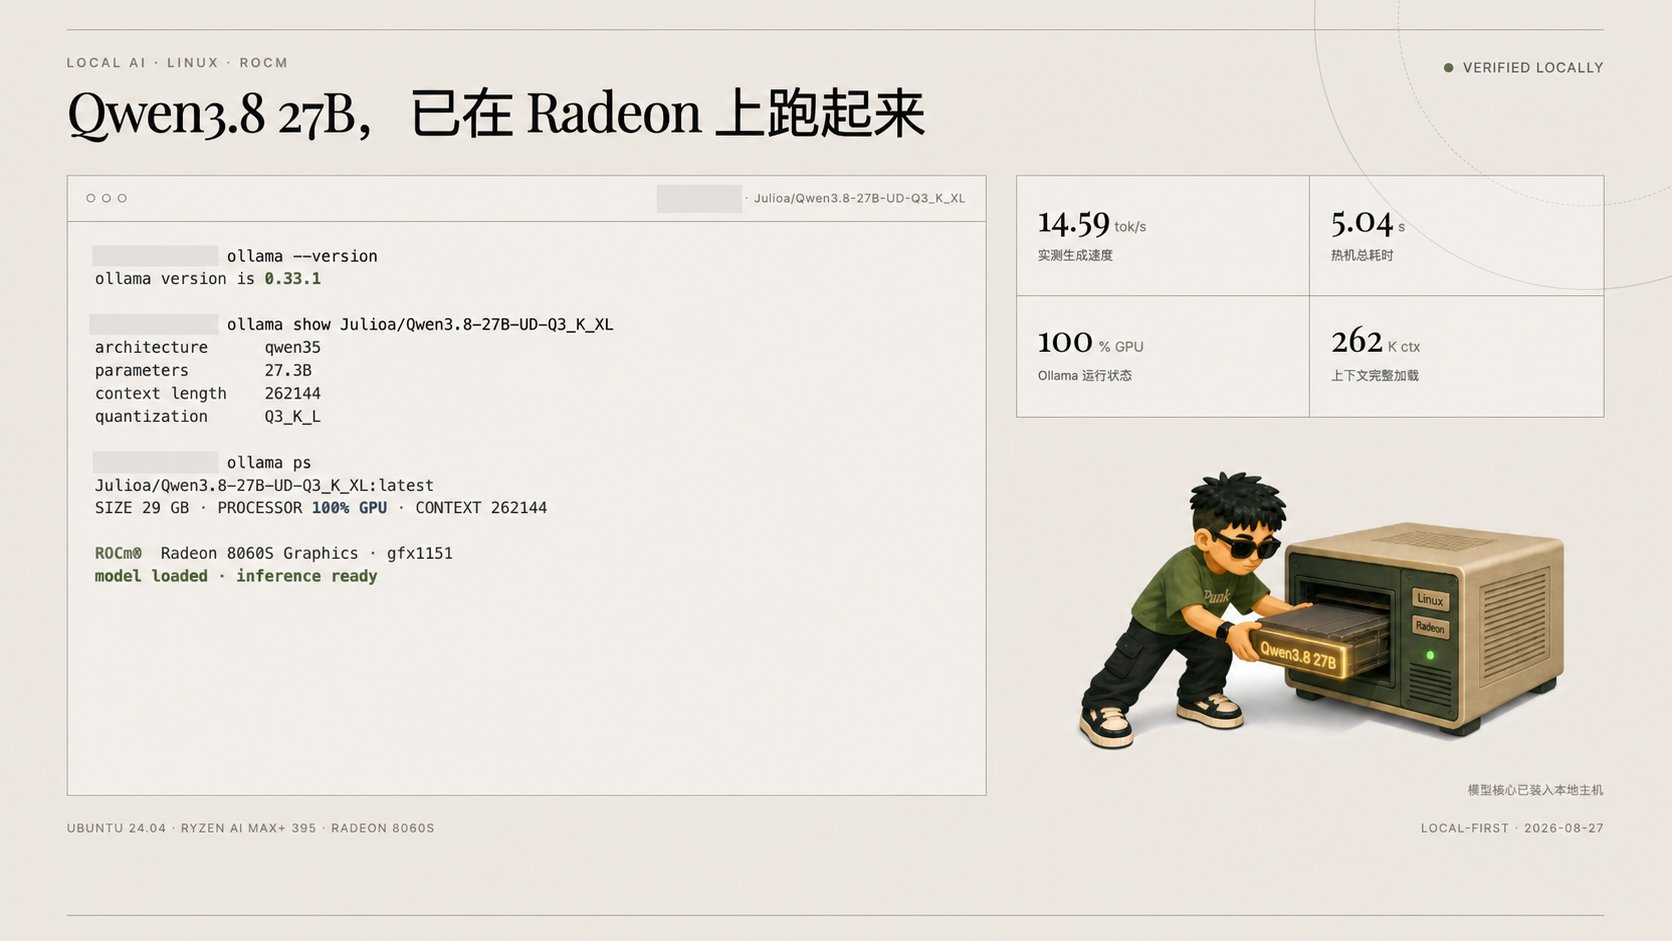 ollama ps 显示 100% GPU 运行截图
输出中显示 PROCESSOR: 100% GPU,即代表全部 66 层神经网络均已加载到显卡运行。
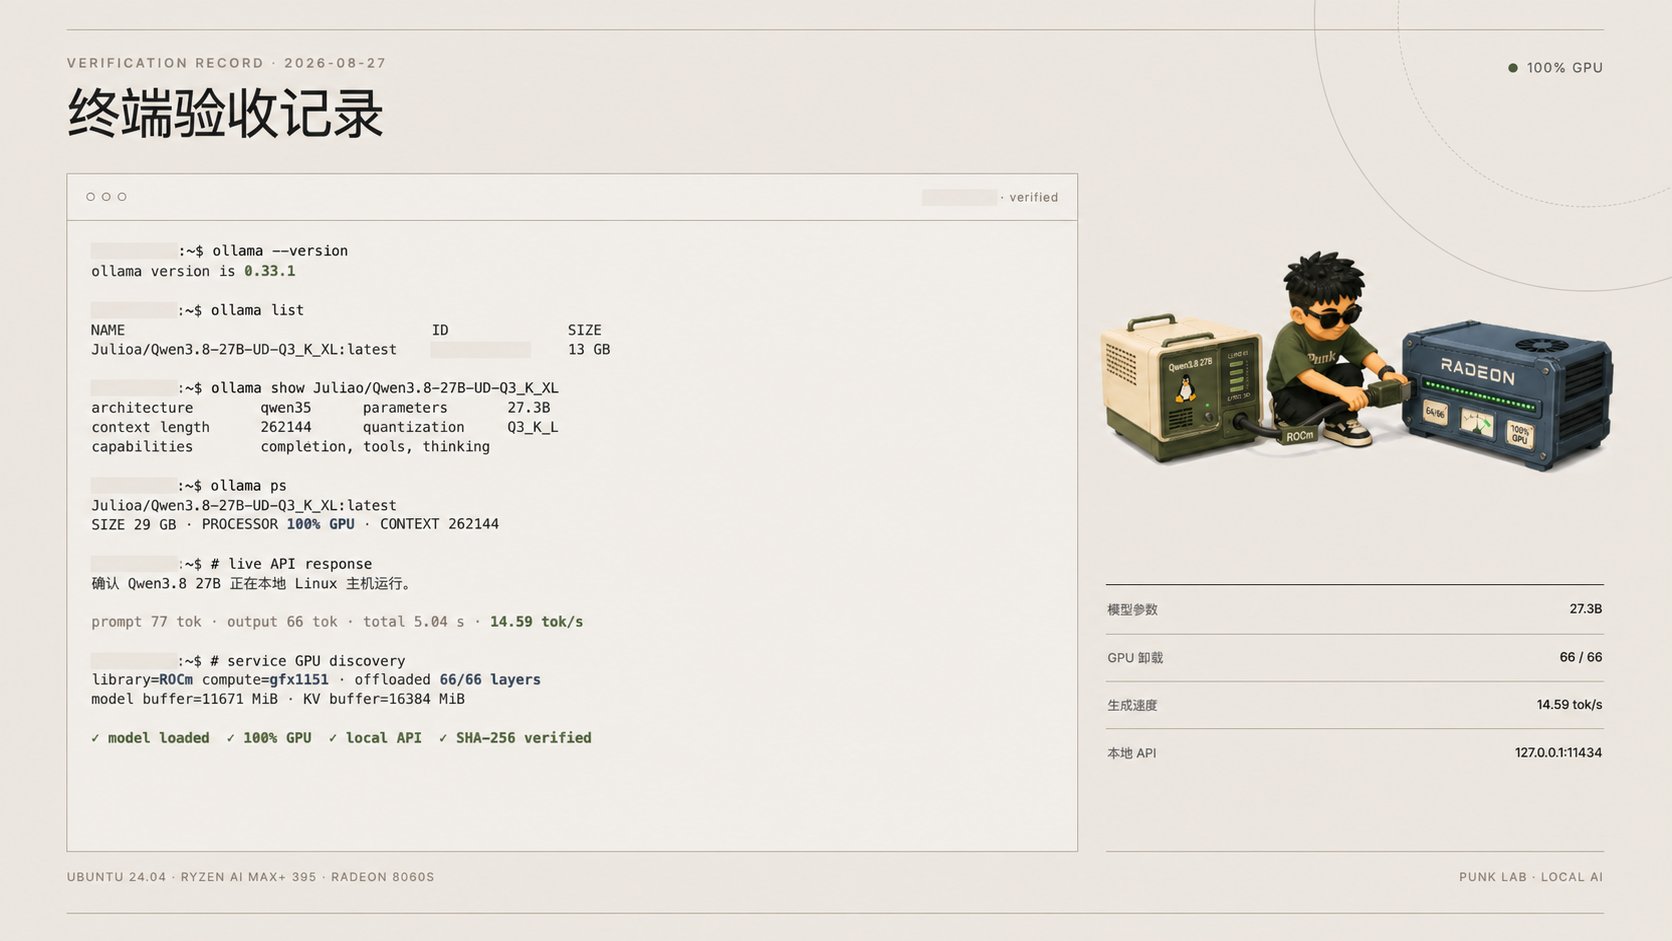 ollama show 模型参数与元数据
Linux 实机推理速度实测 在 AMD Ryzen AI MAX+ 395 与 Radeon 8060S 平台上,66 层权重全部交由 ROCm 驱动接管,预热后的生成速度稳定在
14.59 token/s,可满足日常问答、长文草拟与代码辅助需求。
第 6 章 通过本地 HTTP API 调用模型
Ollama 默认在本地启动兼容接口服务,监听地址为 http://127.0.0.1:11434。
在 Linux 或 macOS 终端用 curl 发送测试请求:
| 1 | curl -s http://127.0.0.1:11434/api/chat \ |
| 2 | -H 'Content-Type: application/json' \ |
| 3 | -d '{ |
| 4 | "model": "Julioa/Qwen3.8-27B-UD-Q3_K_XL", |
| 5 | "stream": false, |
| 6 | "messages": [ |
| 7 | {"role": "user", "content": "请用一句中文确认你正在本地运行。"} |
| 8 | ], |
| 9 | "options": {"num_ctx": 32768} |
| 10 | }' | python3 -m json.tool |
返回结果中包含 "done": true 及中文回复内容,即表示本地 HTTP API 已正常响应。
第 7 章 搭配图形界面客户端使用
如果不习惯一直在终端命令行里对话,可以接入以下三个开源图形前端:
- Open WebUI:网页端对话界面,内置本地文档知识库(RAG)、代码高亮与联网搜索插件。
- Chatbox:跨平台桌面与移动端客户端(支持 Windows、macOS、Linux、iOS 和 Android),填入
127.0.0.1:11434即可连接本地模型。 - Page Assist:Chrome 与 Edge 浏览器侧边栏扩展,可直接调用本地模型提炼当前网页内容。
部署完成后,你可以通过 ollama list 查看本机已下载的模型列表,或在闲置时运行 ollama stop Julioa/Qwen3.8-27B-UD-Q3_K_XL 立即释放约 29 GB 的内存占用。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。