
Hugging Face 开发指南:Hub 架构、Transformers 库与 Spaces 部署
作者:Miles Ma @miles_mazy(AI 算法专家 / FDE)•发布日期:2026-09-01•Hugging Face 入门实战指南
 Hugging Face 从入门到实战指南
找开源模型时,你经常会打开 Hugging Face。它把模型、数据集和可直接体验的网页应用放在一起。看到感兴趣的 AI 效果,你可以顺着介绍找到在线演示,试过之后再决定是否把模型下载到本地电脑。
第一次打开这个网站确实不太容易下手。页面上是满屏英文,模型名字后面跟着一串数字,还有 Datasets、Spaces、GGUF 和 LoRA 等术语。很多人本来只想找个能用的工具,点进去却像进了代码文件夹。
一、为什么用 Hugging Face
使用封装好的商业 AI 产品时,你只能在它提供的固定功能里操作。你输入一句话,它返回一张图。如果想换掉背后的模型,或者把模型下载到本地离线运行,现成产品通常不提供入口。
在 Hugging Face 上,你可以自己挑模型,也能自由选择运行方式。 有网页应用就先在线试效果,觉得合适再找下载版本;拿不准时,还能回到原始说明文档里核对细节。
同样是“把一张图片生成视频”,这里会有不同团队发布的模型、社区做好的在线演示,以及适配本地软件的下载版本。你可以先对比实际生成效果,再决定采用哪一个。
模型页通常会关联在线演示和原始论文,数据集页也会列出用该数据训练过的模型。看到某个感兴趣的效果后,你可以顺着这些链接查到出处,了解它的具体实现方式。
即使不写代码,你也可以直接用社区做好的网页应用,或者把模型导入支持它的图形界面软件。尝试新功能、下载开源权重或寻找特定图像风格时,这套流程都很实用。
平台上的资源由不同作者发布,使用许可、硬件要求和在线演示配额各不相同,使用前请先阅读项目说明。
 一、为什么用 Hugging Face
二、打开首页先认这五个位置
打开 Hugging Face 首页,先看顶部导航栏的五个入口。
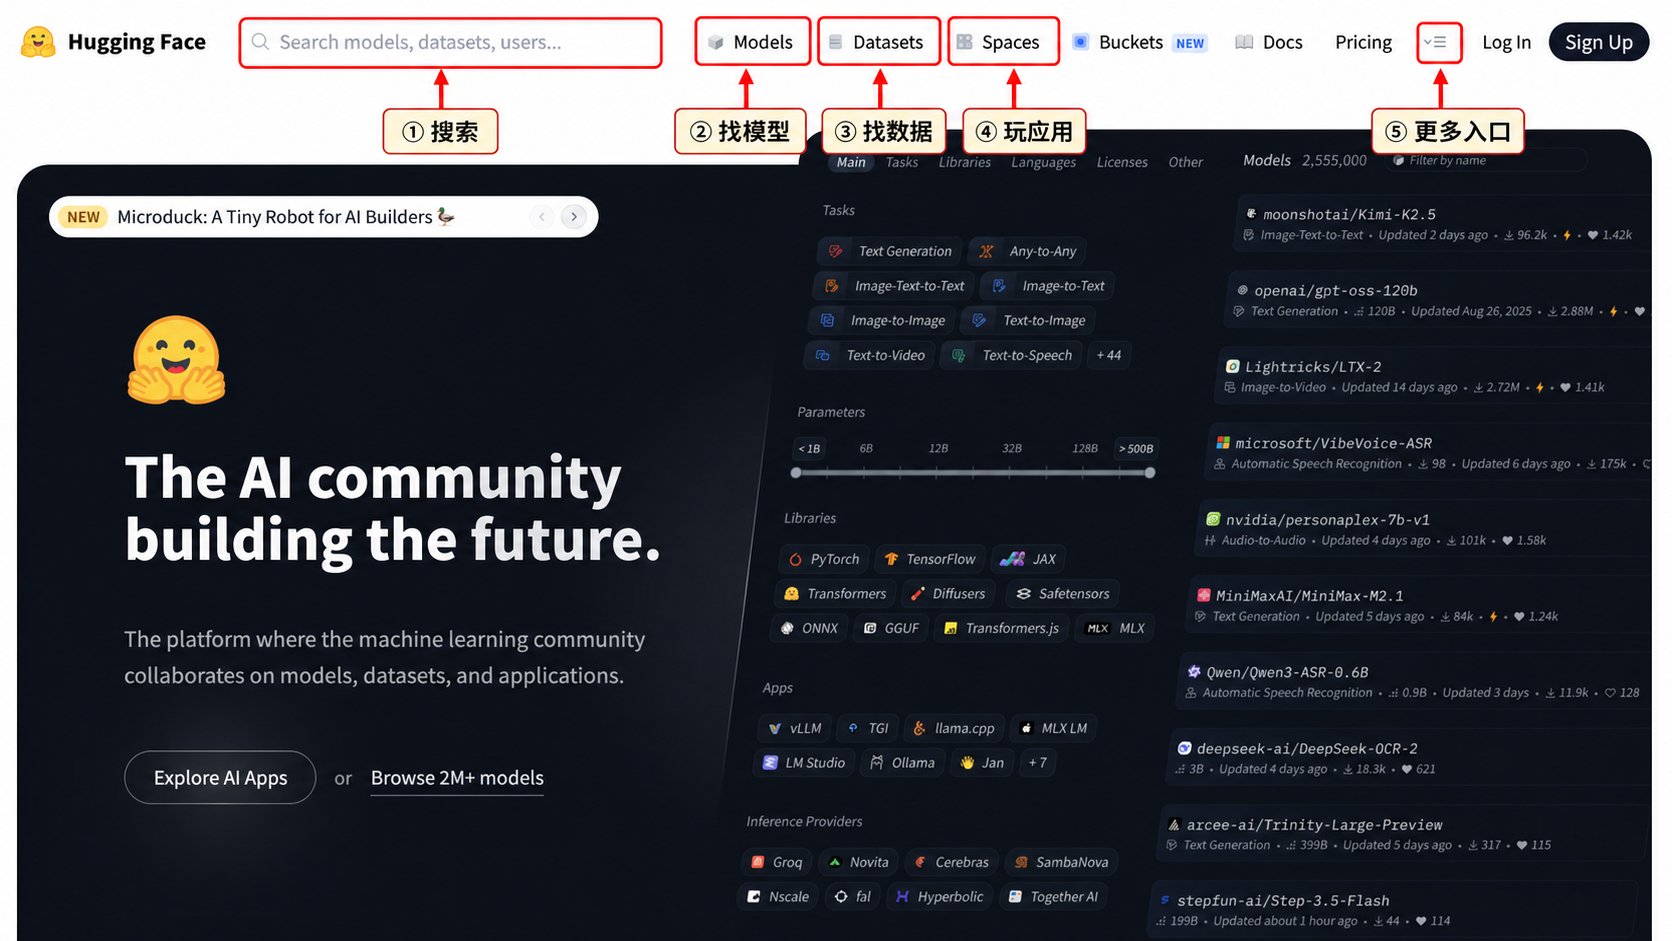 打开首页先认这五个位置
① 搜索框:知道准确名称时直接在这里查找。可搜索模型、数据集、作者或组织。拿到别人给的完整仓库名时,直接复制粘贴比自己猜关键词更准。
② Models:模型区。查找 Qwen、DeepSeek 等大语言模型,或者下载图像生成权重,都从这里进入。
③ Datasets:数据集区。存放整理好的训练与评测材料,例如图文配对、问答样本和带分类标签的图片。
④ Spaces:应用区。开发者把模型封装成了网页工具,打开就能看到输入框、上传区和运行按钮。想直接试效果,先来这里。
⑤ 更多菜单:展开后可以进入收藏集合、每日论文和官方课程,具体位置见截图标记。
例如你想试 AI 修图,可以先去 Spaces 找现成的修图应用。试过觉得效果好,再顺着应用说明点进背后的模型页,查看是否有适合本地电脑运行的版本。
接着点开导航栏里的“更多菜单”。
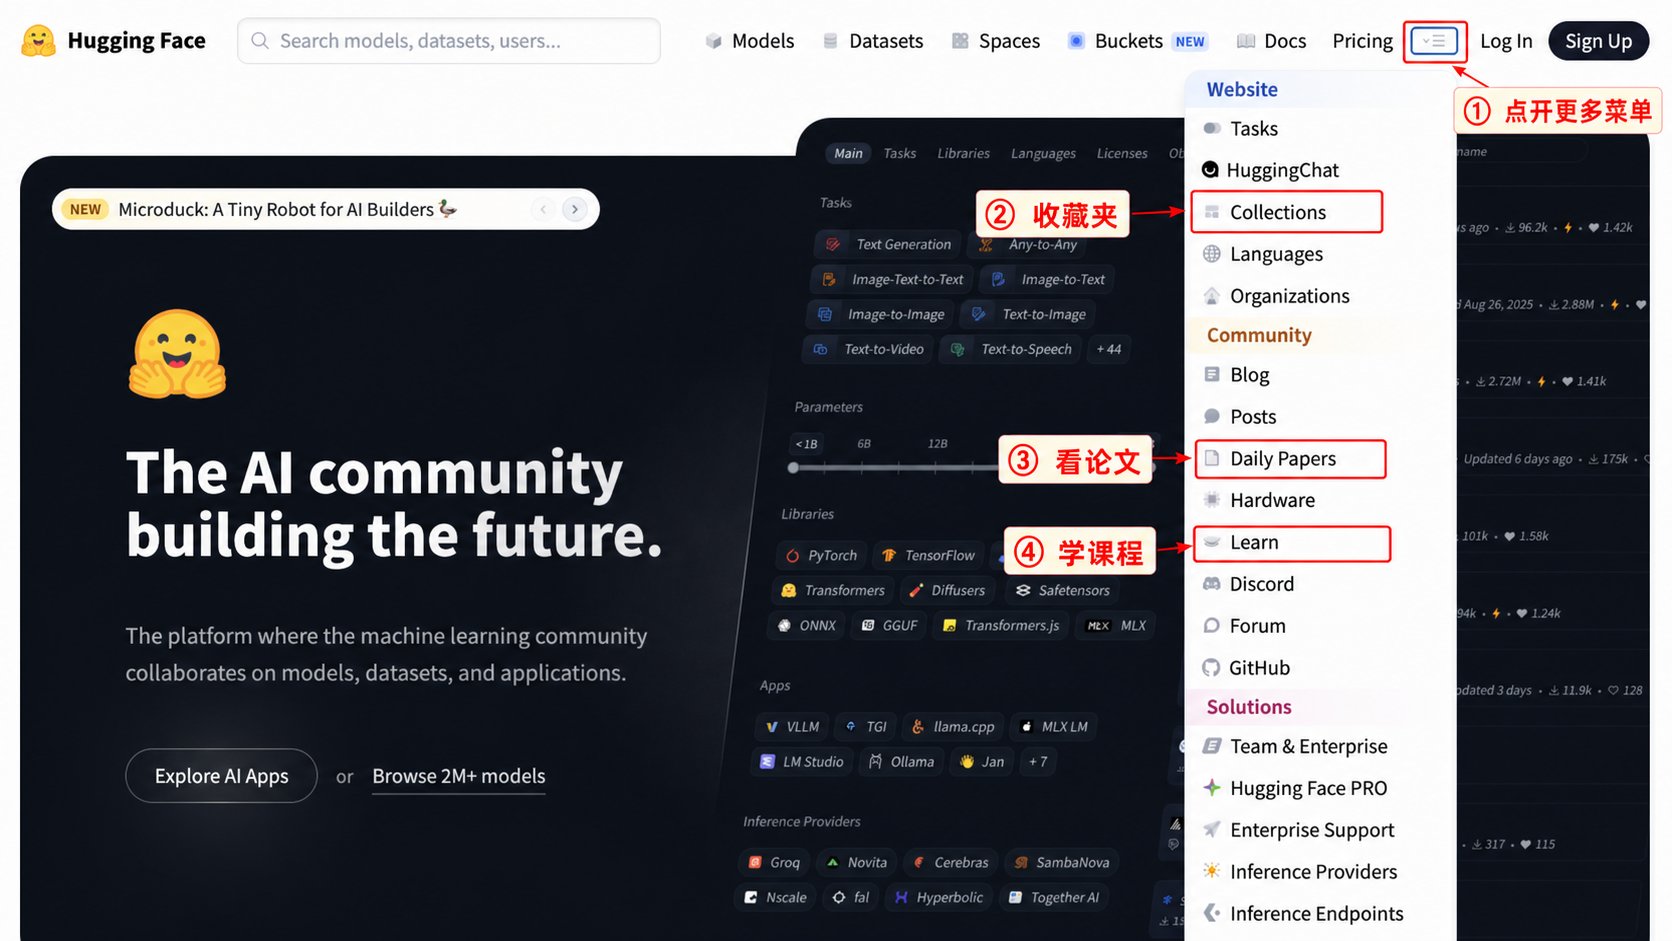 更多菜单:Collections、Daily Papers 和 Learn
菜单中常用的三项:Collections 是收藏集合,Daily Papers 是论文专区,Learn 是官方课程。
对英文界面不熟时,可以开启浏览器的网页翻译。建议同时留意按钮的英文原名,方便对照教程截图找位置。
三、先去 Spaces 试用在线 AI 应用
点击顶部的 Spaces,进入 AI 应用目录。
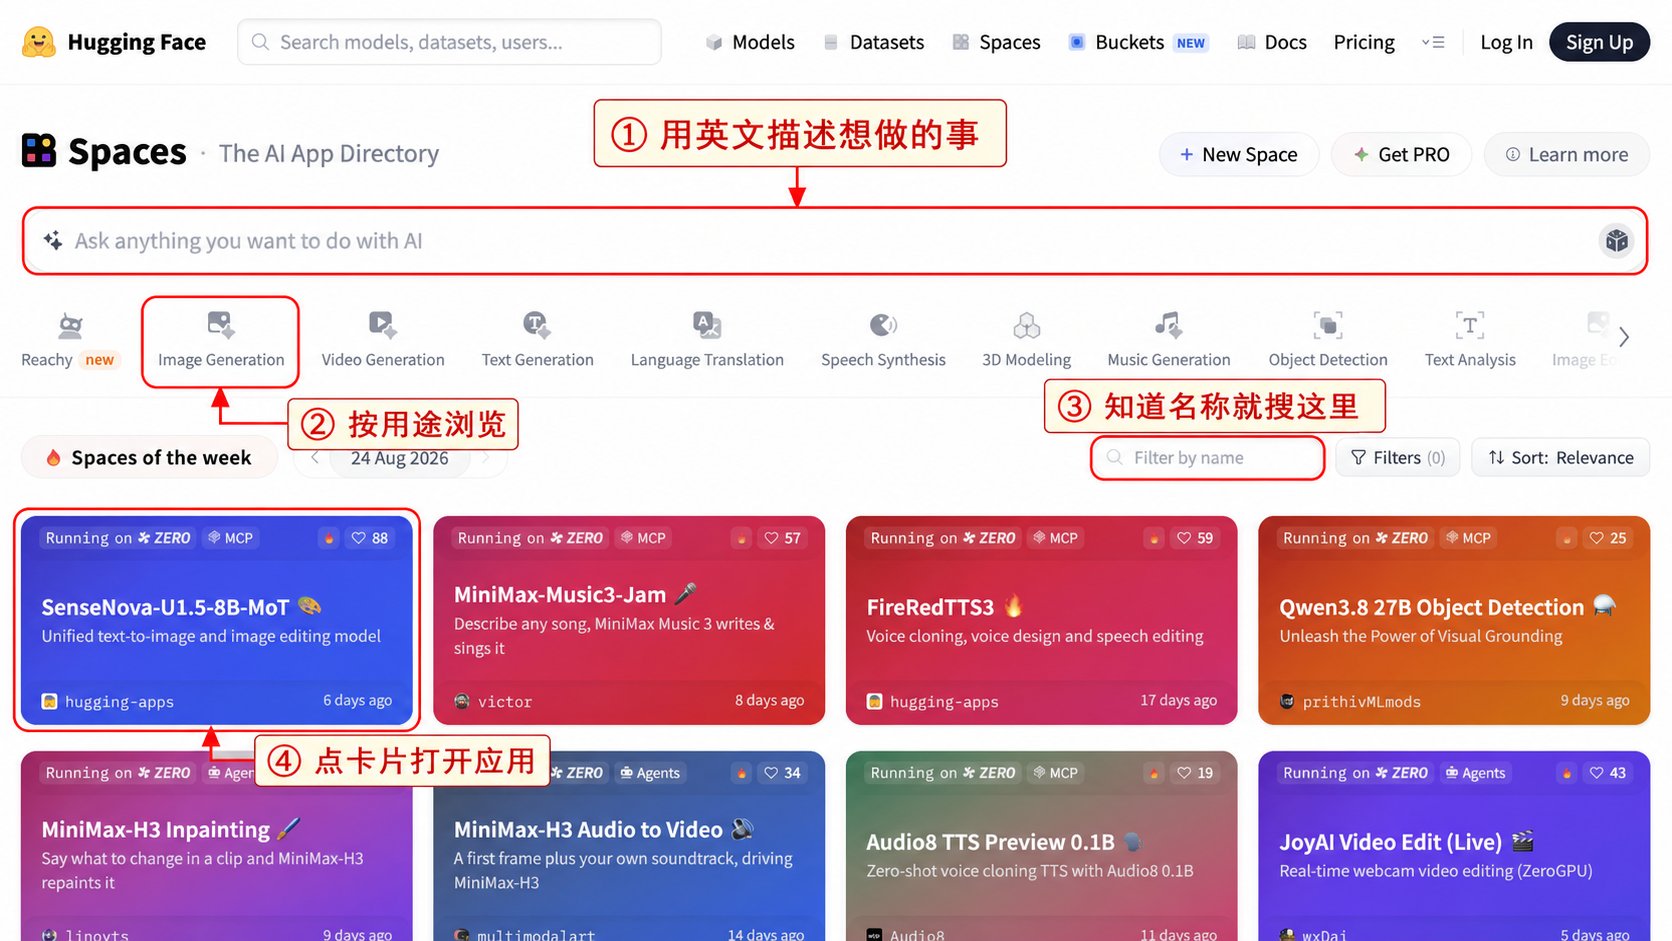 Spaces AI 应用目录
页面上的每张卡片对应一个在线应用,显示名称、简介和发布者。点击卡片即可打开网页界面操作,无需先把模型下载到本地。
图中的四个位置用法如下:
- ① 顶部大搜索框:输入你想让 AI 完成的任务描述。
- ② 用途分类:例如 Image Generation(生成图片)、Video Generation(生成视频)和 Text Generation(生成文字)。
- ③ Filter by name:按应用名称过滤。知道某个 Space 的准确名字时,直接用它查找。
- ④ 应用卡片:点击进入对应的在线应用。
初次体验建议先挑功能单一的小工具,例如图片抠图或图像超分放大。这类任务目标明确,试一次就能看出效果好坏。
1. 搜索时尽量用英文关键词
平台上的项目名、标签和简介大多使用英文。直接搜中文匹配到的结果较少,换成常见英文词更容易找到对应工具。
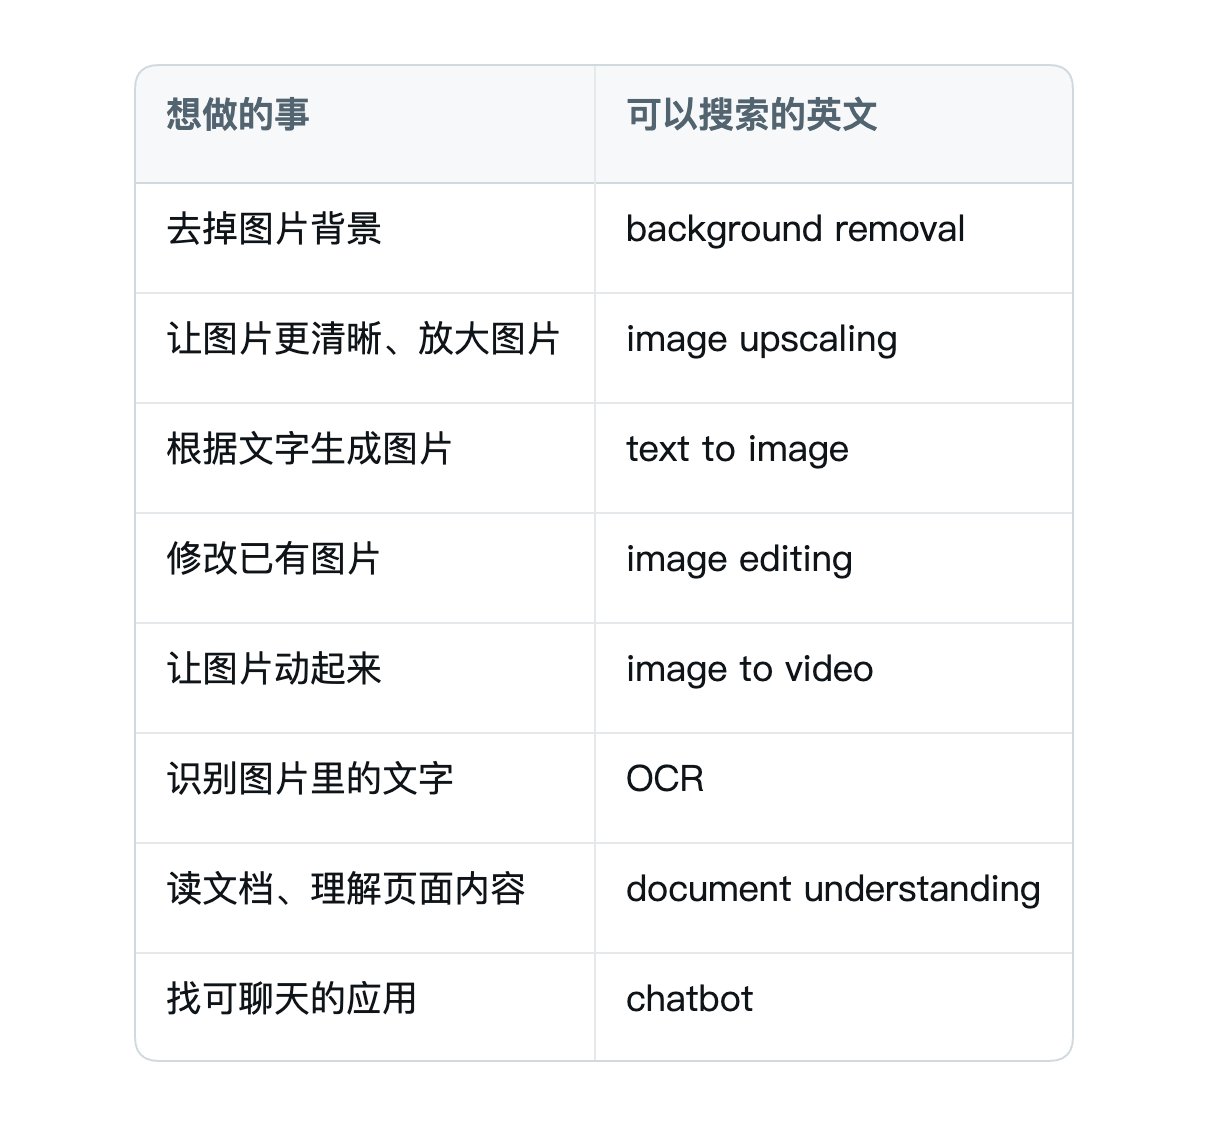 搜索时尽量用英文关键词
搜出结果后,点开简介确认它的具体用途。同样带有“图片编辑”标签的应用,有的负责替换背景,有的做局部重绘,有的只是论文成果展示。
同一个关键词下常会出现多张相似卡片。它们可能调用同一个底层模型,也可能是社区用户复制原项目后做了修改。点击前顺手核对一眼卡片上的发布者账号。
2. 以抠图应用为例看懂应用页面
打开 Xenova 的 Remove Background Web,这是一个去除图片背景的在线工具。
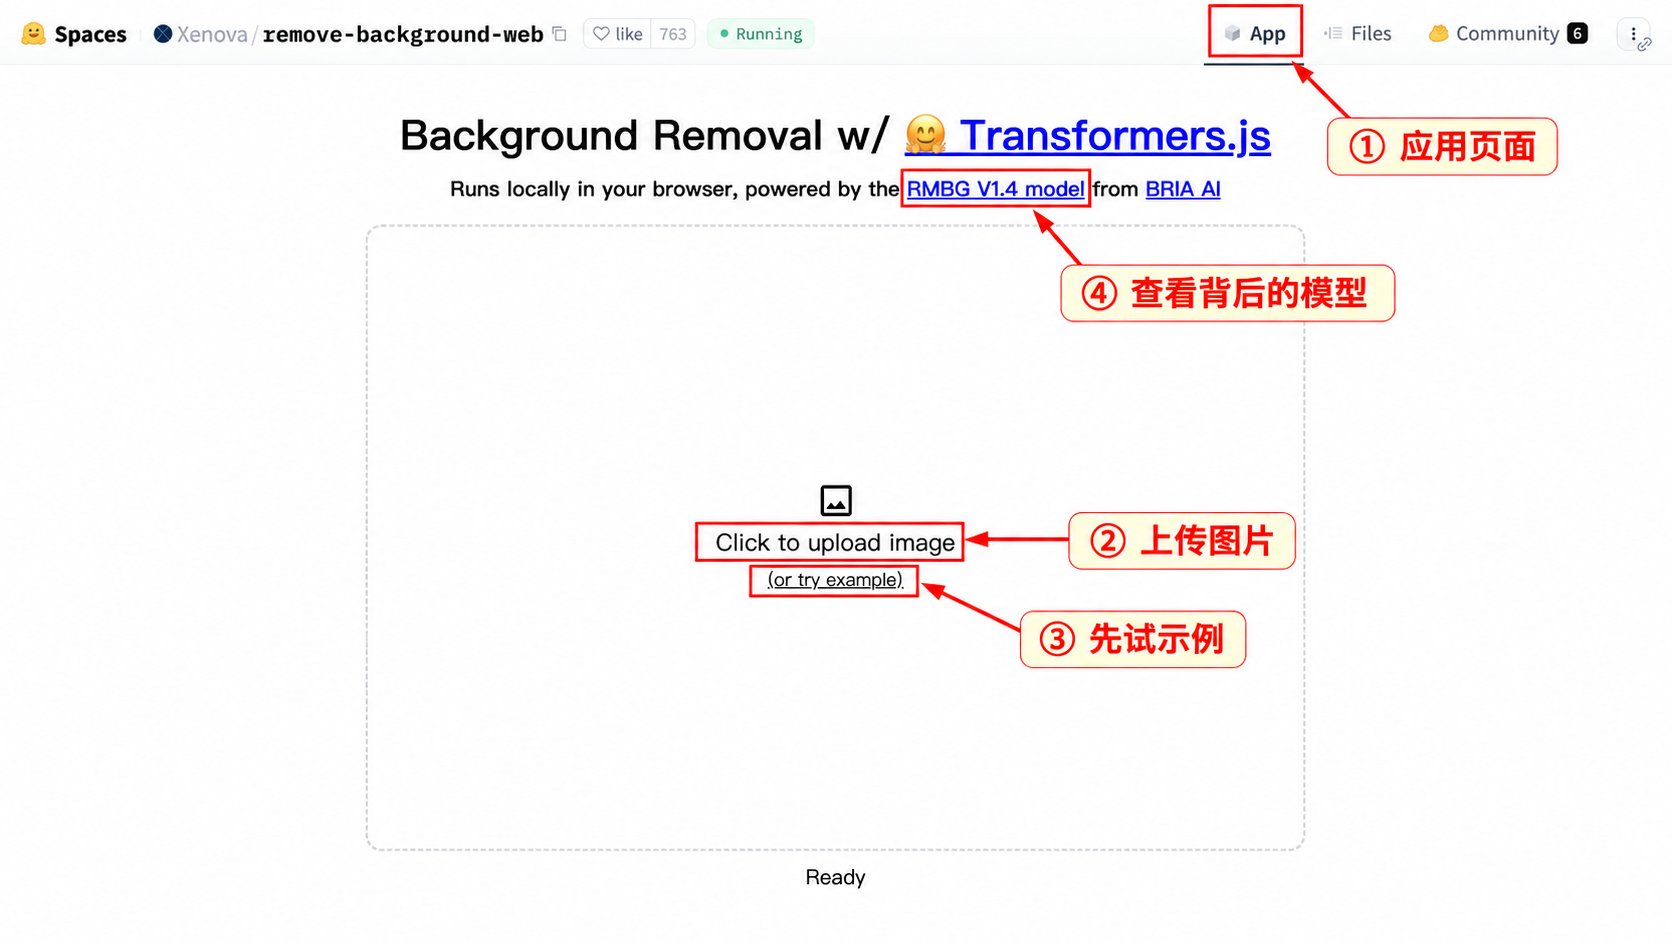 以抠图应用为例看懂应用页面
① App 是当前交互页面;右侧的 Files 和 Community 分别对应项目源码文件与社区讨论区。
② Click to upload image 是图片上传区。其他应用里常见 Upload 或 Drop image here,功能相同。
③ try example 是加载作者预置的示例图。建议先点示例跑通流程,再上传自己的测试图。
④ RMBG V1.4 model 是该应用调用的模型链接。点击这里就能直接跳到背后的模型仓库。
这个抠图应用注明在浏览器本地运行;其他 Space 可能把文件传到远端服务器或第三方接口处理。第一次测试请用普通示例图,不要上传身份证、客户合同和未公开的商品图。
3. 不同应用里的通用按钮
不同 Space 的界面排版各有差异,但核心操作按钮的命名基本一致:
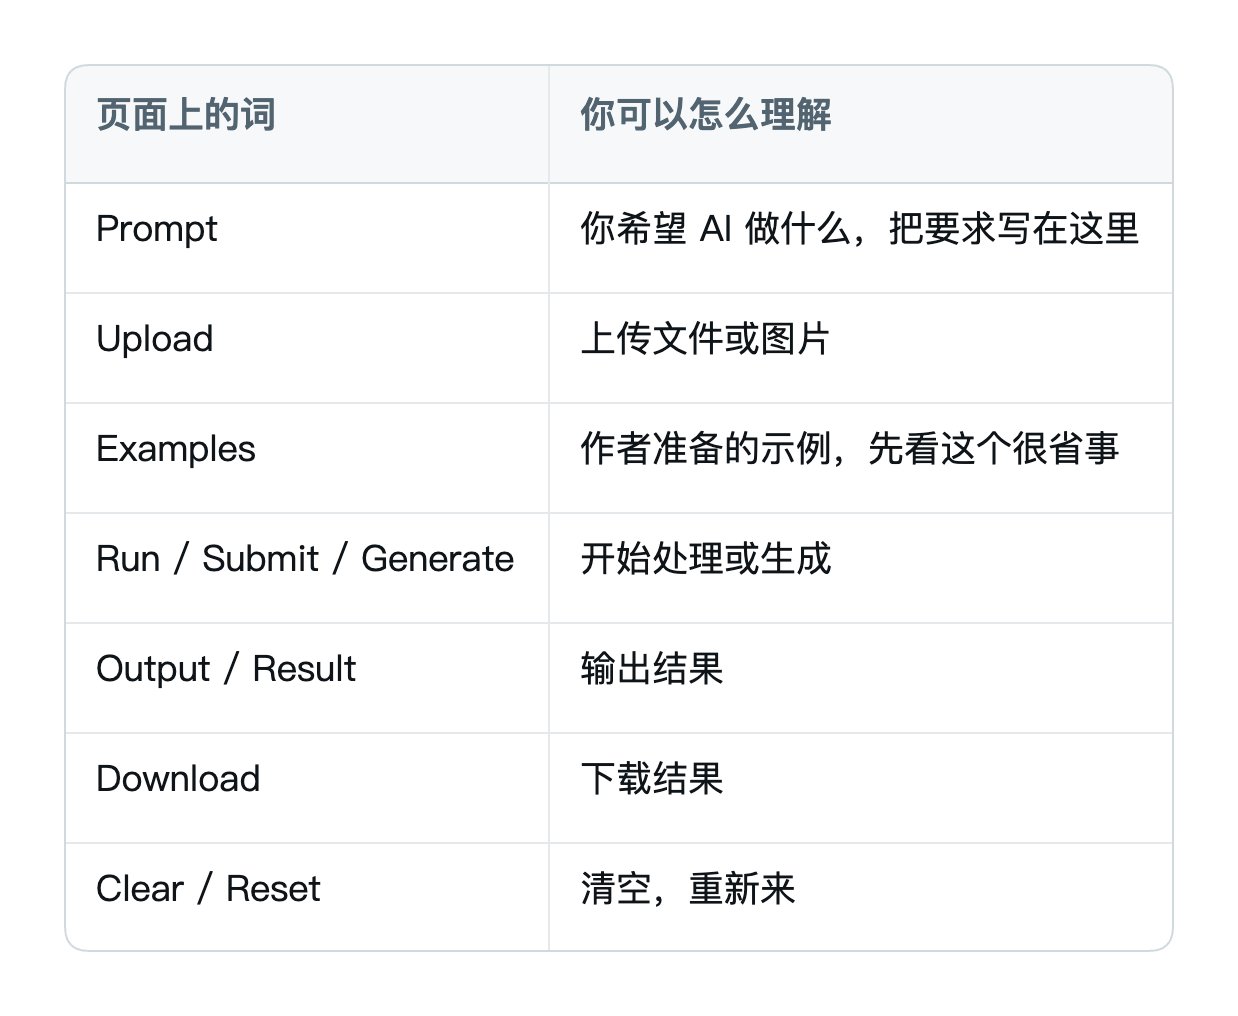 不同应用里的通用按钮
部分应用上传图片后会自动运行,部分需要手动点击 Run 或 Submit。打开陌生界面时,先依次找到输入区、运行按钮和输出区即可。
Advanced Settings 是高级参数区,初次测试保持默认值即可。需要调参时,每次只改动一项,方便对比前后变化。
测试工具时,先跑自带示例看清步骤,再换一张脱敏测试图。试抠图重点看主体边缘是否干净、背景有无残留;试图像放大重点看文字和纹理有没有变形。效果达标再点 Download 保存结果,不必一上来研究全部参数。
4. 应用打不开时先看运行状态
Space 卡片和页面顶部会标注当前状态:Running 表示正常运行;Sleeping 表示休眠,点击唤醒需要等待片刻;Building 表示正在构建环境;Runtime error 表示程序报错停止。
遇到 Runtime error 通常需要项目作者修复,直接换一个同类 Space 更快。部分热门应用会触发排队、限制单日调用配额或要求登录授权,按页面提示处理即可。公开演示随时可能变动,常用工具建议多收藏一个备选。
四、去 Models 查找模型
应用负责提供交互界面,模型负责提供底层 AI 能力。同一个模型可以封装成不同应用,一个复杂应用也可以串联多个模型。
点击顶部导航栏的 Models。
 去 Models 查找模型
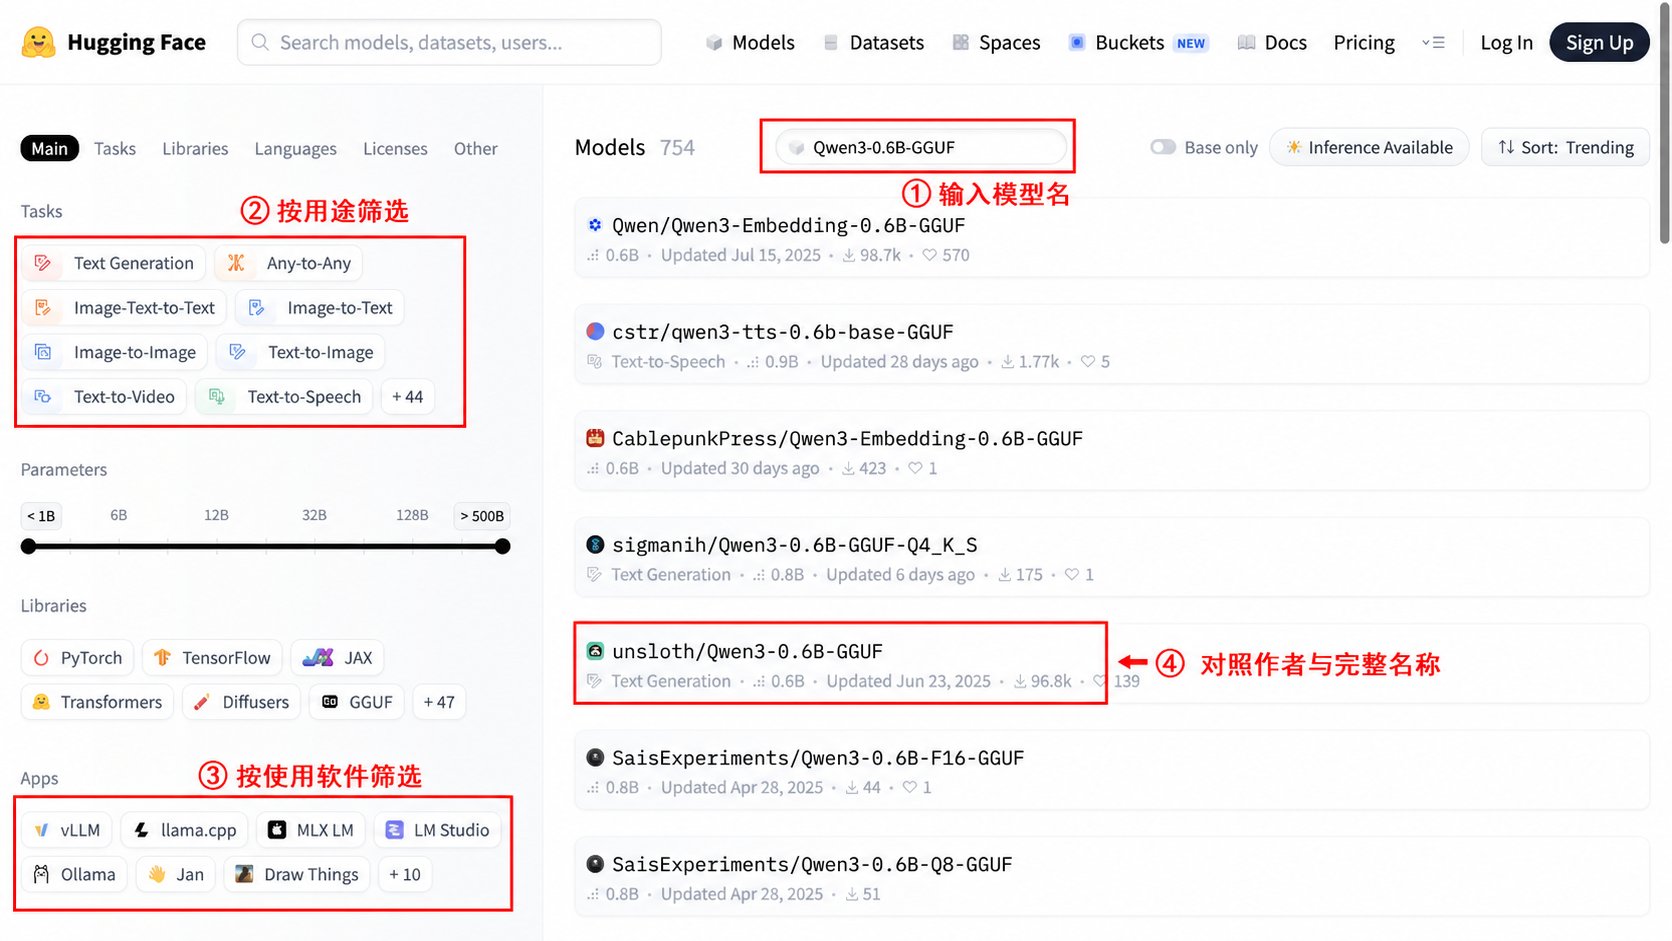
页面右侧是模型列表,左侧是筛选面板,支持按任务类型、兼容软件和许可证缩小范围。
① 名称搜索框:输入模型关键词检索。图中搜索 Qwen3-0.6B-GGUF,列表会展示官方与社区发布的不同衍生版本。
② Tasks:按任务类型筛选。Text Generation 是文本生成,Text-to-Image 是文生图,Image-to-Text 是看图生成文字。
③ Apps:按本地运行软件筛选。例如准备在 LM Studio 里加载模型,可先勾选对应筛选项,再核对具体仓库格式。
④ 完整仓库名:格式为“发布者/项目名”。例如 unsloth/Qwen3-0.6B-GGUF 中,斜杠前的 unsloth 是发布机构,斜杠后是模型仓库名。
名称相近的模型可能承担完全不同的任务。下载前务必核对完整仓库名与任务标签,避免把图像理解模型误当成文生图模型。
先认清模型名称里的常见后缀
开源模型命名通常会把用途、参数规模和文件格式拼在后缀里,最常见的有四类:
Base
预训练基础模型,侧重文本续写与二次微调,一般不直接用于日常问答聊天。
Instruct / Chat
经过指令遵循或对话对齐微调的版本,适合直接用来问答聊天与执行指令。
0.6B / 7B / 14B
B 代表十亿(Billion)参数。参数越大占用的内存与显存越高,需结合硬件配置挑选。
GGUF 与 LoRA
GGUF 是本地推理常用的量化单文件格式;LoRA 是轻量微调权重,必须配合对应的基础模型加载。
挑选模型时,同时结合任务用途、运行软件和电脑配置过滤。例如要在本地聊天软件里跑中文对话,就先筛软件支持的 Instruct 模型,再按显存容量选参数规模。
Trending 榜单、下载量和点赞数适合用来发现近期项目,实际好不好用仍要靠你的真实任务测试。
五、模型详情页必看的五个位置
点开 unsloth/Qwen3-0.6B-GGUF,进入模型详情页。
 模型详情页必看的五个位置
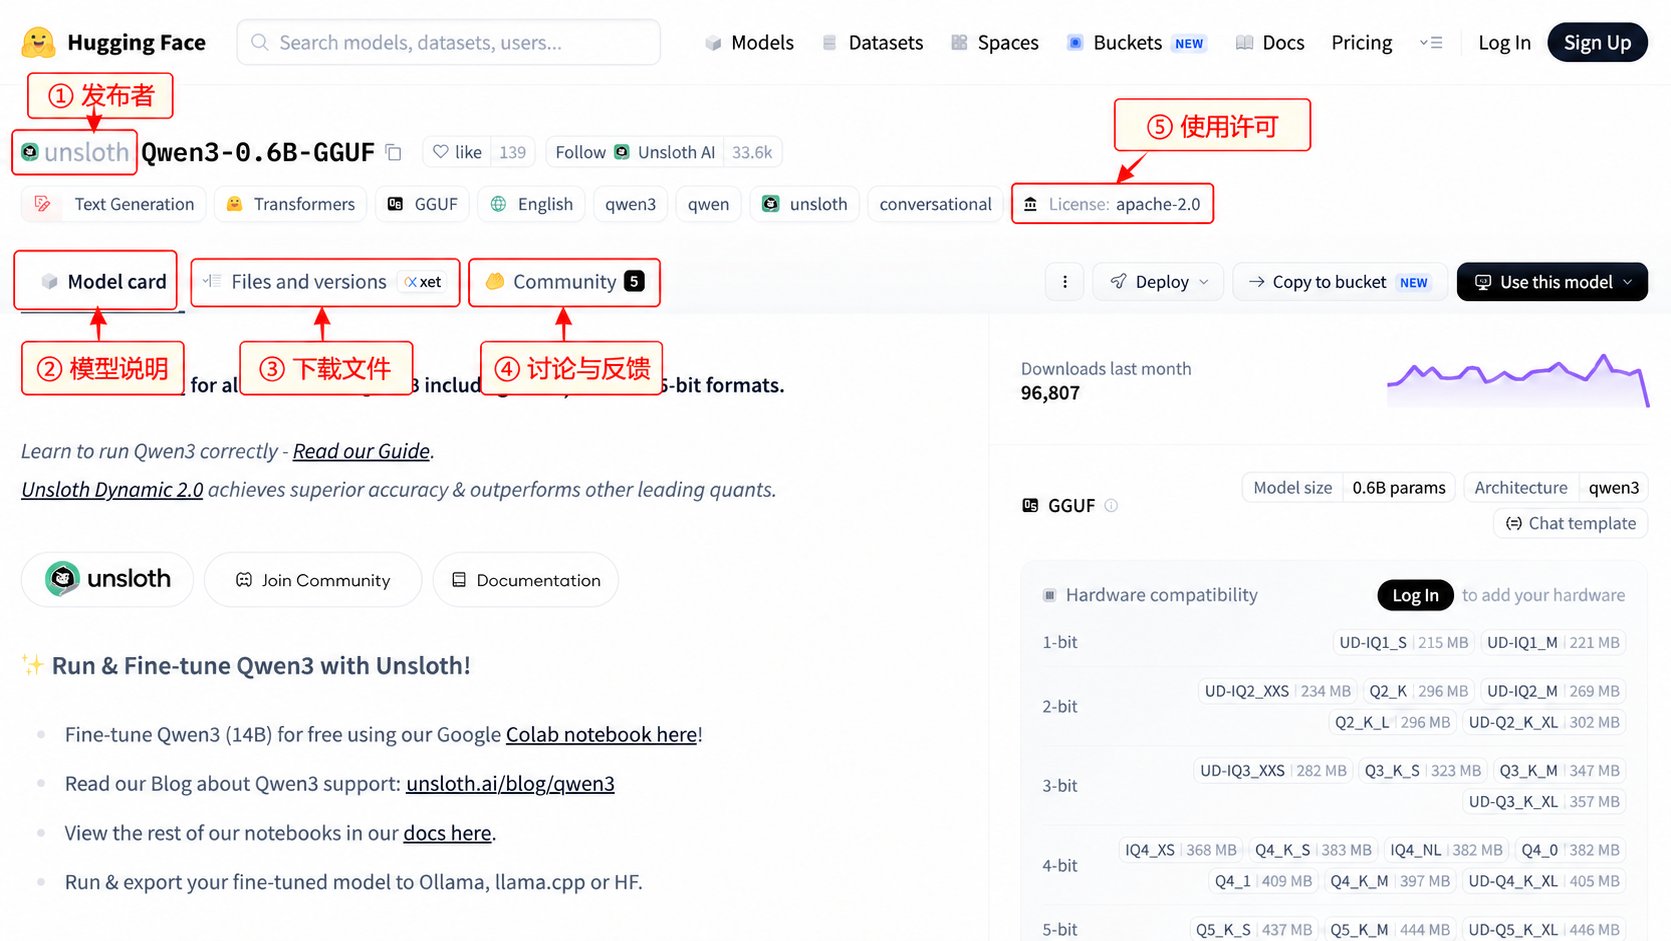
① 发布者:这里是 Unsloth,提供的是 Qwen3 的 GGUF 量化版本。虽然仓库名带有 Qwen,但当前文件由 Unsloth 打包发布,核对来源一律看斜杠前面的账号。
② Model card:模型说明书。介绍适用任务、评测结果、基础模型来源、运行参数以及已知局限。
③ Files and versions:文件与版本列表。所有模型权重文件的下载入口都在这个标签页下。
遇到某个模型在本地软件里报错打不开时,先点 ④ Community(社区讨论区),看看其他用户是否提过相同的兼容性问题或作者有无补充说明。
⑤ License:使用许可协议。个人本地学习与接入商业项目在法律授权上差别很大,上线对外服务前务必核实许可条款。
如何快速阅读模型说明
面对很长的英文说明页,先看它声明支持什么任务,再看输入输出示例与使用限制。
打算用来处理中文问答,就找说明里有没有中文对话示例。用于电商商品图处理时,要分清文生图、局部编辑和背景替换:凭文字画出新商品,与保留原商品主体只换背景,调用的是两类不同的模型。
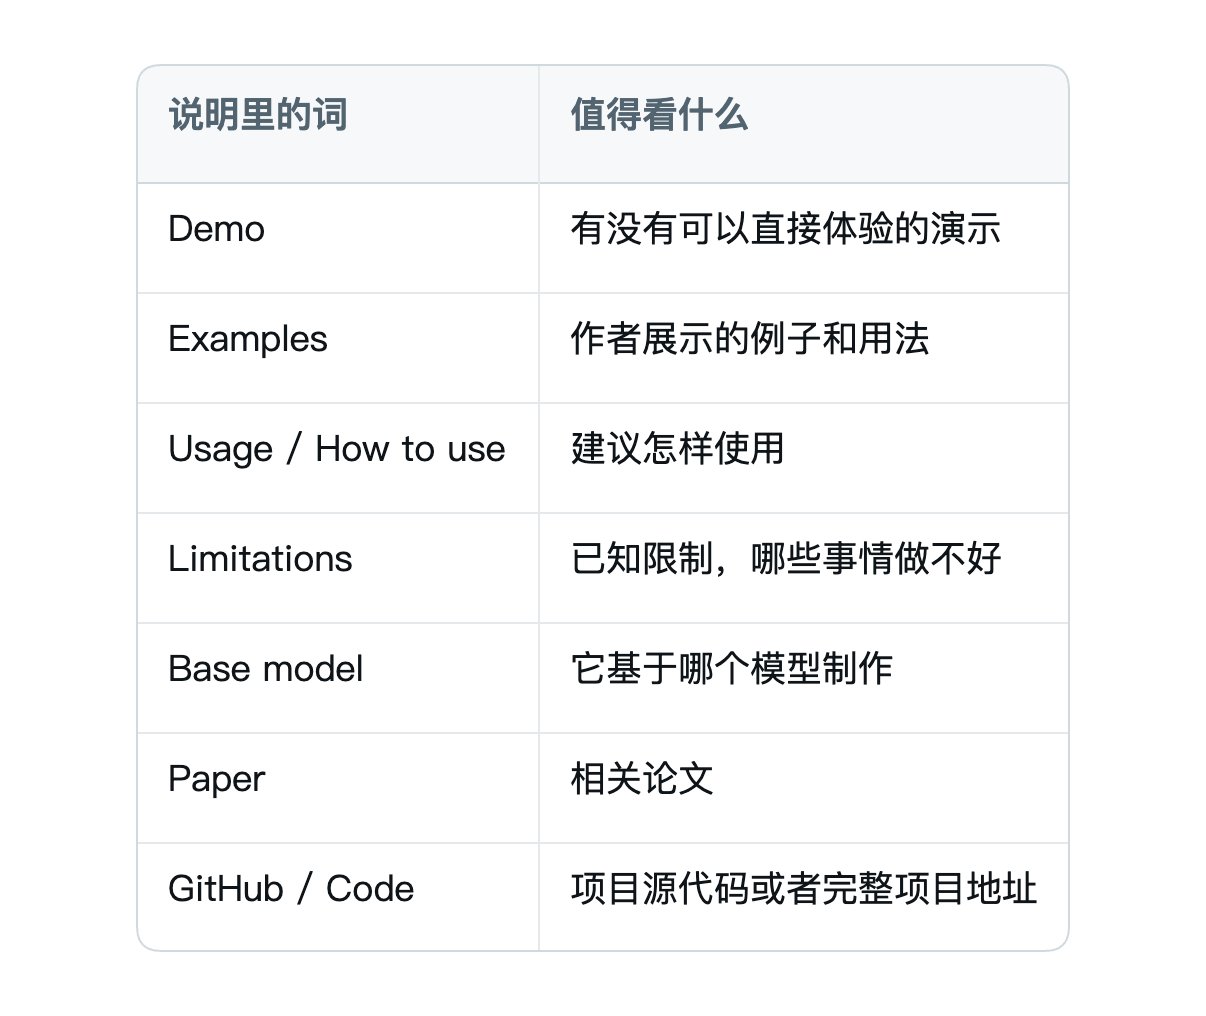
在说明页里遇到下面这些标题词时,可以重点定位对应内容:
 如何快速阅读模型说明
不打算写代码时,可以直接跳过大段 Python 示例,重点找 Demo 链接、图形界面软件配置方法和推荐下载版本。对于只给代码调用方式、暂无图形界面的项目,可以先加入收藏。页面上的 GitHub / Code 指向源码仓库,想快速试用优先点 Space 演示入口。
模型页右侧栏常会关联在线推理小组件或同系列 Spaces,点进去就能直接测试。如果没有在线入口,就需要按说明把权重导入本地软件运行,单在下载页面里无法直接对话。
六、模型下载与本地运行方法
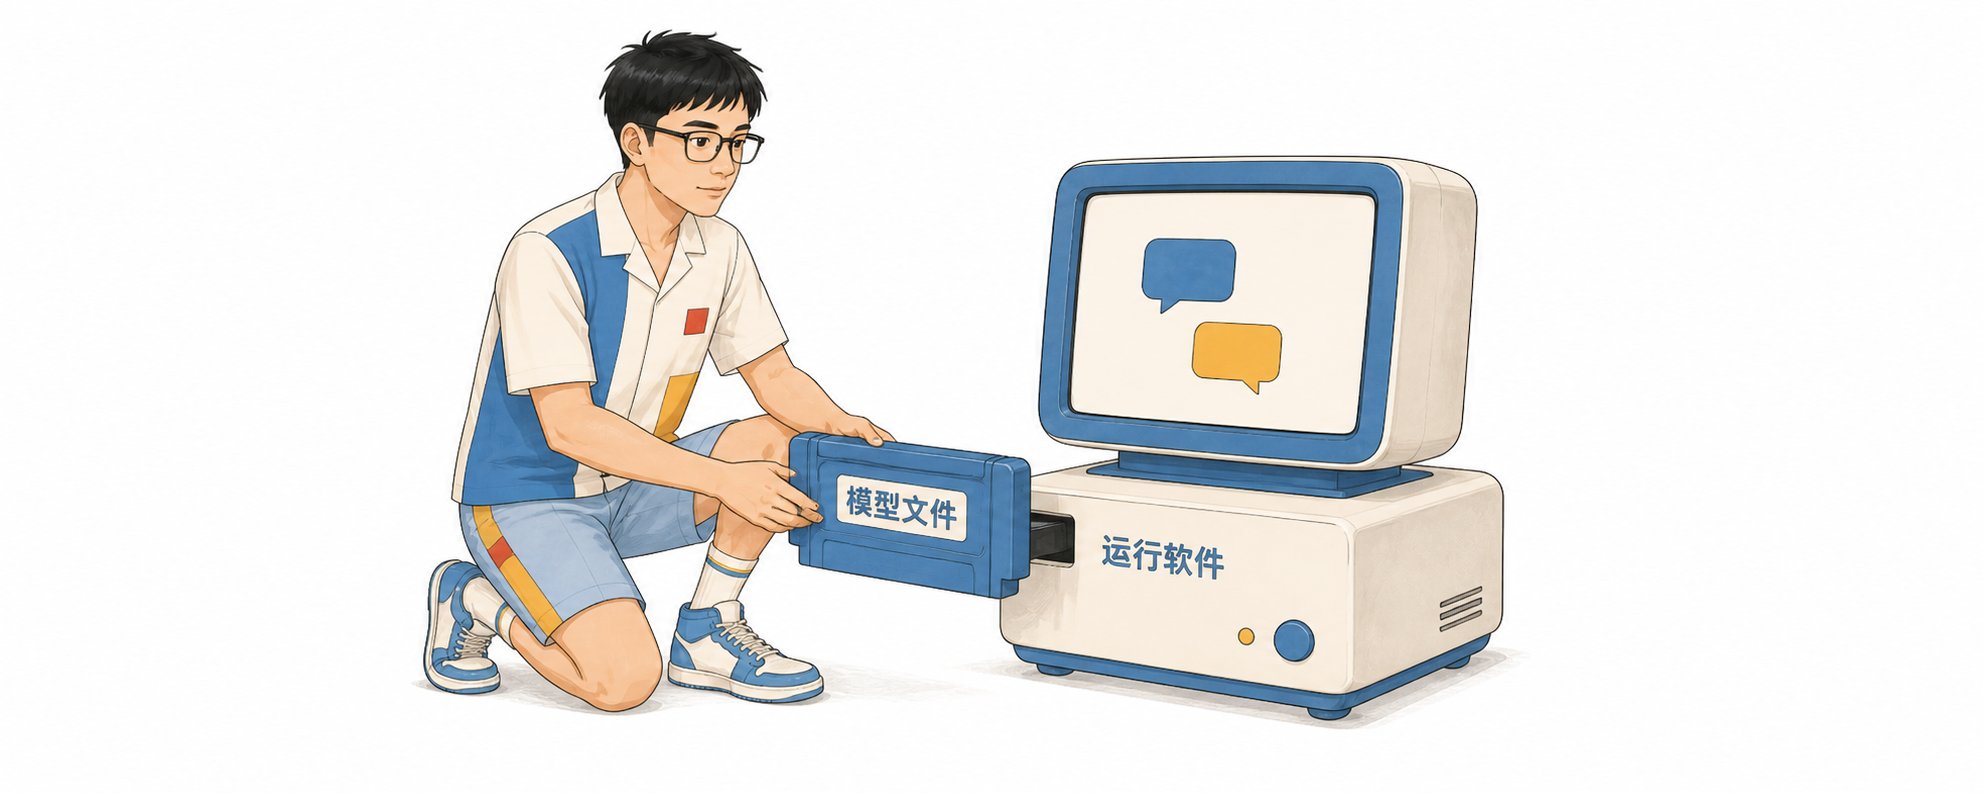
模型权重文件无法直接双击打开运行,必须交给支持该格式的宿主软件加载。
文本对话、AI 绘图和视频生成各自对应不同的本地运行软件。先选好准备使用的软件,再去挑选它兼容的模型格式,比盲目下载几十 GB 的权重文件更省时间。
 模型下载与本地运行方法
1. 从模型页进入文件列表
留在刚才的模型详情页,点击顶部的 Files and versions。
文件列表里同时包含说明文档、配置文件和模型权重。这个 GGUF 仓库提供了同一模型的多种量化精度版本,按你的运行软件与硬件配置挑其中一份下载即可。其他格式的仓库是否需要下载多个文件,以各自 Model card 的说明为准。
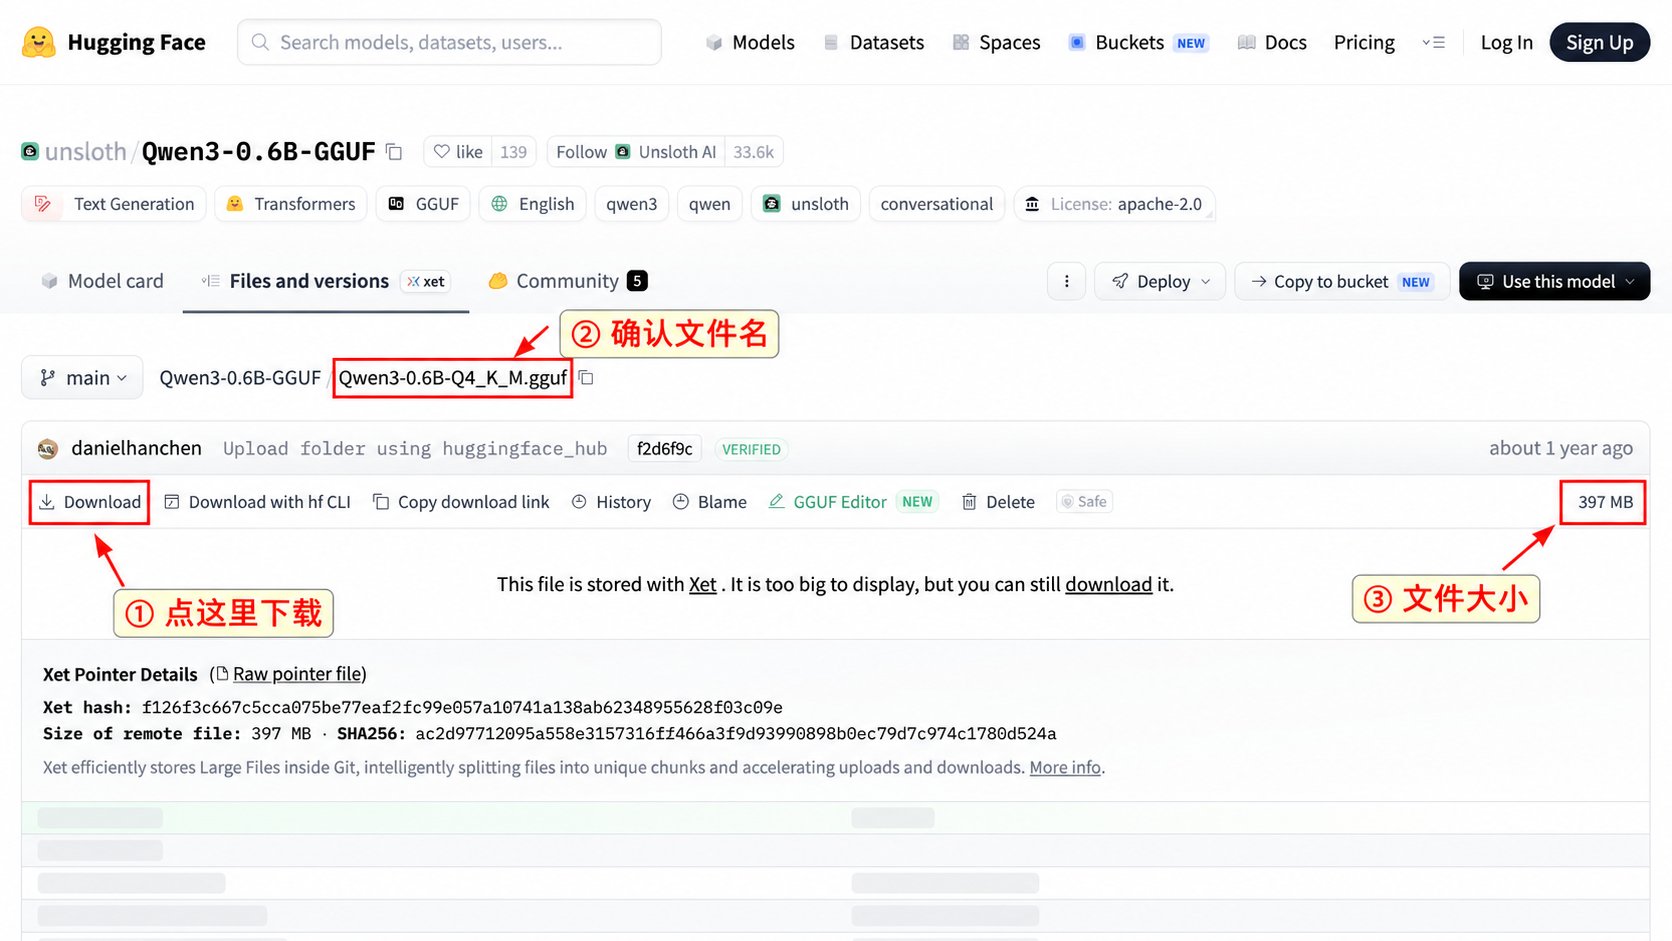
在列表中找到 Qwen3-0.6B-Q4_K_M.gguf,也可以用 Go to file 搜索该文件名,点击进入单文件详情页。
 从模型页进入文件列表
① Download 是单文件直接下载按钮;
② 显示当前完整文件名;
③ 显示文件体积。点击下载前,先对照文件名和体积确认无误。
图中这个文件约 397 MB,仅代表当前单个量化文件的磁盘体积。整个仓库总大小以及运行时占用的内存开销,需要分开核对。
如果网页提示文件过大无法展示(This file is stored with Git LFS / Too large to display),只是说明浏览器不支持在线预览二进制权重,直接点击 Download 仍可正常下载,旁边的 CLI 命令选项无需理会。
2. 同一个模型为什么有多个版本
文件体积差异主要来自“量化”(Quantization)。量化用占空间更小的数值精度保存模型权重,能显著降低文件体积与显存开销,但会带来轻微的效果折损。
Q4、Q5 和 Q8 是最常见的量化位数标记。同一模型下,数字越大精度越高,占用的显存也越多。拿不准选哪个时,优先按运行软件推荐或选 Q4_K_M 均衡版。
部分大体积模型的文件名带有 00001-of-00003 这类分片编号,说明完整权重拆成了多份文件。遇到分片模型必须把整套分片全部下载齐全,只下载其中一份无法加载。
日常使用时,建议优先在支持该模型的图形界面软件内直接搜索下载。软件会自动管理分片文件与存放目录,省去手动核对路径的麻烦;只有在需要指定特殊量化版本时,再去网页端手动下载。
3. 把模型交给本地软件
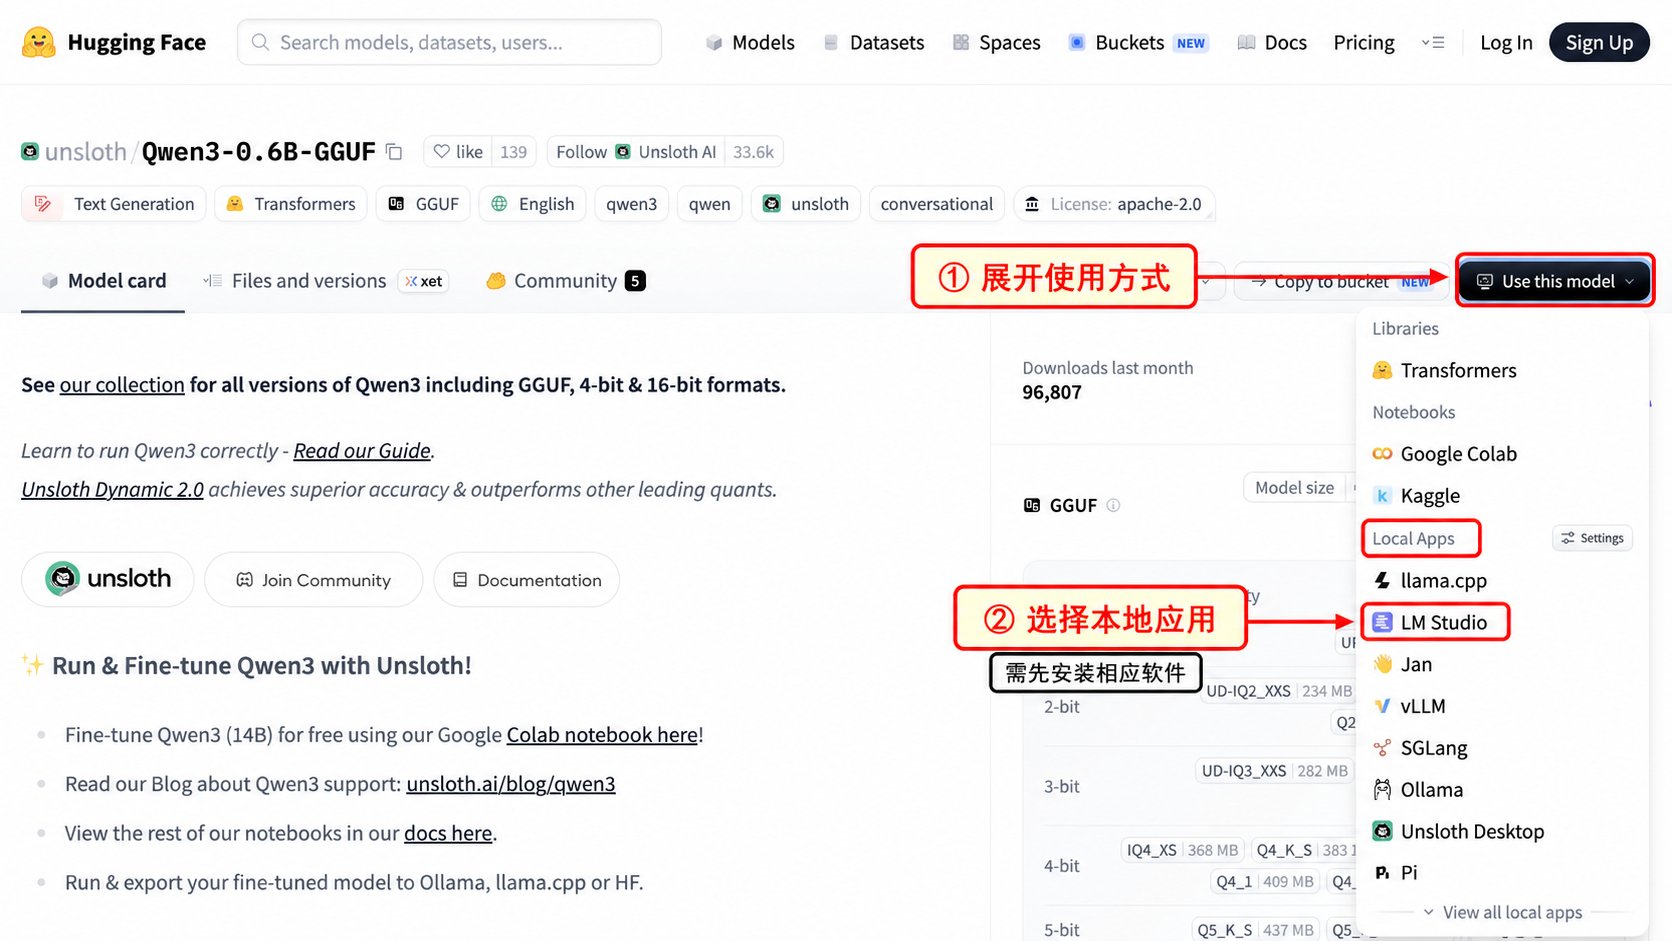
回到模型详情页右上角,点击黑色的 Use this model 按钮。
 把模型交给本地软件
① 点击 Use this model 展开调用菜单。
② 在 Local Apps(本地应用)栏找到 LM Studio 等客户端。电脑上已安装对应软件时,点击该项即可唤起软件定位到该模型。
如果点击后没有反应,请检查本地是否已安装该客户端,以及浏览器是否拦截了外部协议弹窗。
你也可以直接打开 LM Studio 的模型搜索界面,粘贴 Hugging Face 上的“发布者/项目名”或详情页网址,在软件列出的兼容量化版本里直接点击下载。
上述流程适用于 LM Studio 或 Ollama 支持的本地语言模型。图像生成与视频模型需要使用 ComfyUI、Diffusers 等对应的视觉工具加载。
4. 如何判断电脑配置是否够用
硬盘空间只决定能不能存下文件,实际推理速度取决于显卡显存(VRAM)或统一内存容量,上下文长度和输出分辨率也会推高内存占用。看到一个 4 GB 的模型文件,不能只看硬盘还剩多少空间,还要核对显存要求。
先看本地客户端给出的硬件兼容性提示和模型说明里的显存建议,初次测试从小参数版本跑起。拿不准硬件能否带动时,先去对应的 Space 在线试效果,不必急着往本地下载。
七、Datasets:先看样本再决定下载
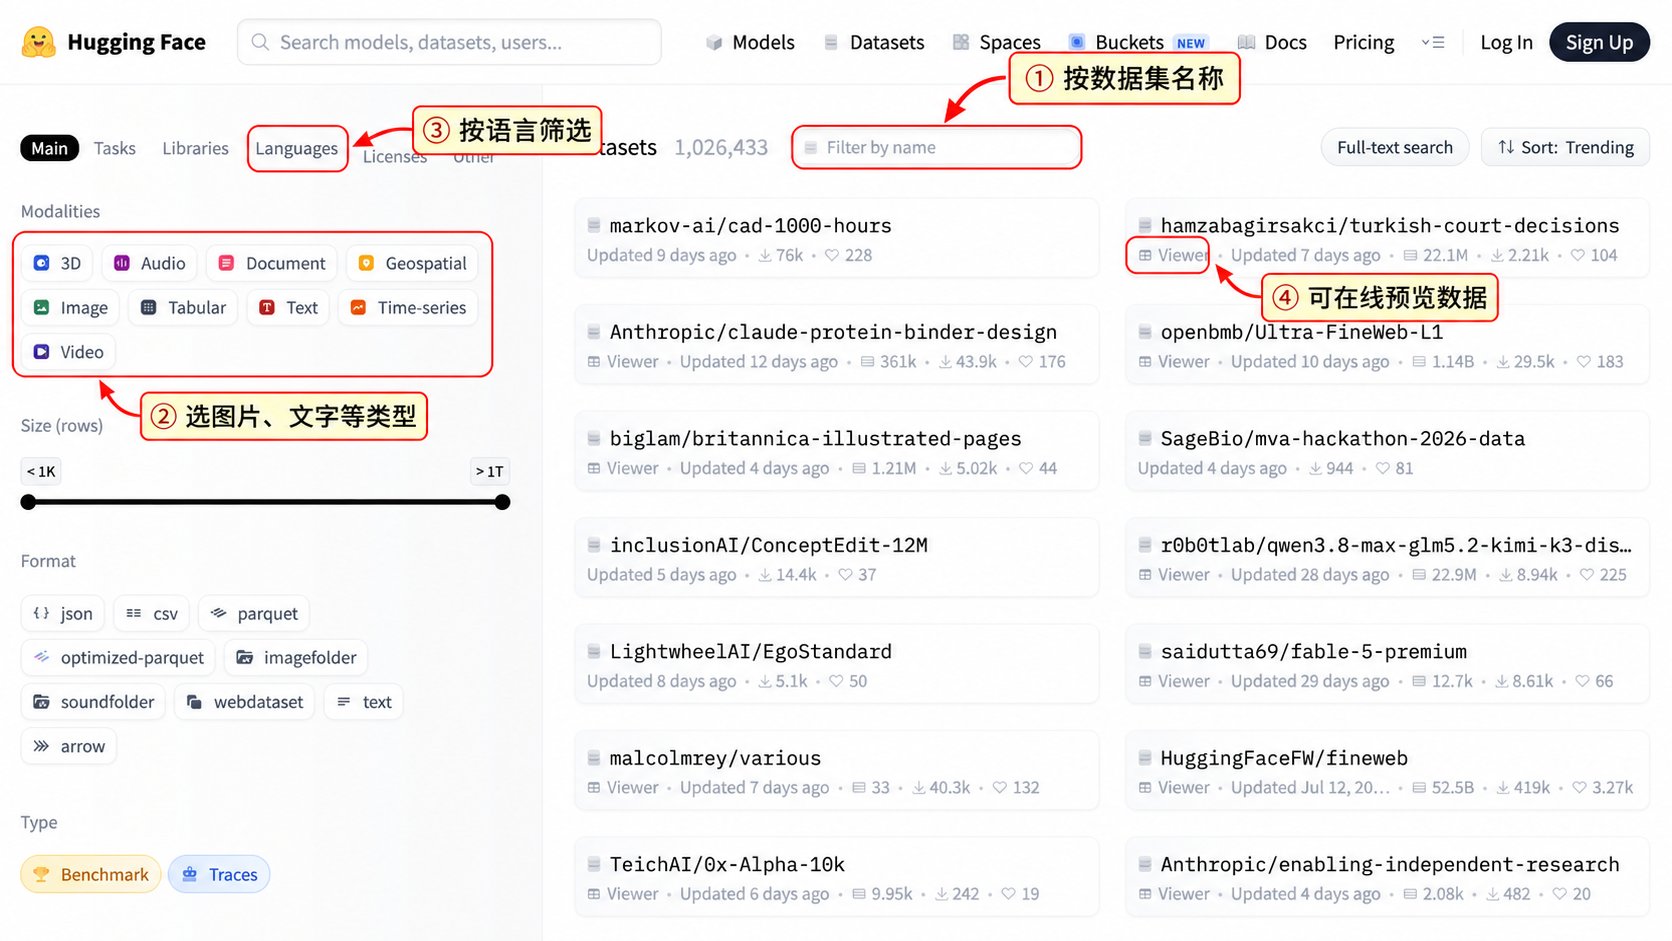
点击顶部导航栏的 Datasets,进入开源数据集目录。
数据集是按固定结构整理好的成批数据,常见形态包括图片、文本、表格和音视频,通常还附带人工或程序标注的解释、参考答案与分类标签。
例如一张植物叶片照片配上一条“健康”或“病害名称”的标签,就构成一条训练样本;一个用户提问配上一条标准回答,也是一条样本。成千上万条同类样本汇总起来,就是一个数据集。
 Datasets 数据集目录
① 名称搜索框:知道准确数据集名称时直接输入检索。
② Modalities:按数据模态筛选。Image 是图片,Text 是文本,Video 是视频,Tabular 是结构化表格。
③ Languages:按语种筛选。寻找中文指令微调或问答语料时,可先勾选中文(zh)。
④ Viewer 标记:卡片上带有 Viewer 字样,代表支持在网页端直接翻页预览真实样本,无需先把整个数据包下载到本地。
1. 打开数据集先看样本结构
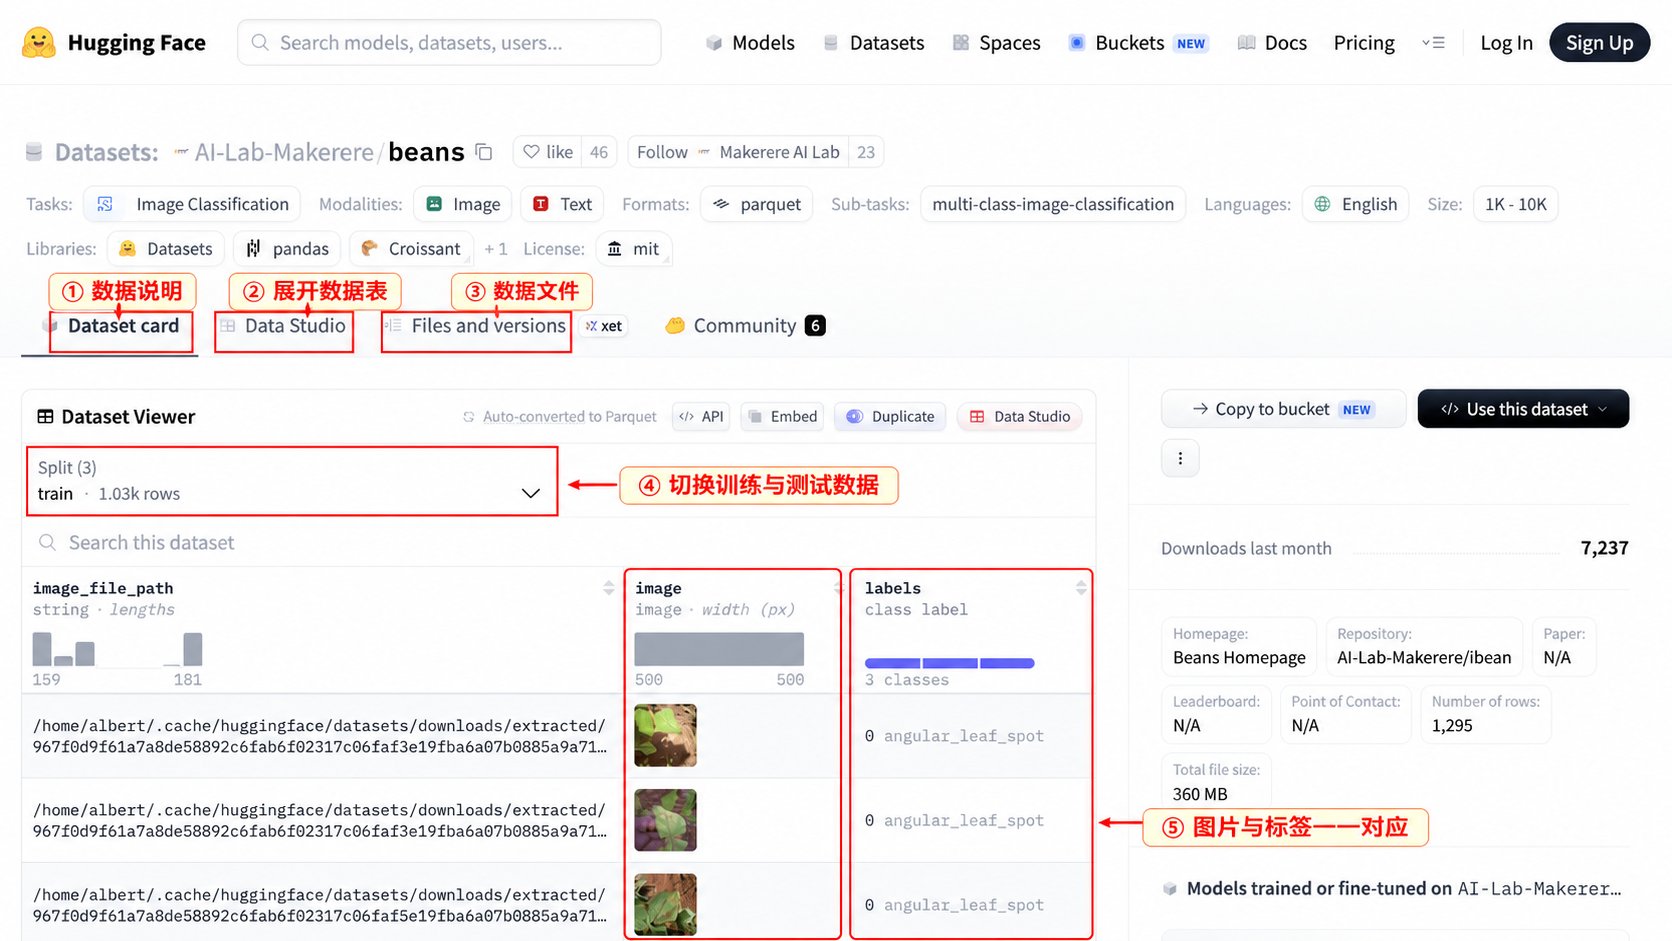
打开 Makerere AI Lab 的 beans 数据集。该数据集收录了豆类作物叶片照片及对应的病害分类标签。
 打开数据集先看样本结构
① Dataset card 是数据集说明文档;② Data Studio 用于全屏浏览和检索样本;③ Files and versions 存放原始数据文件。
页面中部的表格直接展示行样本:image 列是叶片原图,labels 列是分类标签,同一行左右对照即可看清标注关系。
④ Split 用于切换数据子集:train 是训练集,validation 是训练中途调参用的验证集,test 是最终评估用的独立测试集。
⑤ 对照检查图片与标签:图像分类任务既要图片清晰,也要标签准确,模型才能学到正确的对应关系。
换成电商商品数据场景,每一行样本可能是商品实拍图配上品类、材质属性或卖点文案。挑选数据集时,先看它的字段结构与标注质量是否贴合你的业务目标。
2. 使用 Data Studio 在线预览数据
点击 Data Studio 会打开交互式数据浏览视图。只要底层数据格式兼容,你就可以直接在网页上翻页、按关键词搜索文本、按字段过滤,并查看各列的统计分布。
看文本问答数据集时,先随机翻十几条,检查提问是否自然、回答是否准确完整。看图像数据集时,重点观察分辨率高低、画面构图类型、是否存在大量重复图,以及配文描述有无错漏。
部分数据集无法在线预览:有的需要先点击同意门禁协议(Gated Dataset),有的采用了自定义压缩格式,或者后台正在构建预览索引。遇到这种情况,先回 Dataset card 阅读访问要求,再去文件列表确认具体格式。
3. 如何判断数据集是否值得下载
评估数据集时,先看几十条真实样本的单条质量,再看总条数规模。 准备做中文业务问答,就重点看提问是否贴近真实用户、答案有无事实错误、出处能否溯源。内容质量过关后,务必核查数据的商业授权条款,网页公开可看并不等于允许直接商用。
确认可用后,进入 Files and versions 按说明下载对应的数据文件。不同仓库可能存为 Parquet、JSONL 或 CSV 格式,只挑你需要的子集下载即可,无需拖回整个仓库。
即使当前不训练模型,浏览成熟数据集也能帮你理清内部知识库的整理规范。例如把“用户问题、标准答案、文档出处”拆成三个独立字段存储,后续做检索增强(RAG)时每条回答都能准确核对依据。
八、查找特定风格的微调模型与 LoRA
想让生成的图片固定成某种插画风格,或者让模型严格输出指定 JSON 结构,通常会用到微调(Fine-tuning)。微调是在预训练基础模型之上,用一批特定领域的样本继续训练,使输出向目标方向收敛。
在 Hugging Face 上可以先搜社区训练好的现成微调版。打开模型详情页时留意右侧或说明里的 Base model 字段,确认它基于哪个基础模型衍生;展开 Model tree 还能顺藤摸瓜看到同一底座下的其他量化与微调分支。
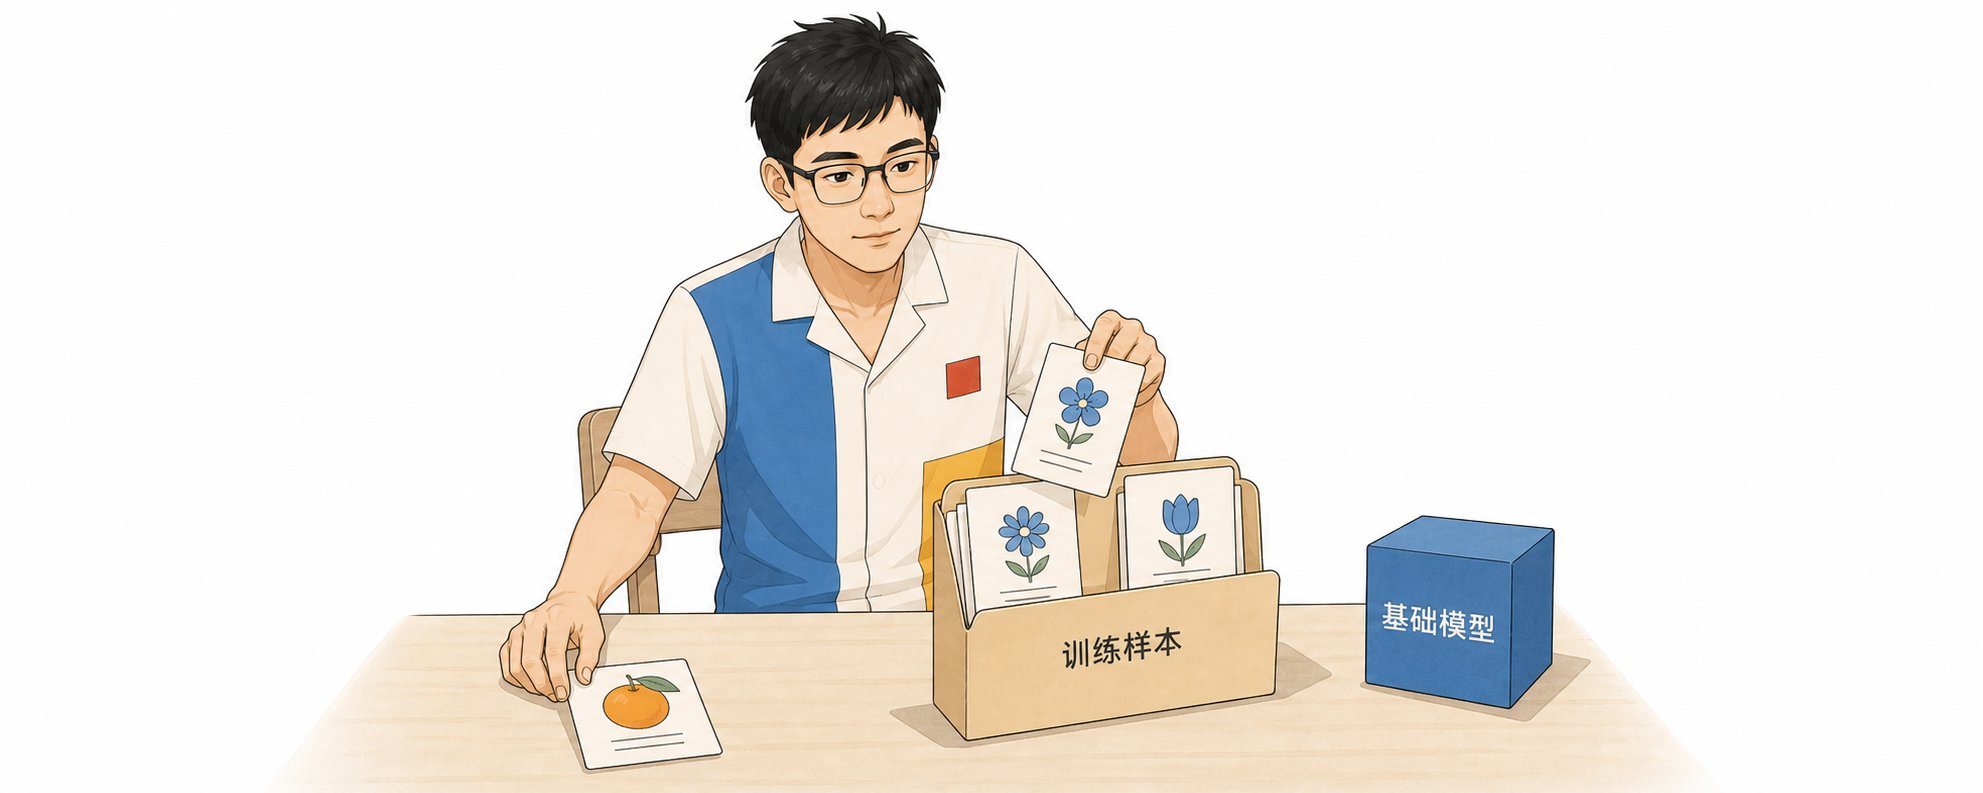 查找特定风格的微调模型与 LoRA
AI 绘图教程里常见的 LoRA 是一类体积较小的增量权重文件,必须挂载到指定的基础模型上才能生效。下载 LoRA 前务必核对三件事:适配哪个基础模型版本、是否需要输入特定的触发词(Trigger words)、作者推荐的权重强度范围是多少。只下载一个 LoRA 文件无法独立出图。
建议把基础模型和配套 LoRA 收进同一个收藏夹,并在备注里记下触发词与推荐权重,比单存一张效果图实用得多。加载 LoRA 和调节强度均在 ComfyUI 等本地绘图软件中完成。
当社区现成模型无法满足需求时,再考虑自行微调。先准备好版权合规的高质量样本,选定支持目标架构的微调框架;训练结束后,用未参与训练的独立测试样本检验泛化效果。
九、用 Collections 按主题整理资源
跟进一个图像处理项目时,你可能会陆续打开底座模型、在线 Space 演示、评测数据集和原始论文。把这些链接零散塞进浏览器书签栏,过两周就很难分清它们的对应关系。
Hugging Face 内置的 Collections 支持把跨类型的资源按同一主题打包管理。
同一个 Collection 里可以混装模型、数据集、Space 应用和论文,还支持为每个条目单独写备注。你可以建一个“电商修图工具箱”集合,把抠图 Space、超分放大模型和背景生成 LoRA 放在一起;再建一个“本地中文对话模型”集合,集中存放备选的 GGUF 仓库与配置要点。
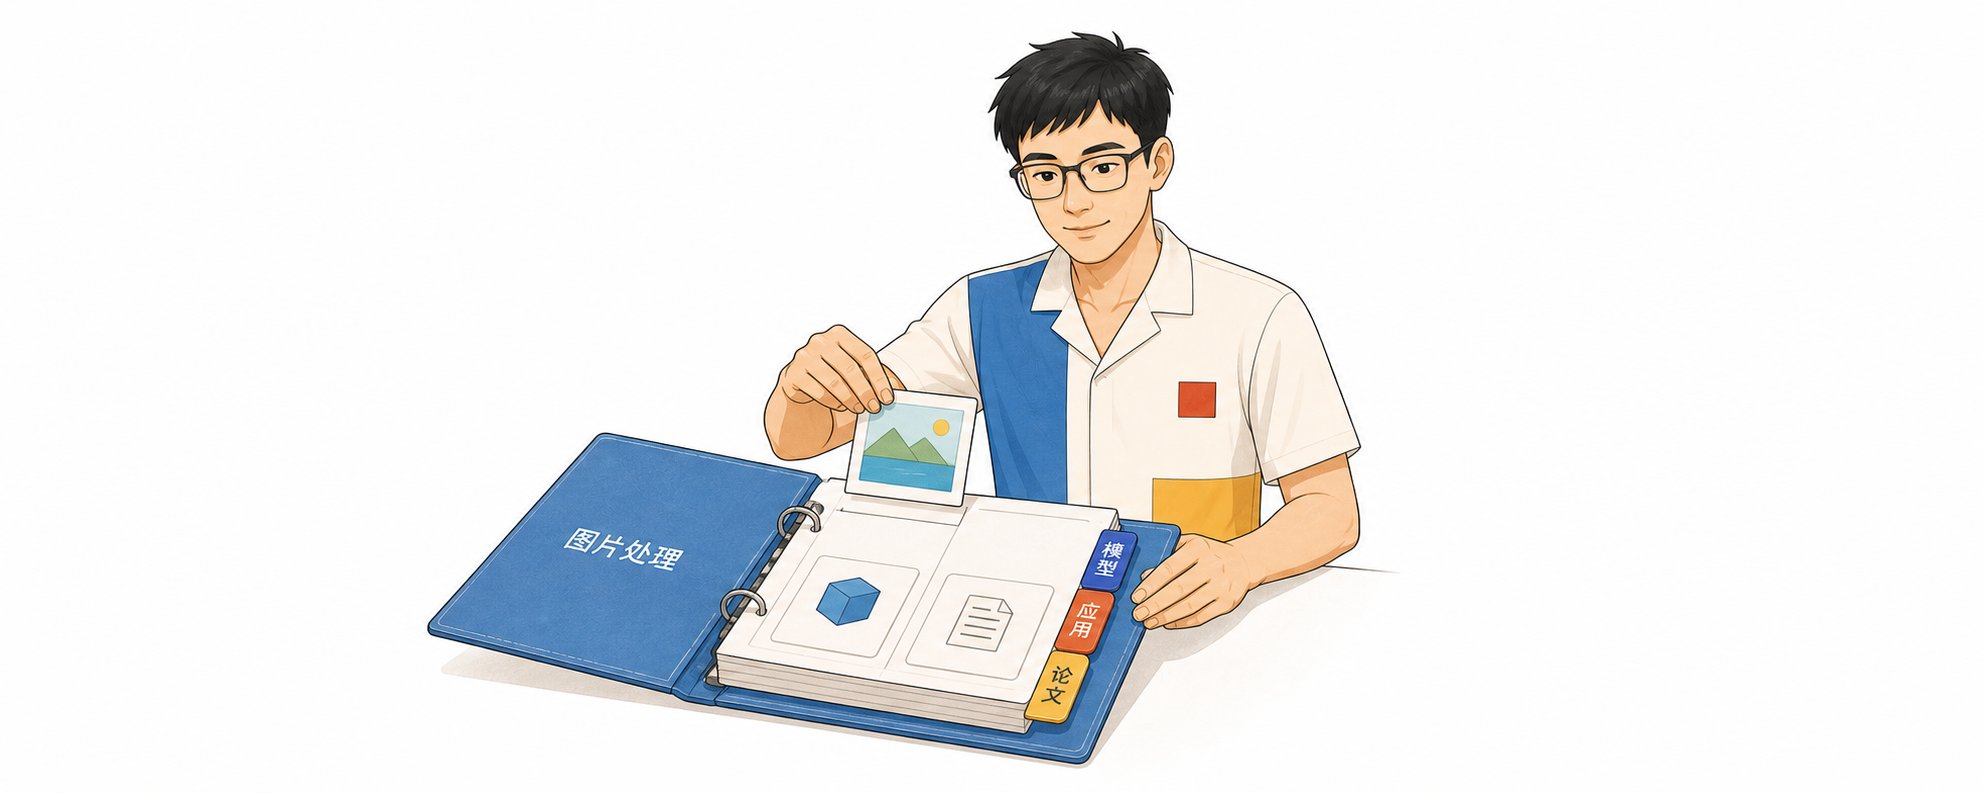 用 Collections 按主题整理资源
1. 先看别人怎么整理
从首页更多菜单点进 Collections,或顺着模型页上的关联入口打开官方团队维护的集合,例如 Unsloth 的 Qwen3 集合。
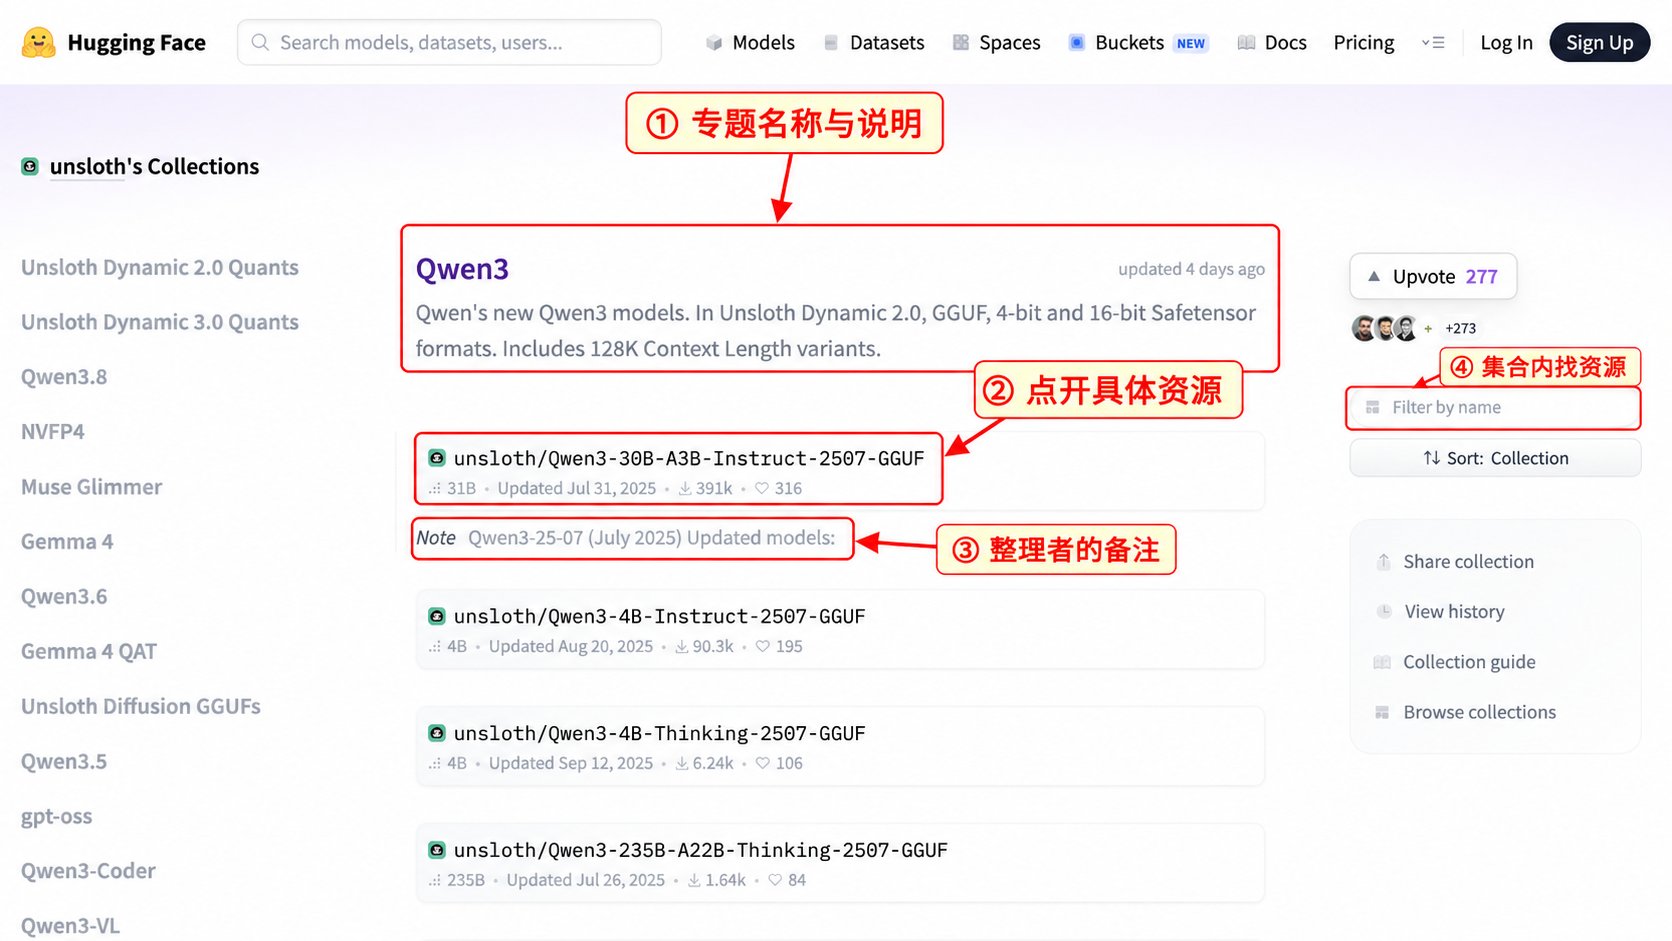 先看别人怎么整理 Collections
① 顶部标题与简介说明该集合收录的主题范围;
② 下方每张资源卡片均可直接点进对应仓库;
③ Note 展示整理者为该条目添加的使用说明;
④ 右侧搜索框支持在当前集合内部按名称快速过滤。
官方机构发新模型时,通常会同步建一个同名 Collection,把不同参数规模、量化版本与在线 Demo 全部归拢在一处。顺着官方集合找版本,不容易漏掉配套资源或下错旧仓库。
2. 把资源加入自己的集合
登录账号后打开任意模型、数据集或 Space 页面,找到右上角的三个点菜单按钮。
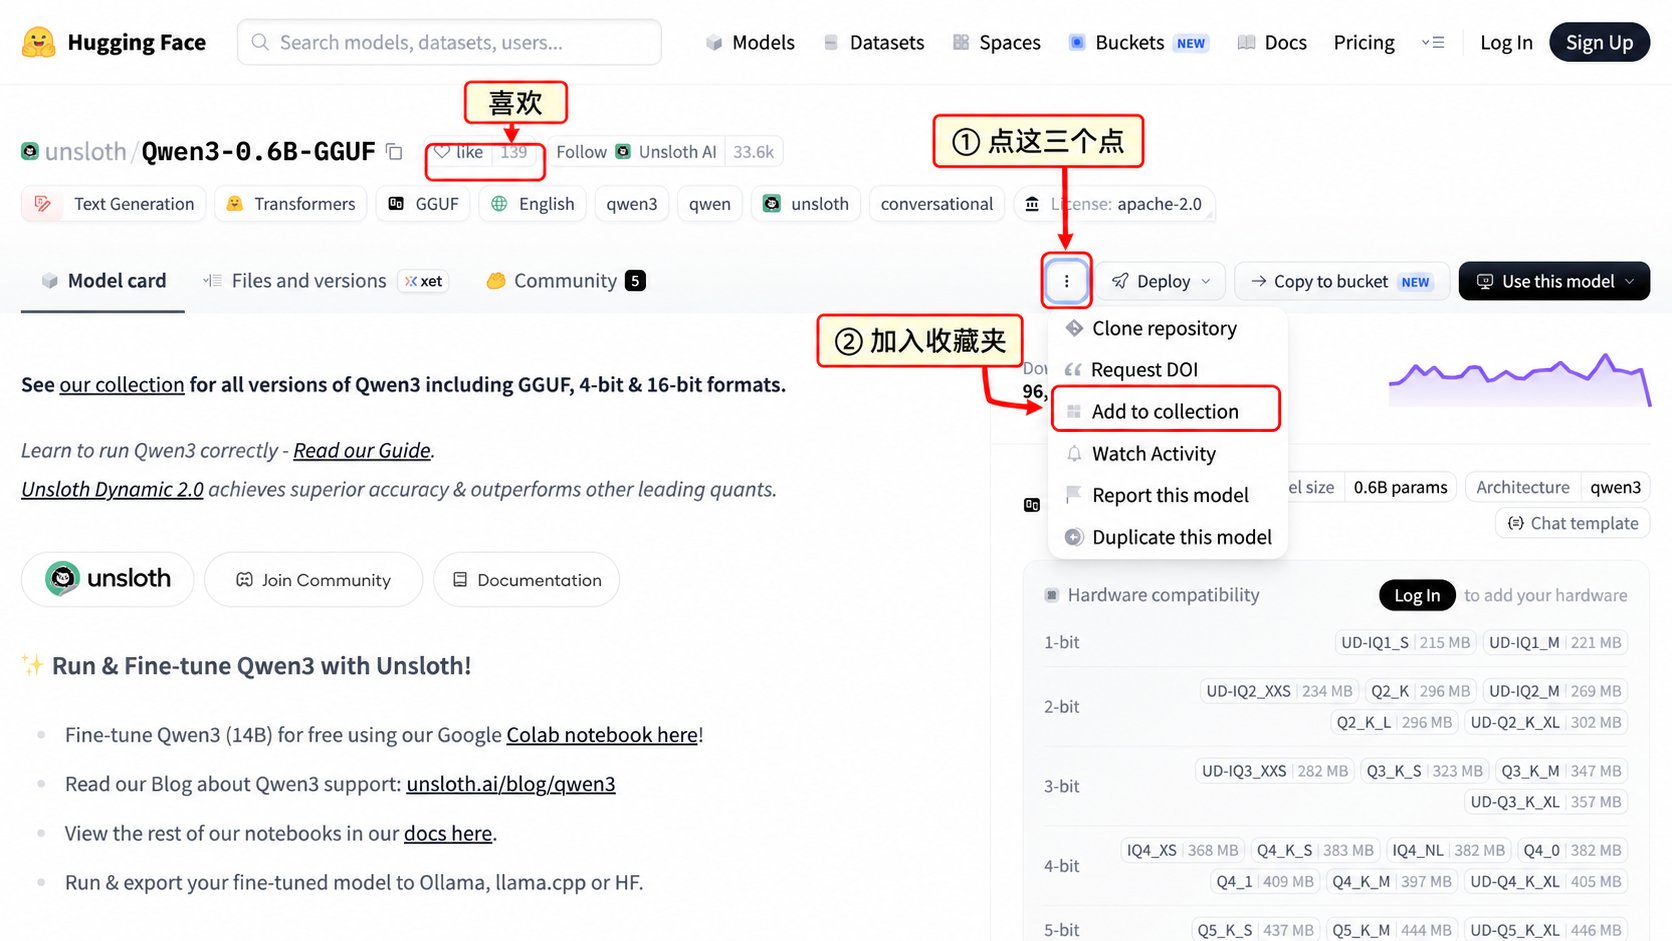 把资源加入自己的集合
① 点击右上角的三个点按钮;
② 选择 Add to collection,即可将当前仓库归入已有集合,或现场新建一个集合。
页面顶部的 Like(心形点赞)适合顺手标记单个项目;需要按项目或业务场景归档多类资料时,用 Collections 结构更清晰。
集合名称建议直接按具体任务命名,例如“商品抠图与换背景”“16GB 内存本地对话模型”,日后检索一目了然。
条目备注尽量写清操作细节,例如“在 LM Studio 选 Q4_K_M 版”“需搭配 Flux.1-dev 底座,权重设 0.8”。下次打开集合就能直接复用,不用重读一遍英文文档。
创建集合时注意核对可见性权限(Public 或 Private)。公开集合里的所有条目与备注对全网可见,不要在公开集合备注里写入客户名称、内部业务数据和未公开的产品计划。
十、Papers:从论文找到模型和应用
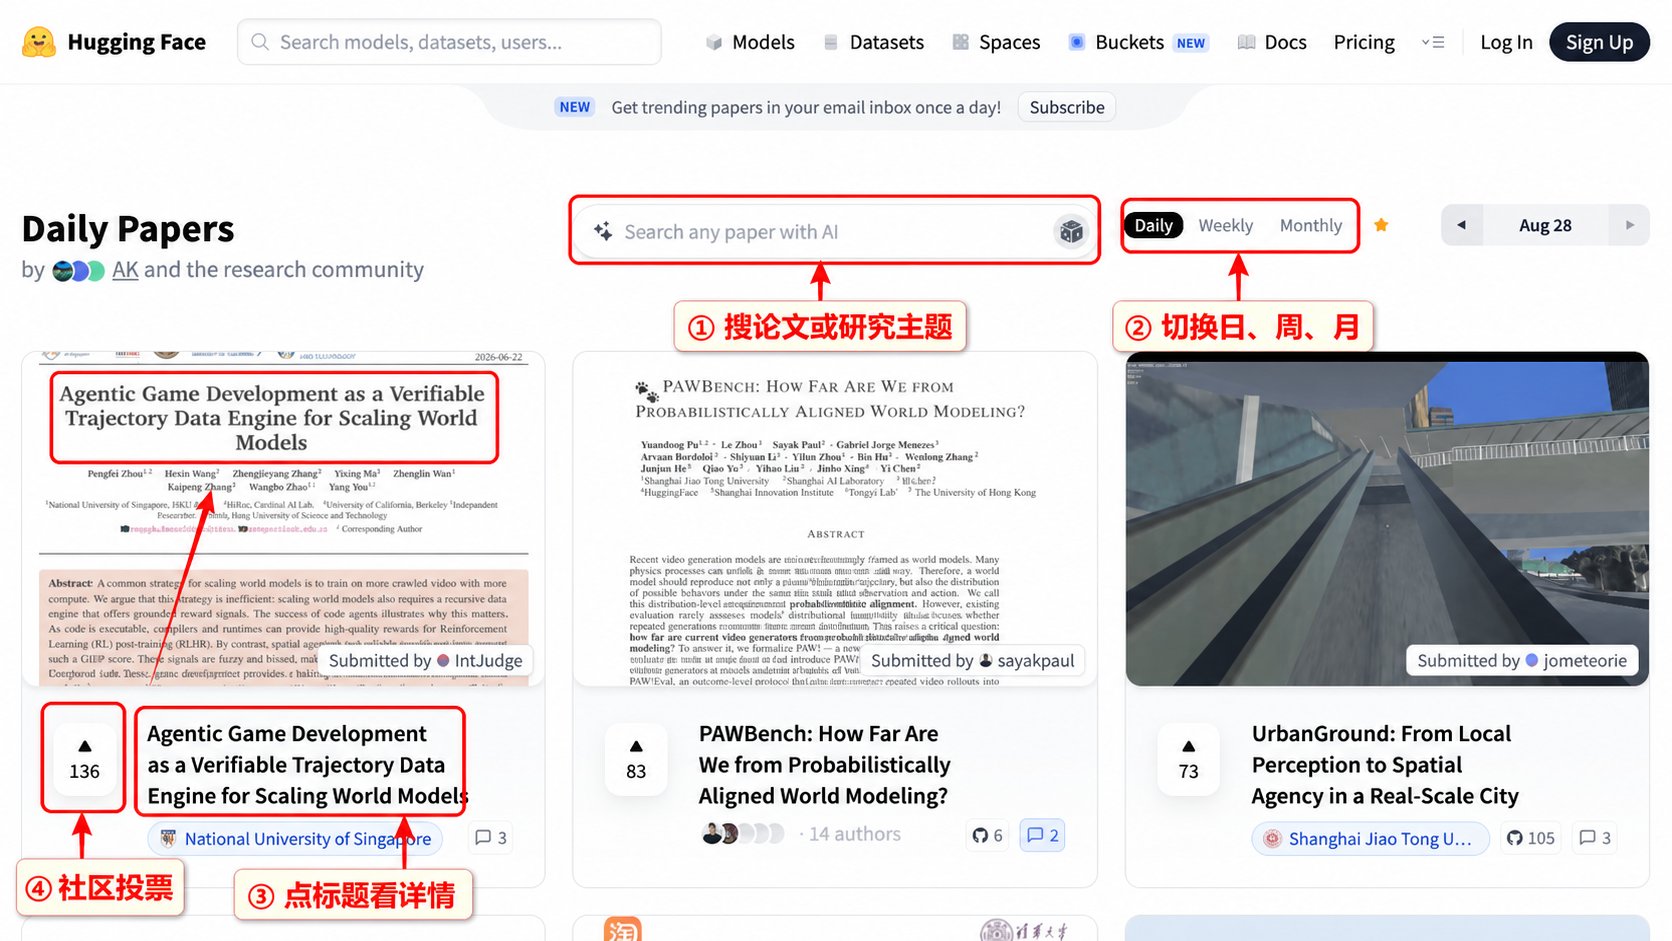
展开首页更多菜单,点击 Daily Papers,进入 论文页面。
 Papers 从论文找到模型和应用
① 搜索框支持按论文标题或研究方向检索;
② Daily、Weekly 和 Monthly 分别按日、周、月汇总热门论文;
③ 点击论文标题进入摘要与关联资源详情页;
④ 卡片旁的数字与向上箭头显示社区投票热度。
投票高低只代表近期社区关注度,不代表论文实验已经过第三方严格复现,也不能直接当作模型综合能力排名。
平时在社交媒体刷到某个惊艳的视频或图像生成演示,只要拿到论文标题,就可以来 Papers 搜索原文,再顺着论文详情页找到官方代码库、开源权重和在线 Space。
打开论文后重点看哪些内容
第一步先读标题与摘要(Abstract),明确作者针对什么具体任务提出了什么改进。
第二步看配图与实验对比表,留意测试输入条件和评估基准。某个模型在单一公开基准上得分更高,不代表放到你的业务数据上同样表现最好。
第三步在页面右侧或顶部寻找 Project Page、GitHub、Models、Datasets 和 Spaces 等关联入口。部分关联仓库由社区热心用户补充绑定,下载前记得核对发布账号是否为论文原作者团队。
不同论文开源的完整度差别很大:有的只发了论文 PDF,有的放出了训练代码但未公开模型权重,有的挂出了在线 Space。想动手实测,就优先找已公开权重的 Models 或处于 Running 状态的 Space;暂未开源的项目可以先加入收藏。
阅读英文摘要可配合翻译软件,重点确认三项事实:这项技术解决了什么问题、要求输入什么格式的数据、在哪些边界条件下容易失效。
用大模型辅助读论文时,请把论文 PDF 或摘要原文完整喂给它,并要求每一条总结注明原文段落依据。只丢一个论文标题让模型凭记忆发挥,很容易编造出与原文不符的参数细节。
测试后觉得有价值的论文,可以连同它对应的模型仓库和 Space 一起收进同一个 Collection,方便后续随时回溯复现。
十一、Learn:按主题选修官方课程
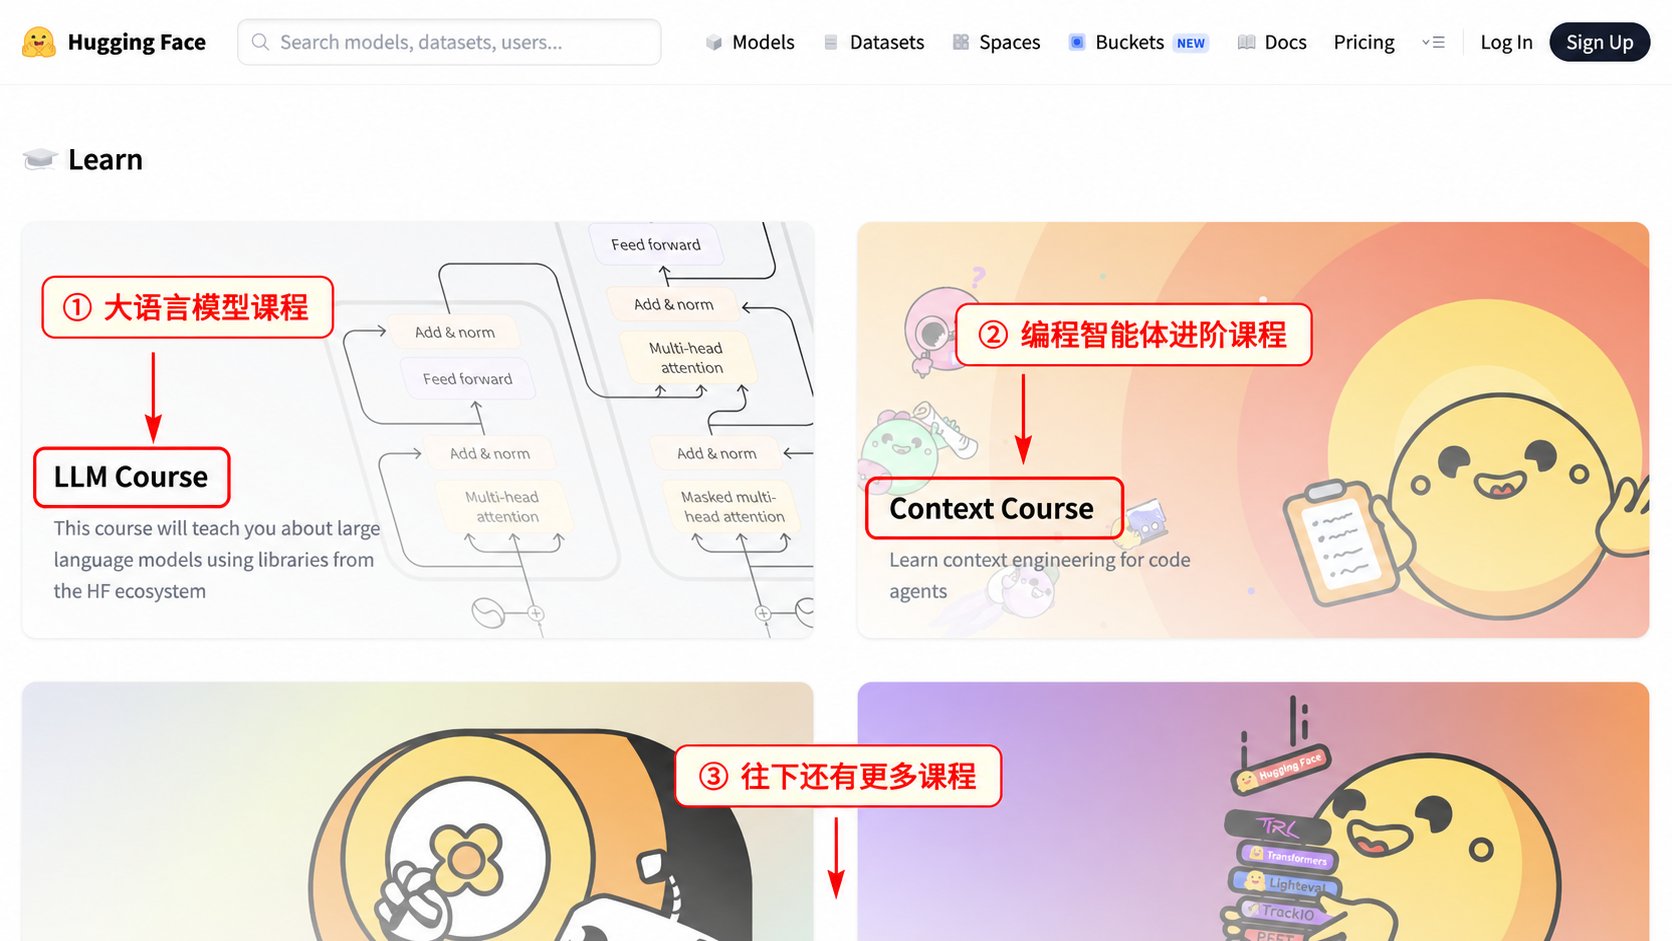
展开首页更多菜单点击 Learn,即可进入免费的 Hugging Face 课程目录。
 Learn 课程目录
① LLM Course:大语言模型原理、微调与推理实战课;
② Context Course:面向编程智能体的上下文工程课;
③ 向下滚动页面,还能看到智能体、扩散绘图、音频处理与强化学习等专题课程卡片。
想系统弄懂语言模型就看 LLM Course;想自己搭建调用工具的智能体就看 Agents Course;关注图像生成原理就选 Diffusion Course。建议先扫一眼目录,只挑与当前手头任务相关的章节阅读。
课程里的动手练习大多需要编写 Python 代码。只想理清技术概念,读前面的图文原理解析章节即可;准备跑通代码实验,再按章节提示配置 Notebook 环境。多门热门课程已内置官方中文翻译,可在章节侧栏切换语种,未翻译章节配合网页翻译阅读即可。
Learn 适合按专题系统学习,顶部导航栏的 Docs 则用于查阅具体库函数与平台按钮说明。遇到某个参数不知道怎么填先查 Docs,想搞懂背后的工作原理再去翻 Learn。
日常使用 Hugging Face 可以固定成三步动作:先去 Spaces 在线试效果,觉得可用再去 Models 找适配本地硬件的权重版本,最后把好用的应用、模型和配置要点收进同一个 Collection。下次遇到同类需求,直接打开你的收藏集合就能上手。
作者 Miles(@miles_mazy),AI 算法专家与 FDE,长期从事算法研发、推理优化部署、企业培训与项目交付。
 Miles Ma 个人名片与微信
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。