
Gemini 4 Argon 实测:3D 建模、复古 UI 与物理动效横向对比
作者: 数字生命卡兹克 @Khazix0918•发布日期: 2026-10-14 09:02•阅读时长: 约 12 分钟•大模型实测 · 深度横评
 实测 Gemini 4 Argon:Google 前沿大模型评测
图 1:Gemini 4 Argon 实测对比
核心实测结论速览
自费 100 美元升级 Google Ultra 会员实测数小时后,结论很明确:Gemini 4 Argon 仍难动摇 Claude Opus 5.5 与 GPT-6 Astra 的第一梯队地位。它的长板集中在金融、法律、税务等行业知识任务(Vals Index 综合得分 68.9%,排名第一)。短板同样突出:电脑操控能力垫底(CUA-bench 仅 4.83%,倒数第二),Antigravity 额度消耗极快,中文直出也带有明显的翻译腔。
能力排序:知识工作 > 科研 > 写代码 > Agent 能力
成本与额度:AA 单任务均耗 $1.99(Sol 仅 $0.72),Ultra 跑不到 10 个任务即耗尽 5 小时限额
当前主力订阅:Claude Opus 5.5(工程构建主力)+ ChatGPT Pro(日常通用)
今晚,Gemini 4 Argon 正式面向公众开放。
Google官方认证@Google · 2026-10-14
官方推文
今天,Gemini 4 Argon 正式推出。(Today, Gemini 4 Argon is officially rolling out.)
269 回复 · 1,333 转帖 · 8,864 喜欢 · 67.7 万次观看
10 月 1 日(OpenAI DevDay 次日),Google 就已经发布过一次 Gemini 4 Argon。当时该模型仅向名为 Fairwind 的网络安全计划定向开放,使用方主要是政府机构、关键基础设施与安全防守团队,普通开发者无法调用。
时隔两周,Google 今天终于开放了全量访问。过去一个多月,海外前沿大模型密集发版,整体时间线如下:
2026 年 9 月~10 月前沿大模型发布时间轴
- 09-04GPT-6 Astra 发布
- 09-22Grok 4.7 发布
- 09-23Claude Opus 5.5、GPT-6 Sol 和 Luna 同晚发布
- 09-30OpenAI DevDay,GPT-6.1 Sol 发布
- 10-01Gemini 4 Argon 首次官宣(仅限 Fairwind 安全计划)
- 10-13Meta 首个前沿模型 Muse Wonder 发布
- 10-14Gemini 4 Argon 全面开放
海外主流大厂的新一代模型基本到齐。从实测表现看,Anthropic 稳居第一梯队,OpenAI 紧随其后,Meta 与 Google 处于追赶位置,Grok 4.7 则明显掉队。
我已经很久没给 Gemini 充值了。今晚特意花 100 美元升级了 Google Ultra 会员,实测 Gemini 4 Argon 的真实水位。
 升级 100 美元 Google Ultra 会员实测 Gemini 4 Argon
图 2:花 100 美元升级 Google Ultra 会员实测 Gemini 4 Argon
连续测了几个小时,Gemini 4 Argon 依然很难撼动 Claude Opus 5.5 和 GPT-6 Astra 的主力位置。下面按模块拆解具体表现。
一、Google 过去大半年的动荡
聊 Argon 之前,先回顾 Google 过去大半年的变故,能看清这个模型背负的压力。
去年 11 月 Gemini 3 Pro 发布时,综合实力稳居全球前列。但随后的大半年里,Google 的模型研发节奏屡屡受挫。
今年 2 月 Google 推出小改款 Gemini 3.1 Pro,又在 5 月 Google I/O 大会上承诺一个月内发布 Gemini 3.5 Pro。结果发布时间一再推迟,内部进度落后数月,核心卡点是代码生成能力达不到预期指标。面对 Anthropic 和 OpenAI 的步步紧逼,Google 最终直接砍掉了 3.5 Pro。
8 月 5 日,Google AI 核心管理层迎来人事变动。哈萨比斯(Demis Hassabis)卸任 Google DeepMind CEO,转任 DeepMind 董事长兼 Alphabet 首席科学家,CEO 一职由科雷(Koray Kavukcuoglu)接任。
同一天,在 Google 工作了 27 年的 Jeff Dean 宣布离职创业。Jeff Dean 于 1999 年加入初创期的 Google,早年与搭档桑杰(Sanjay Ghemawat)结对写出了支撑 Google 基础设施的 MapReduce、BigTable 和 Spanner。
2011 年,他参与创立 Google Brain,随后带队研发 TensorFlow。Google Brain 与 DeepMind 合并后,他出任首席科学家并担任 Gemini 核心技术负责人。Google 曾专门为他和桑杰设立最高工程职级 Level 11。
程序员社区流传近 20 年的 Jeff Dean Facts 段子集就是专门调侃他技术实力的,例如“编译器从不给 Jeff 报警告,只有 Jeff 给编译器报警告”。这次桑杰也随他一同离职。
SemiAnalysis 评论:Gemini is Cooked but GCP is Cooking
两天后,半导体研究机构 SemiAnalysis 发文《Gemini is Cooked but GCP is Cooking》(Gemini 掉队了,但谷歌云正火热)。Google 把大批 TPU 算力租给 Anthropic 等竞争对手,自家旗舰模型难产,算力租赁收入反而一路走高。
这大半年里,Google 只能靠轻量级的 Flash 系列维持更新频率,从 3.5 Flash 一路发到 9 月 2 日的 3.8 Flash。这就好比 OpenAI 发不出旗舰 Astra 只能连发小模型 Luna,Anthropic 发不出旗舰只能连发 Haiku。
因此,Gemini 4 Argon 承担着 Google 重返旗舰牌桌的关键任务。
二、基础规格:会员权限划分、续写协议与 API 定价
Gemini 4 Argon 目前已上线。月费 20 美元的 Pro 会员可在 Gemini 网页端与移动端 App 内直接调用。
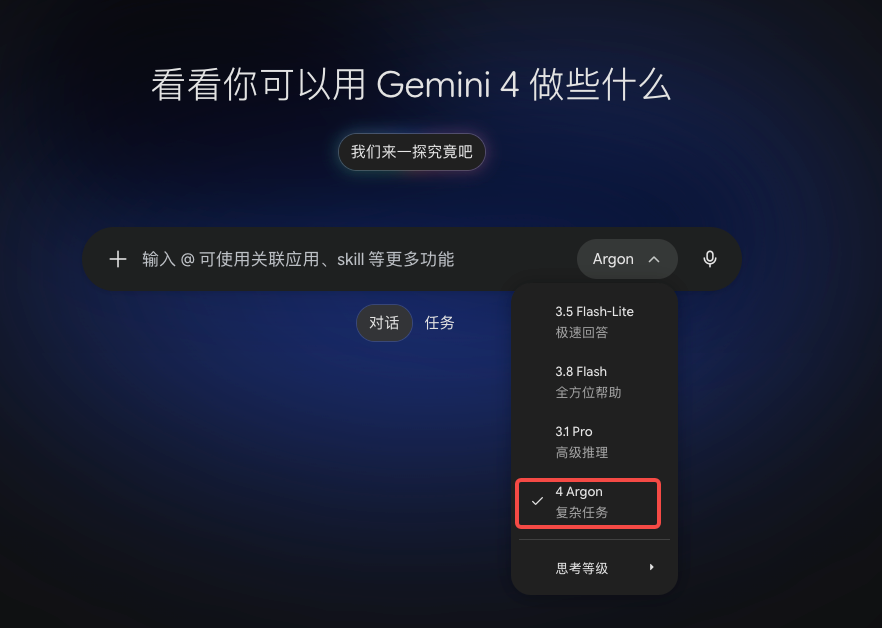 Gemini App 内使用 Gemini 4 Argon
图 3:$20 Pro 会员可在 Gemini App 网页与移动端内调用 Gemini 4 Argon
但如果你想在 Google 自家的编程工具 Antigravity(对标 Claude Code 与 Codex)里调用 Gemini 4 Argon,必须开通月费 100 美元的 Ultra 会员。这一权限限制引发了大量开发者不满。
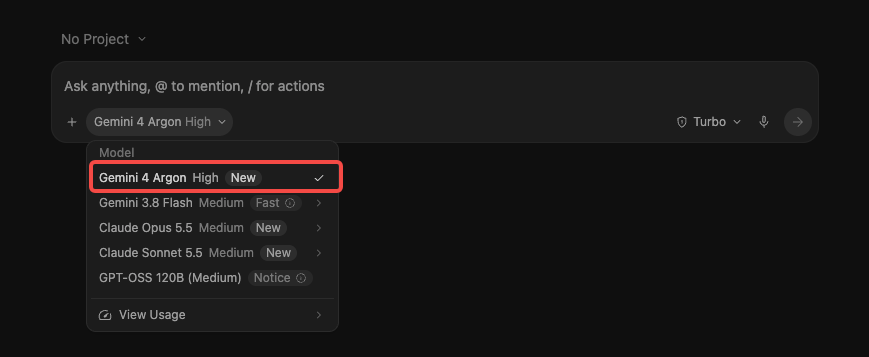 Antigravity 中仅限 Ultra 会员访问 Gemini 4 Argon
图 4:在 Antigravity 编程工具中调用 Gemini 4 Argon 强制要求 $100 Ultra 会员
Mr Ash@ash_twtz · 引用 @sundarpichai
社区吐槽
“Google 的做法令人失望。Antigravity 里的 Gemini 4 Argon 仅向 Ultra 会员开放,Pro 用户只能在 Gemini 聊天应用里用它。难道 Google 指望月付 20 美元的开发者在网页聊天框里写代码?OpenAI 和 Anthropic 在 20 美元档位都开放了各自的 IDE 编程工具……”
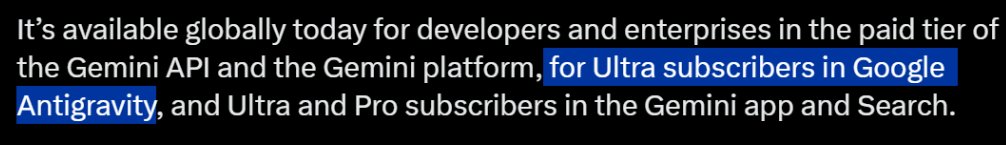 社区对 Gemini 4 Argon 锁死 Ultra 会员的批评
模型提供低、中、高三档推理强度,不过中文界面的机翻痕迹很重。
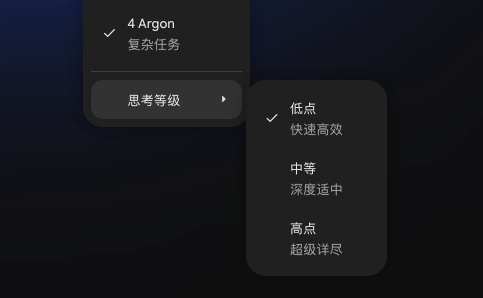 Gemini 4 Argon 推理强度三档设置界面
图 6:三档推理强度设置界面与生硬的中文翻译
延续 Gemini 系列的传统,Argon 原生支持视频、音频、图片和文本等多模态输入。知识库截止日期为 2026 年 3 月,早于 GPT-6 Astra 和 Claude Opus 5.5。
1. 上下文窗口与续写协议(Continuation Protocol)
上下文机制有一处关键改动。9 月 30 日预热时,Google 宣称输出上限从上一代的 6.4 万 Token 提升至 100 万 Token。今天正式文档改口为“输入与输出合计共享 100 万 Token”(含输入、推理思考和输出),并配套推出了续写协议 continuation protocol。
实际跑下来,Argon 单次请求最多仍只能输出约 6.4 万 Token,与上一代持平。触发单次上限时,接口不会直接截断报错,而是返回一个记录断点的加密续写令牌。开发者带上该令牌重发原请求,模型就能接着往下生成,多轮拼接最高可达 100 万 Token。相比之下,GPT-6 Astra 原生单次最大输出就能达到 128K Token。
2. API 价格与 Agent 缓存成本横向对比
API 定价目前处于优惠期(截至 11 月 30 日):输入 $2.0 / 百万 Token,输出 $10.0 / 百万 Token,与 GPT-6.1 Sol 和 Claude Sonnet 5.5 持平。12 月 1 日恢复原价后将翻倍至 输入 $4.0、输出 $20.0,对齐 Claude Opus 5.5。
在高频多轮调用的 Agent 场景下,真正的成本大头在于提示词缓存(Prompt Caching),各家单价对比如下:
| 模型名称 | 输入单价(每百万 Token) | 输出单价(每百万 Token) | 缓存命中单价(Cache Read) |
|---|---|---|---|
| Gemini 4 Argon | $2.0(12 月 1 日起 $4.0) | $10.0(12 月 1 日起 $20.0) | $0.10(12 月 1 日起 $0.20) |
| GPT-6.1 Sol | $2.0 | $10.0 | $0.10 |
| Claude Sonnet 5.5 | $2.0 | $10.0 | $0.10(10 月 7 日刚从 $0.2 降价) |
| Claude Opus 5.5 | $4.0 | $20.0 | $0.20 |
| GPT-6 Astra | 旗舰档 | 旗舰档 | $1.00 |
官方公布的基准跑分如下表所示,简单参考即可。
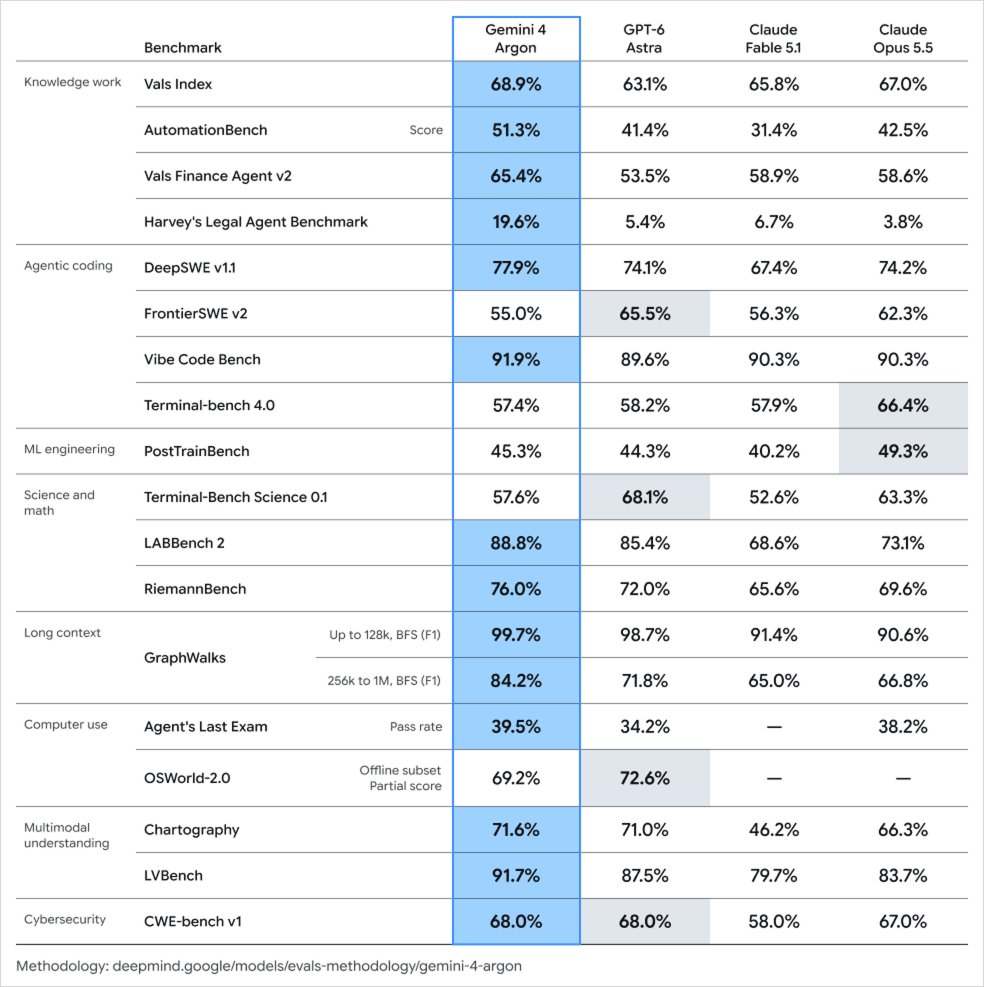 Gemini 4 Argon 官方基准跑分表
图 7:Google 官方公布的 Gemini 4 Argon 基准跑分对比表
三、第三方基准实测:行业知识占优,电脑操控垫底
比起厂商自测榜单,独立第三方评测更能反映真实水平。在 AA(Artificial Analysis) 综合榜上,Gemini 4 Argon 拿到 53 分,与 GPT-6 Astra 并列。
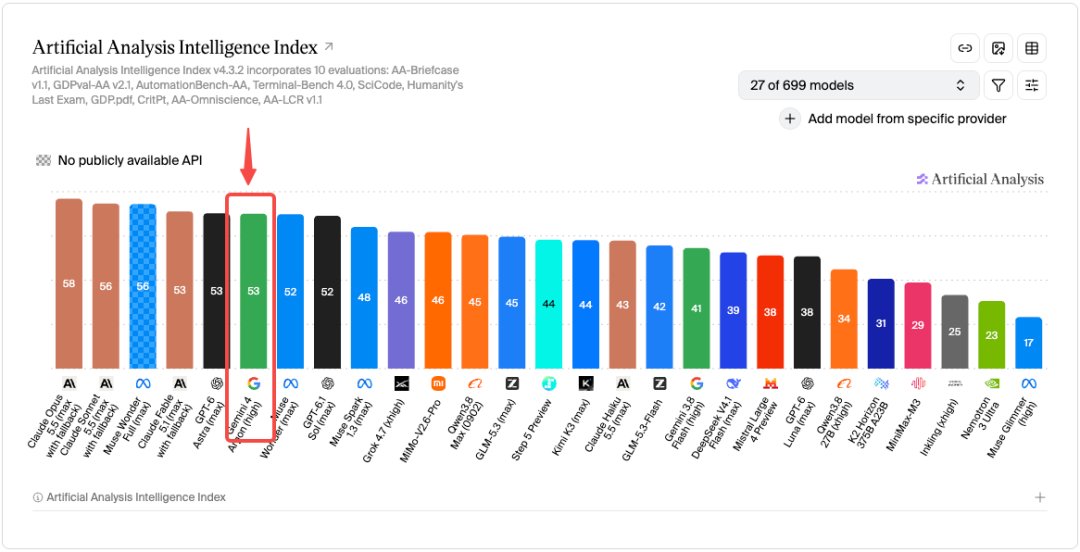 Artificial Analysis 综合指数:Gemini 4 Argon 53 分与 GPT-6 Astra 并列
图 8:Artificial Analysis 综合跑分:Claude Opus 5.5 第一,Sonnet 5.5 第二,Argon(53 分)与 GPT-6 Astra 并列
AA 综合分中编程与 Agent 权重较高,Claude Opus 5.5 稳居榜首,Claude Sonnet 5.5 位列第二。
AA 成本统计揭示了一个关键差异:完成整套评测,Argon 单任务平均耗时与 Token 折算成本高达 1.99 美元,而同单价的 GPT-6.1 Sol Max 仅需 0.72 美元。
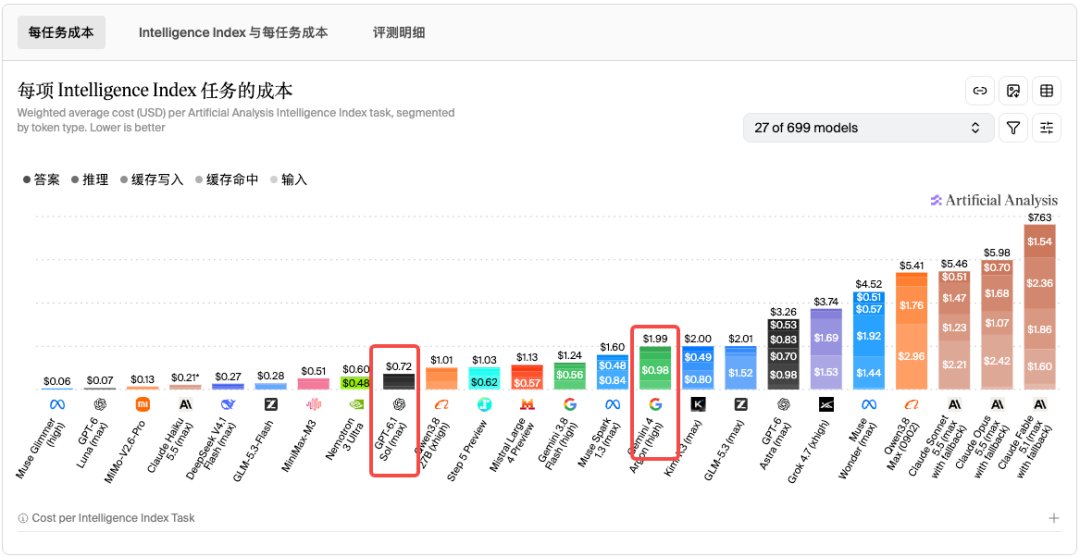 AA 综合测试单任务平均成本对比
图 9:同为 $2 / $10 API 单价,Argon 单任务平均消耗 $1.99,是 GPT-6.1 Sol Max($0.72)的 2.76 倍
两款模型当前的 API 单价完全一致($2 输入 / $10 输出)。Argon 单任务开销翻了近 3 倍,根源在于思维链和输出文本过于冗长。Claude 系列同样偏爱长思维链,但任务交付质量明显高出一截。
另一家第三方评测机构 Vals 主攻贴近真实业务的行业专业能力,涵盖金融、法律、税务、医疗和编程,本次对 Argon 运行了 26 项测试。
在涵盖金融、法律、税务的综合指标 Vals Index 上,Argon 以 68.9% 拿下总分第一,位于性价比帕累托前沿顶端。
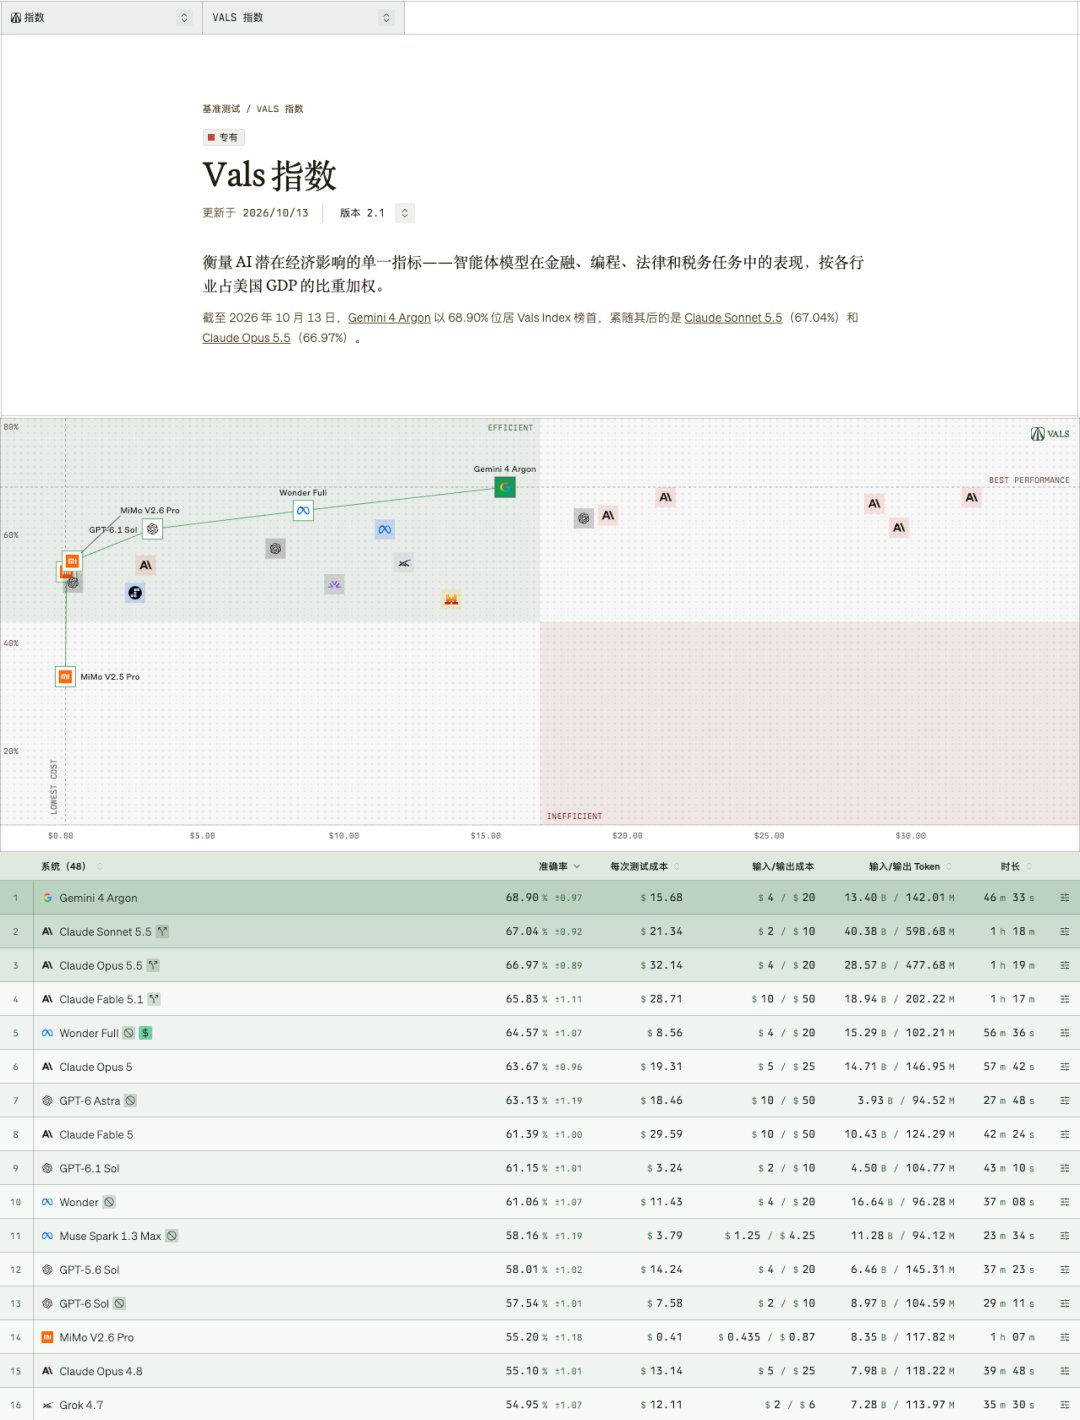 Vals Index 26 项行业专业能力评测:Gemini 4 Argon 68.9% 综合第一
图 10:Vals Index 行业基准评测:Gemini 4 Argon 以 68.9% 夺得第一,单次运行成本仅 $15.68
横向对比同场模型:Sonnet 5.5 得分 67.04%,Opus 5.5 得分 66.97%,Fable 5.1 得分 65.83%。单轮全套测试成本方面,Argon 仅耗费 15.68 美元,不到 Opus 5.5(32.14 美元)的一半,也低于 Sonnet 5.5(21.34 美元)和 Fable 5.1(28.71 美元)。细分科目里,Argon 在金融单项夺冠,法律、税务、医疗和编程均排在前列。
但到了测试桌面电脑操控能力的 CUA-bench,Argon 得分跌至 4.83%,在 8 款参测模型中排倒数第二(垫底的是自家的 Gemini 3.8 Flash)。同场 GPT-6 Astra 拿到 19.17% 居首,Claude Opus 5.5 以 14.00% 排第二,差距悬殊。
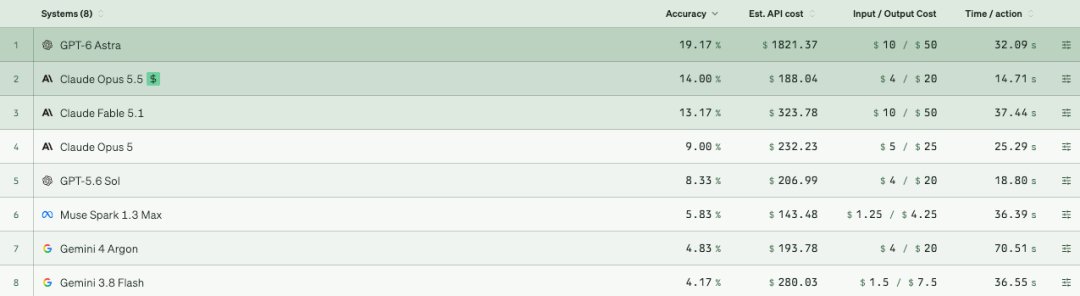 Vals CUA-bench 电脑操控评测:Argon 仅 4.83% 倒数第二
图 11:Vals CUA-bench 计算机操控评测:GPT-6 Astra(19.17%)第一,Argon(4.83%)排倒数第二
Gemini 4 Argon 实测能力排序
知识工作 > 科研 > 写代码 > Agent 能力
四、工程实测体验:Antigravity 额度消耗、前端对比与中文写作
Gemini 网页端的工具调用和长思考交互一直欠佳。这里重点测 Antigravity,它是 Google 对标 Codex 与 Claude 桌面端的编程工具。
1. 上线一年仍无中文语言设置
首先是界面多语言支持。Codex 首日上线即支持中文,Claude 桌面端近期也已原生支持简体中文,唯独上线近一年的 Antigravity 至今找不到语言切换入口。
 Claude 桌面版原生支持中文界面
图 12:Claude 桌面端已原生支持简体中文界面设置
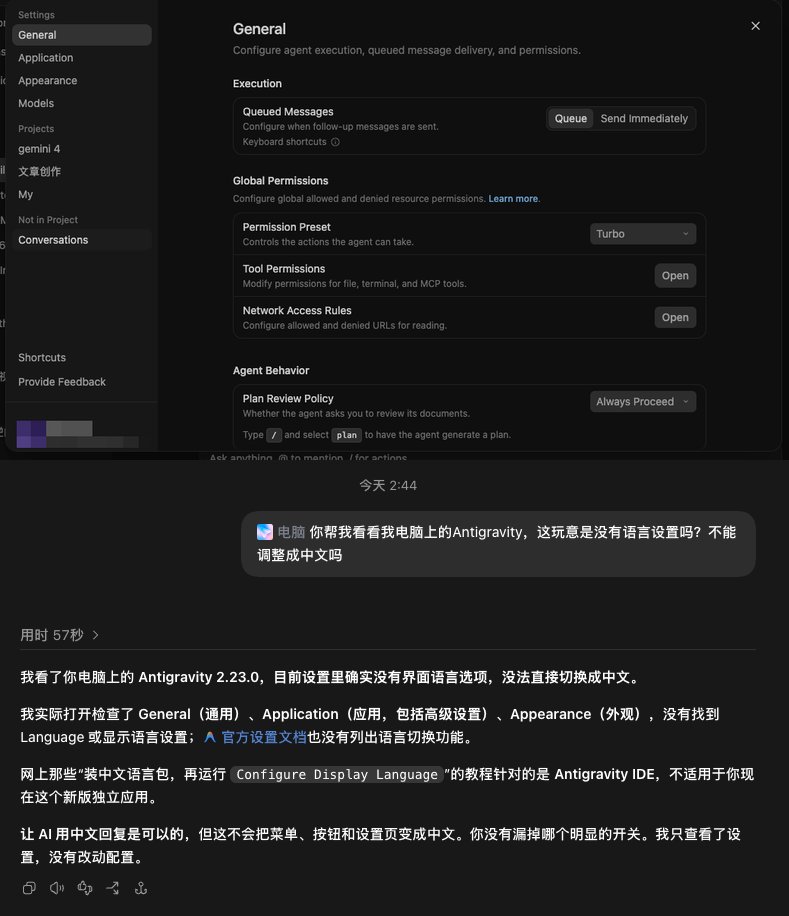 让 Codex 排查确认 Antigravity 没有语言设置入口
图 13:Antigravity 上线近一年仍无语言设置,用 Codex 全局搜索确认确实不存在该入口
2. 额度消耗过快:不到 10 个常规任务清空 $100 Ultra 的 5 小时限额
Gemini 3 Pro 当年曾凭借出色的单文件前端生成能力出圈。但放到今天,GPT-6 Astra 的 3D 空间几何表现与 Claude Opus 5.5 的版式审美和动效节奏,都已经反超了 Gemini。
我原本准备了一套社区常用的 20 题多场景前端审美测试集,打算逐一跑完对比。
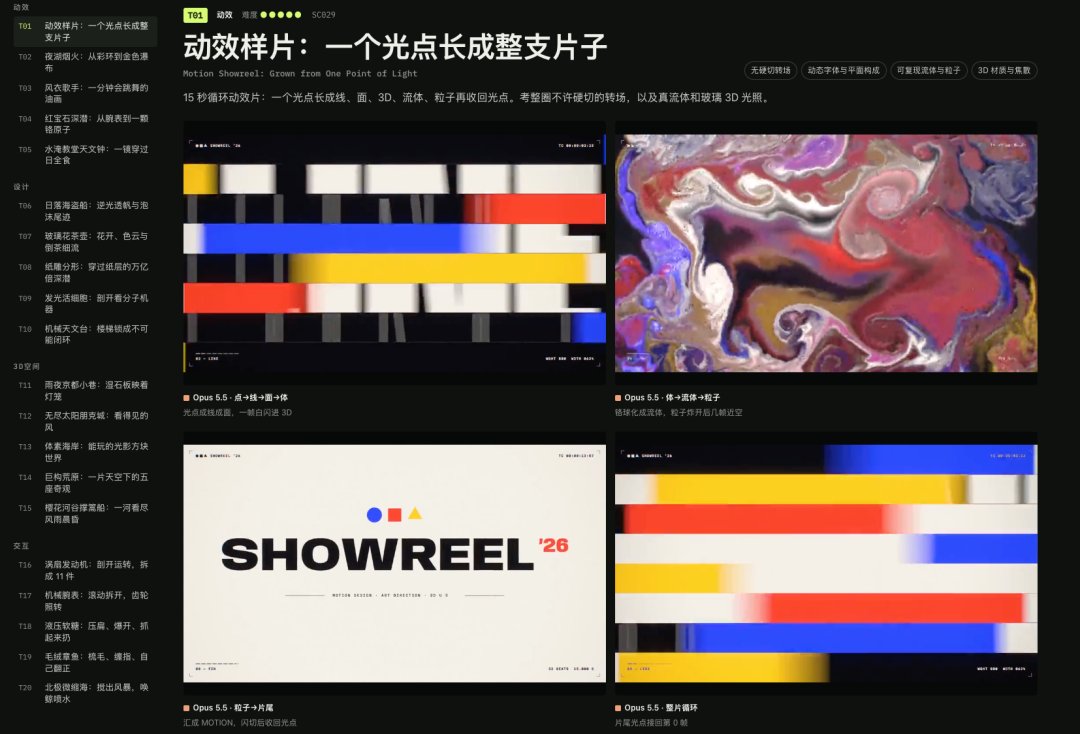 准备好的 20 个多场景前端审美测试集
图 14:原计划用于横评的 20 道前端审美测试题
没想到刚跑了不到一半,账号限额直接见底。作为月付 100 美元的 Ultra 会员,我前后只跑了 9 个单 Agent 常规任务(5 个前端生成、3 个内容写作、1 个逆向分析),没有开启任何多 Agent 并行,5 小时滚动额度就已全部归零,周总额度更是直接扣掉了 27%。同样是 100 美元档位,调用 GPT-6.1 Sol 的耐受度要高得多。
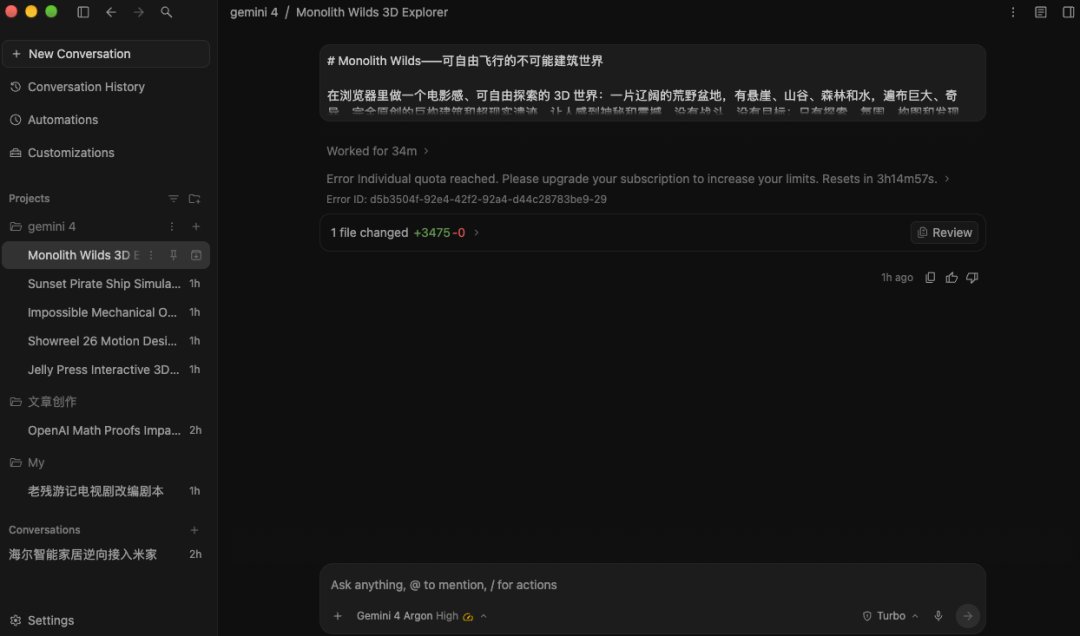 不到 10 个测试任务列表
图 15:总共仅执行了不到 10 个常规单 Agent 测试任务
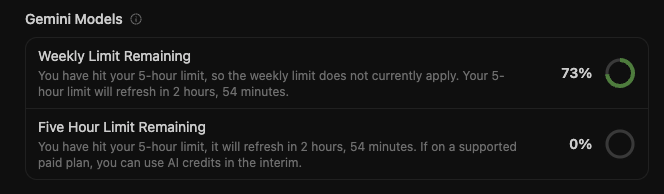 5 小时额度清空且周额度消耗 27%
图 16:$100 Ultra 会员 5 小时额度迅速归零,周额度消耗 27%
3. 前端交互体验生硬,3D 细节不及 GPT-6 Astra
前端交付的交互方式也很原始。都到 2026 年 10 月了,Antigravity 生成网页时直接在对话框里展开整份 HTML 源码,让用户手动复制,输出完闭合标签后连一句运行说明都没有。我最后只能点开 Review 面板定位本地目录,手动双击 HTML 文件才在浏览器里看到渲染结果。
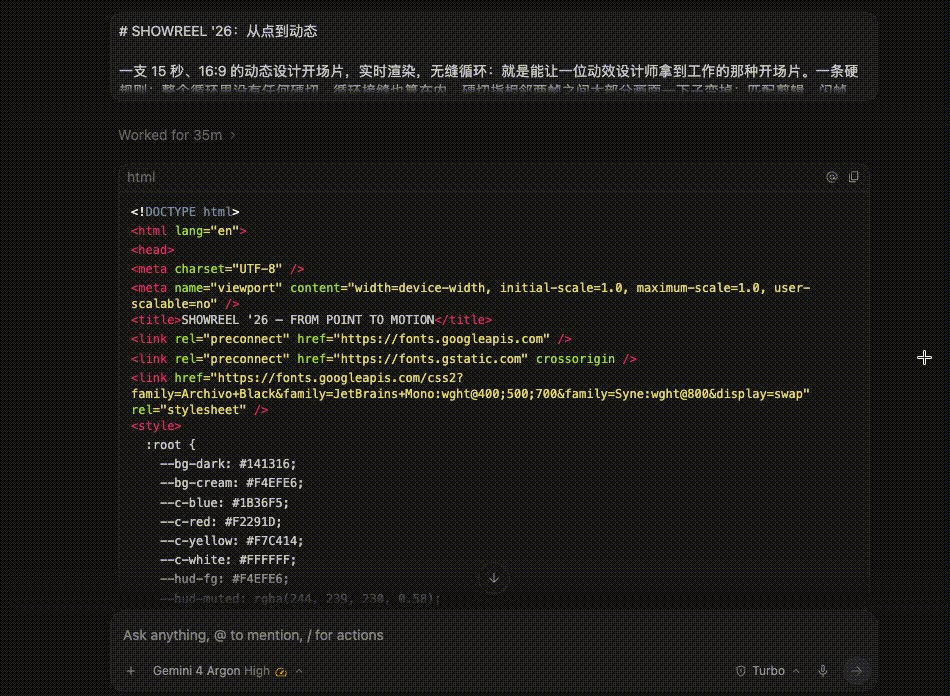 直接展开长篇 HTML 源码让用户复制
图 17:直接在对话框输出整篇 HTML 源码
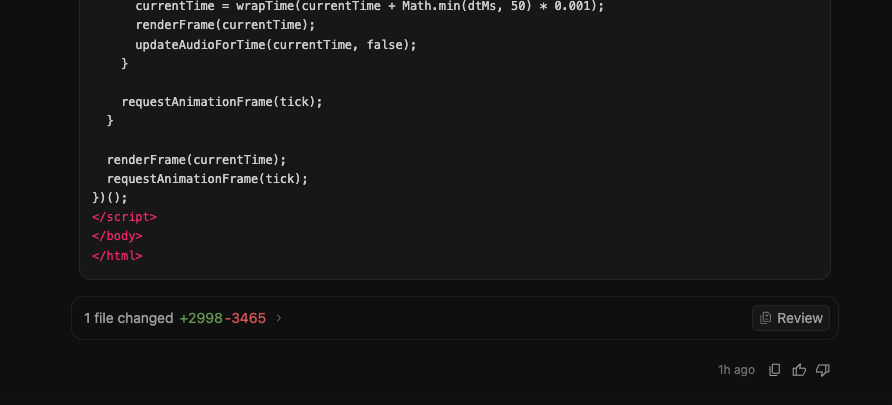 HTML 结尾没有任何总结或预览引导
图 18:输出完 </html> 后直接结束
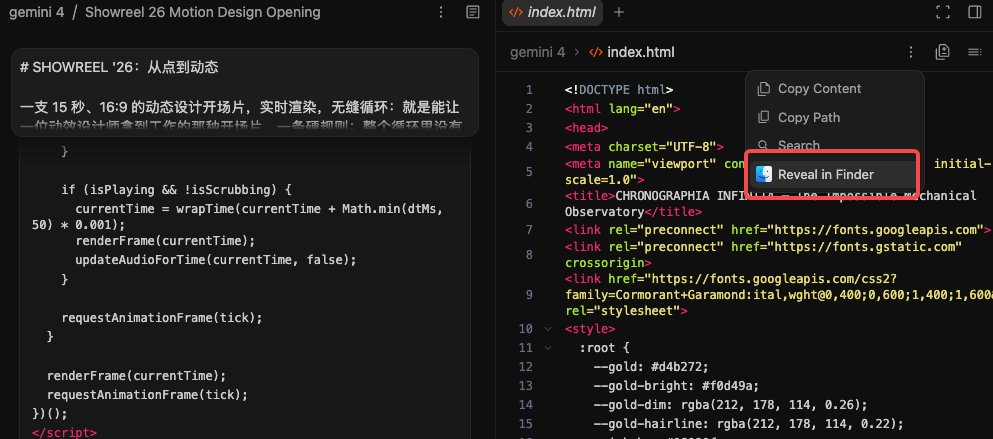 手动点 Review 从文件夹打开 HTML
图 19:需手动从文件夹双击打开才能预览
渲染效果同样经不起同题对比。下图左侧是 Gemini 4 Argon 生成的 3D 动态页面,单独看尚可;右侧是 GPT-6 Astra 在相同 Prompt 下的产出,几何建模精度和光影细节明显高出一个档次。
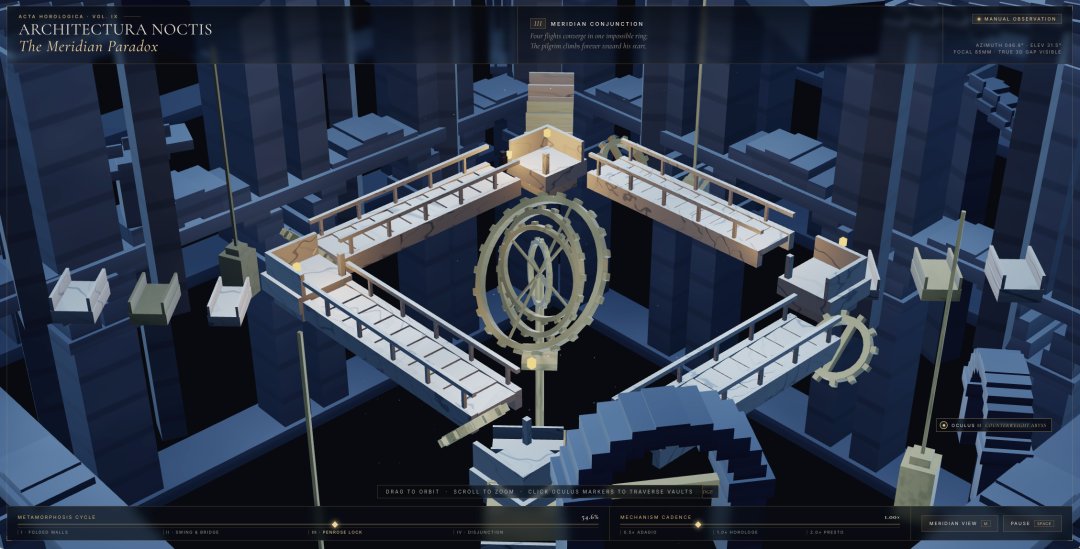 Gemini 4 Argon 生成的 3D 前端效果
图 20:Gemini 4 Argon 生成的 3D 动态前端效果
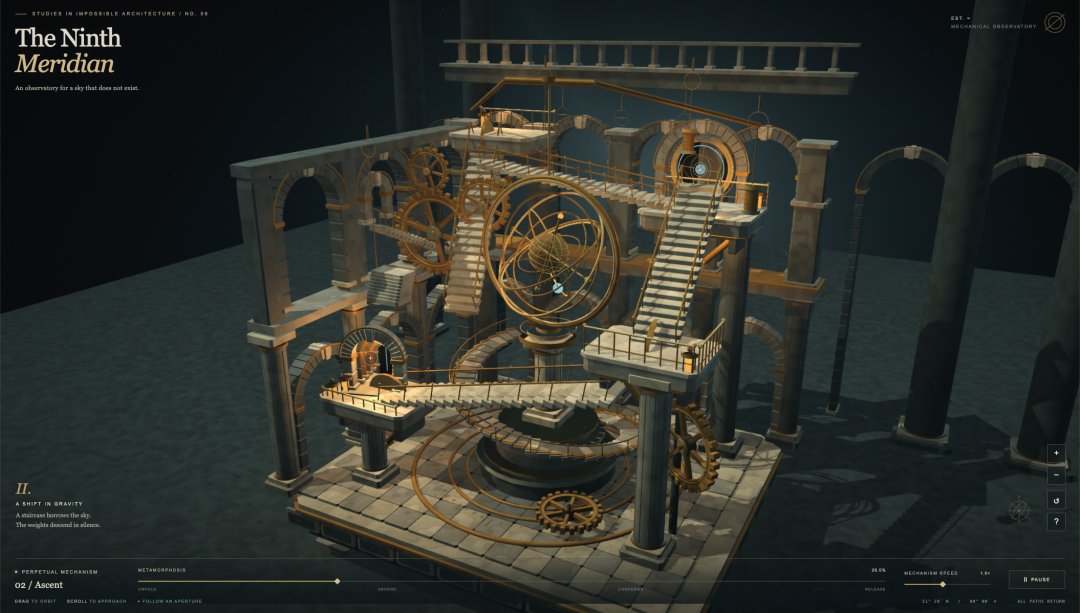 GPT-6 Astra 生成的 3D 前端效果
图 21:GPT-6 Astra 生成的同题 3D 效果(几何精度与光影细节更细腻)
我还整理了一套源自线上真实返工 Bug 的后端评测集(共几十道题),但受限于 Ultra 额度耗尽,今晚没能跑完。
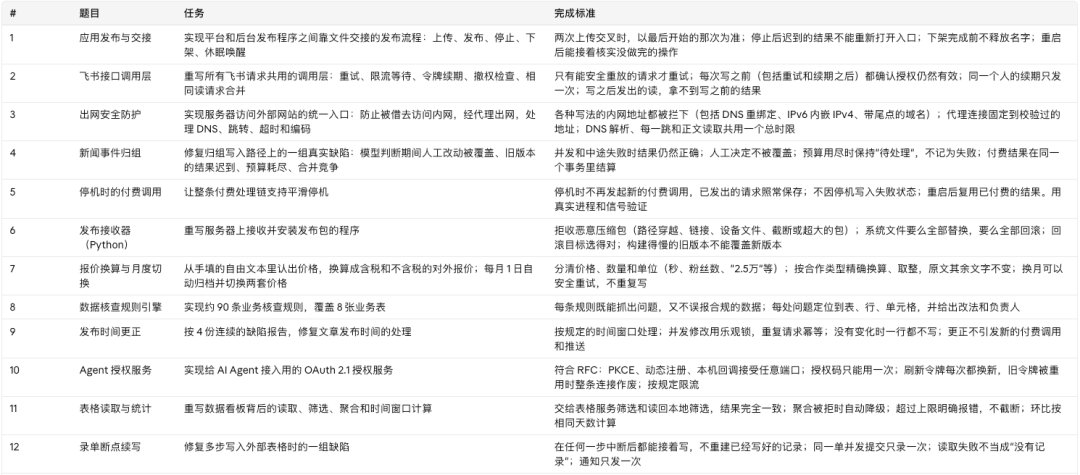 整理自真实线上 Bug 的后端评测集
图 22:源自真实线上项目反复返工 Bug 的后端评测集(因 Ultra 额度耗尽未能测完)
4. 内容写作:英文盲测夺冠,中文直出仍带浓重翻译腔
内容创作方面,Gemini 4 Argon 登顶了 LMSYS Arena 写作盲测榜,但该榜单主要基于英文语境评选。
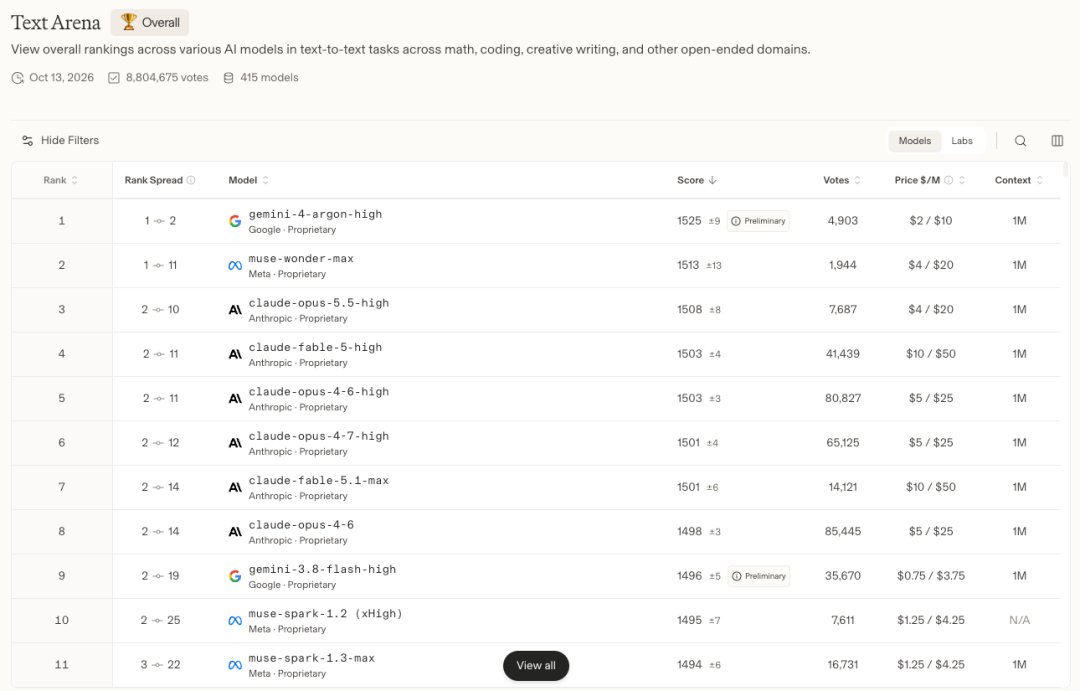 Gemini 4 Argon 在英文 Arena 写作盲测中排名第一
图 23:Arena 写作盲测第一名(注:基于英文语境评测)
切回中文写作,AI 腔依然很重。我把前几天写过的 OpenAI 数学突破报道提炼成一份结构化 Prompt,只给大纲、论点和事实框架,不喂个人历史文风样本,专门测试它的中文原生直出质量。
生成的初稿保留了 Gemini 3 时期饱受诟病的生硬比喻和满屏双引号怪癖。看到小标题写出《攻克了哪几座“神仙山头”》时,基本可以判定它还不适合直接用于严肃中文技术写作。
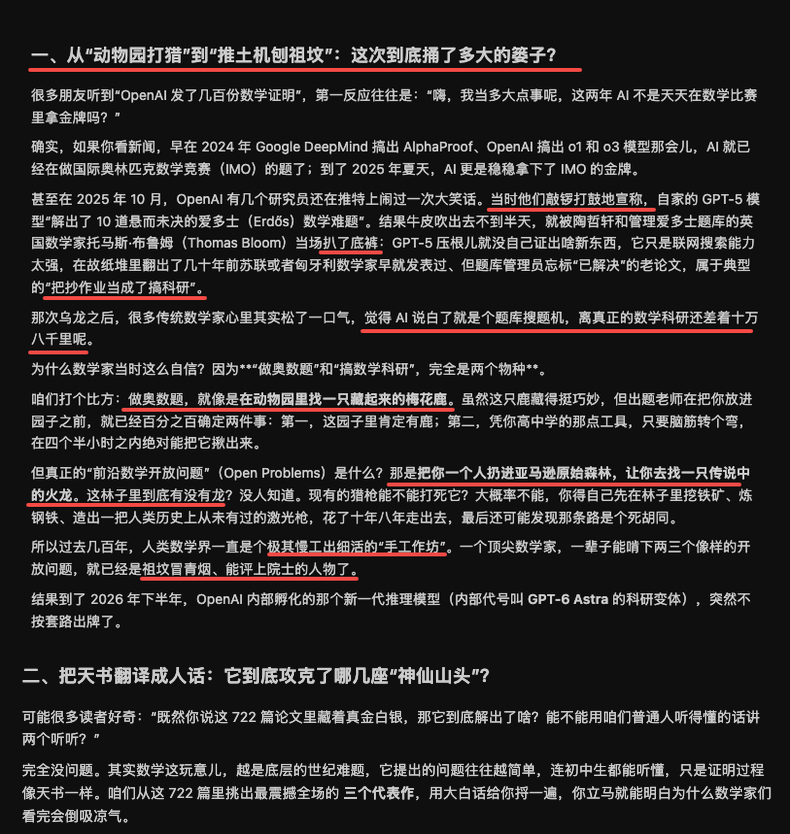 Gemini 4 Argon 中文写作直出:攻克了哪几座“神仙山头”
图 24:中文直出依然保留着生硬比喻与高频双引号习惯
在金融、法务等英文专业案头工作上,Argon 的性价比优势确实存在。但聚焦到日常研发编程、中文内容创作以及客户端工具链成熟度上,这几个小时的实测体验并不理想。
五、订阅建议与个人月均 6000 元主力 AI 工具单
如果你的日常任务以写代码、做产品和中文写作为主,不建议花 100 美元开通 Google Ultra 会员;想尝鲜开 20 美元的 Pro 档位足够了。下面附上我目前每月在用的主力 AI 订阅清单供参考:
- ChatGPT Pro 会员:$100/月(约 670 元)日常通用主力
GPT-6 Astra 刚发布重构 AIHOT 项目那阵子,我开过两个 200 美元账号配重置卡才够用。后来产品构建主力切到了 Claude Opus 5.5,我就把 ChatGPT 降回 100 美元档位,加上官方补偿的 62,500 额度和重置卡,日常完全够用。
主要场景:个人与公司项目的 Issue 反馈处理、PR 自动开发、运维监控脚本编写(GPT-6.1 Sol 修 Bug 很稳),以及后端调优和网络硬件排障。比如今晚我刚用它调优了新办公室的网关和 AP 参数。对大多数用户而言,ChatGPT 兼顾聊天、生图和中小规模代码开发,综合覆盖面最广。
- Claude Max 会员:$250/月(Google Play 含 $50 渠道费,约 1675 元)工程构建主力
Claude Opus 5.5 是目前前端工程、UI 审美和动效开发的绝对主力。除部分后端底层调优和浏览器操控外,GPT-6.1 Sol 与 GPT-6 Astra 在产品构建质感上很难追平 Opus 5.5。实际耐用度大约是同档 Codex 的 5 倍:我连续一周全用 Opus 5.5 高强度写代码、调设计和做动效,今天下午重置前周额度刚好用到 96%。
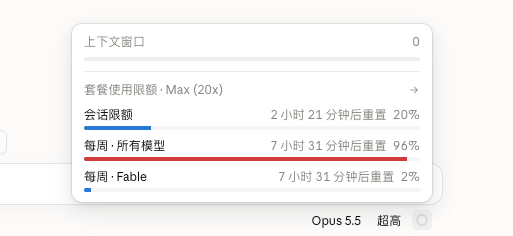 Claude Max 高强度开发一周后周额度使用 96%
图 25:Claude Max 会员高强度调用 Claude Opus 5.5 一整周,重置前周额度刚好用到 96%
- X Ultra 会员:$200/月(首月半价 $100,国内信用卡网页端约 1338 元)50x 额度 + Grok Bot
X 今天刚上线的整合会员,打包了 Grok、Grok Bot、Cursor 权益和 X 会员。Grok 4.7 本身能力偏弱,我买它主要冲着 Grok Bot:实际体验比 ChatGPT 的 Dots 顺手,后台还能直接切 Claude Opus 5.5 驱动。此外 200 美元档直接给到了 50x 额度倍率,远高于 Claude 和 Codex 的 10x。
- Suno Pro($8/月,约 53 元)与 5. LibTV 至尊版(1499 元/月)音视频制作
Suno Pro:生成配乐效果稳定,按年订阅与视频团队共用。
LibTV 至尊版:供视频团队高频生成视频素材,非视频业务无需开通。
算上各项订阅与 API 账单,我每月在 AI 工具上的固定支出超过 6000 元。如果预算有限只想保留一个订阅,优先选覆盖面最广的 ChatGPT;重度写代码做产品直接上 Claude Max。至于刚开放的 Gemini 4 Argon,除非你高频处理英文金融、法务和税务文档,否则现阶段没必要为它单独续费 Ultra。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。