
入职大厂两个月的 AI 开发与代码审查实践
作者: 黄同学h @huangtongxueh•发布日期: 2026-10-09 23:15•阅读时长: 约 12 分钟•大厂实战 · 研发工作流
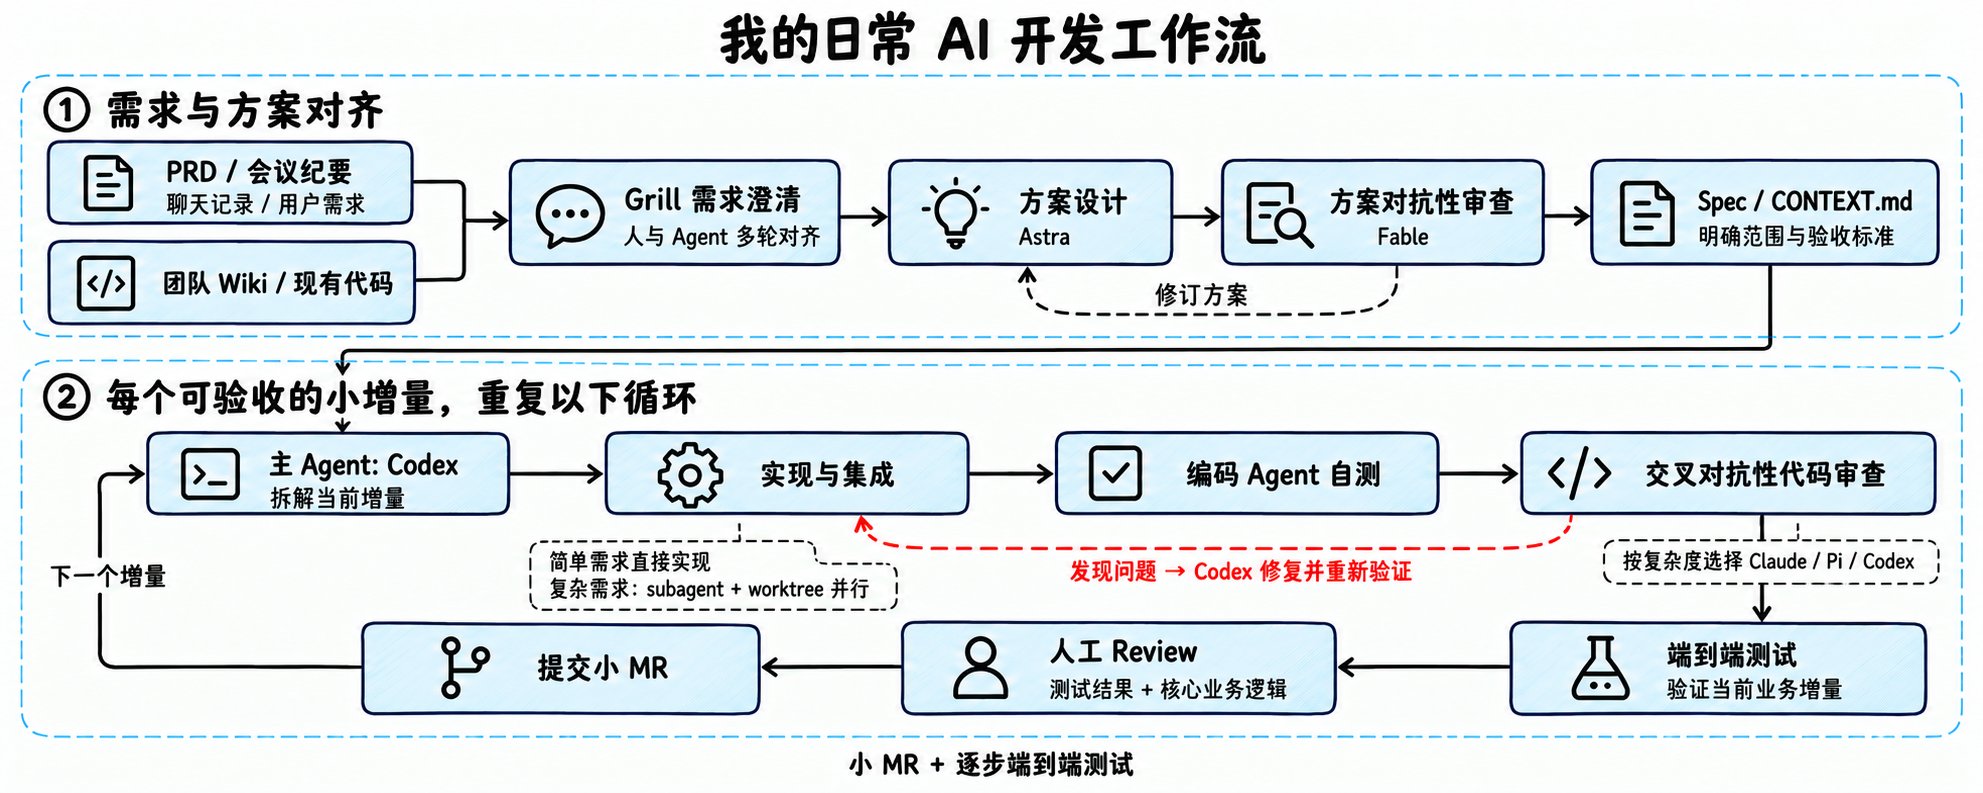 日常 AI 开发工作流示意图
图 1:需求澄清与小增量迭代结合的日常 AI 开发工作流
内容提要
作者入职大厂两个月,负责 Agent 开发和存量后端业务维护。靠明确的 AI 工具分工、个人测试 Harness 和针对性的 Code Review,需求交付快且稳,目前已接手多个项目担任主 Owner。
工具分工:Codex 编码 + Astra 规划 + Claude 5 对抗审查
思维快捷键:第一性原理、对抗审查、消融实验和奥卡姆剃刀
端到端 Harness:测试 CLI + 真实环境取证 + 小增量 MR
背景:给重型 Skill 做减法
前阵子我和组里主管聊了几次 1-on-1。我目前需求交付又快又稳,已经担任几个项目的主 Owner,他对我的 AI 工具用法、个人 Harness 搭建和日常编码工作流很感兴趣。
我借这个机会梳理了自己的日常 AI 开发流程。目前我在组里主要做 Agent 开发,同时维护存量后端服务。
我之前在小红书分享过早期工作流。当时给足准确上下文和规则,GPT-5.4 与 Opus 4.6 就能把任务做好。Harness Engineering 兴起后,大家普遍认为给模型加上明确约束能提升输出质量。
例如 Superpowers 这类重型 Skill,围绕 Spec 和 TDD 定了一整套严密流程,用来拆解和推进开发任务。
重型 Skill 的隐形代价:Token 消耗与流程噪声
Superpowers 内置了大量规定下一步动作的硬性流程。就算当前上下文已经足够直接写代码,模型还是会机械走完预设步骤,白白消耗 Token。新一代模型推理能力大幅提升后,以前管用的死板约束反而成了干扰判断的噪声。
OpenAI 发布 Astra 时也专门发文,建议清理多余的 Skill 和系统提示词。下面结合我近几个月的实战经验,聊聊怎么搭配各类 Agent 提升日常研发效率。
一、我常用的 Skill 与 Prompt 快捷键
1. 日常工具分工
编码主力:Codex + GPT-5.6 Sol
负责增量拆解、测试驱动开发与业务代码编写。它的执行效率高,但容易过度设计,需要配合精简规则约束。
宏观规划:Astra
负责复杂需求的前期方案规划。Astra 发布前,我主要用 GPT-5.6 Sol Max 梳理整体架构。
敏捷小需求:pi + DeepSeek V4 Flash
成本低、响应快,适合并发处理简单代码修改、脚本编写与日常排障。
对抗性审查 & CR:Claude 5 Fable
专门用来挑刺,排查假设漏洞与边界死角;个人项目的方案设计则用网页端 GPT-6 Pro。
2. 常用的 7 个 Skill
- think(tw93 出品)方案梳理
用于前期梳理方案与多角度头脑风暴,快速发散并收敛技术思路。
- grill me / grill with docs需求澄清
用于需求澄清。它通过连续追问把目标、约束和技术取舍问透,找出容易忽略的盲区,再写入 ADR 或 CONTEXT.md。
- implement(Matt Pocock 出品)计划执行
配合 grill 使用,把边界清晰的开发计划或 Issue 转化为工程代码。
- ponytail(极简代码约束)删减冗余
我用得最频繁的一个 Skill。GPT-5.6 Sol 经常习惯性过度设计,乱加设计模式、状态机或中间层。ponytail 会强制删掉非必要代码,大幅减轻后续 Review 负担。
- handoff(会话交接)状态保存
把当前会话的结论和待办整理成干净的 Markdown 文档,方便从 Codex 切到 Claude Code 或 pi agent 接着做。
- check(代码自检)提交前自检
正式向团队提 MR(Merge Request)前运行,自动检查静态代码规范和安全基线。
- 团队自建 SOP Skill流程复用
日常自测或排障步骤只要重复超过 3 次,我就让 Codex 整理成独立 Skill,后续直接复用。
3. 五个思维快捷键 Prompt
我现在很少手写几百行的长篇 Workflow Prompt。主流工程方法论在模型预训练阶段早已被充分学习。你不用从头教它思考步骤,直接给出方法论名称作为“思维快捷键”即可:
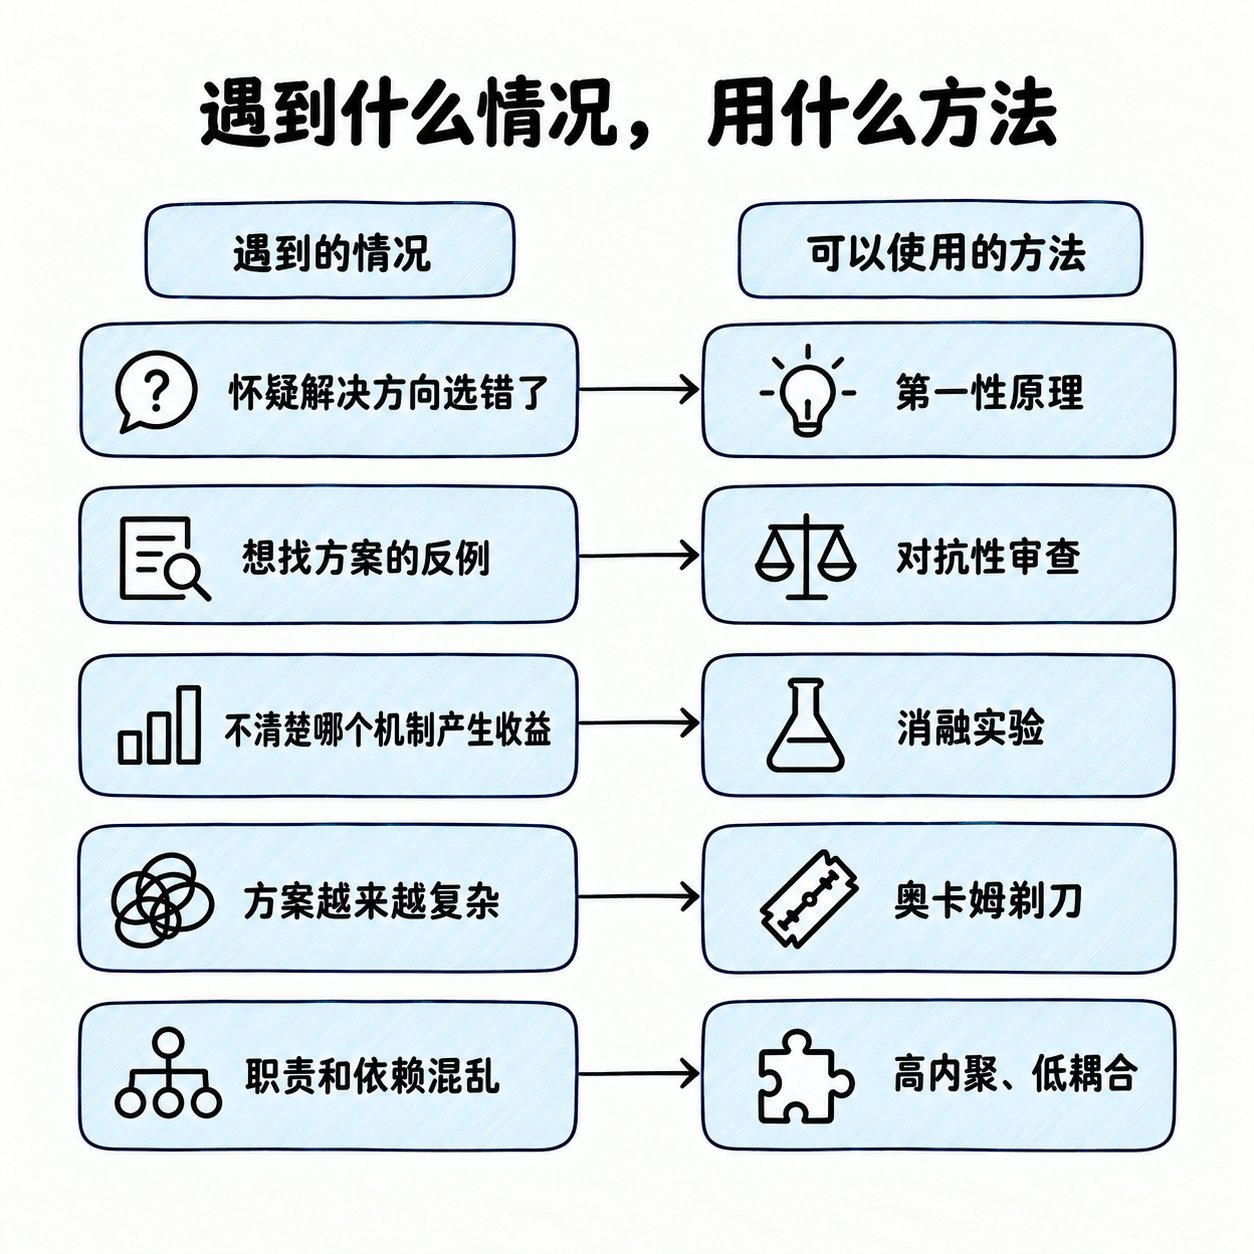 遇到什么情况用什么方法
图 2:五种工程方法论对应的适用场景
- 第一性原理:怀疑解决方向本身选错了
典型指令:不要基于“加 Redis 缓存”这个既定方案继续设计。从第一性原理分析这个接口为什么慢,以及最小必要的解决方案。
实际效果:模型不再纠结怎么配 Redis 参数,转而排查瓶颈在 SQL、网络还是锁竞争。如果加个联合索引就能解决,就不用引入 Redis。
- 对抗性审查:先找反例推翻假设
典型指令:对这个方案做一次对抗性审查,优先寻找能推翻核心假设的反例。
实际效果:审查分布式锁方案时,它不再只看超时参数,会直接追问:重复请求是否真要互斥?幂等能否解决?锁服务宕机,或锁过期后业务没跑完怎么办?
- 消融实验:验证每一项改动是否真有收益
典型指令:给这三个优化(索引、缓存、批量查询)设计消融实验,判断真正的收益来自哪里。
实际效果:模型会拆分单变量对照组。实测常会发现单加索引就把耗时从 800ms 降到了 120ms,其余两个复杂改动只省了 20ms,正好顺手删掉冗余逻辑。
- 奥卡姆剃刀:选假设最少、复杂度最低的方案
典型指令:用奥卡姆剃刀重新审查这个设计,在满足需求的前提下,删除所有非必要机制。
实际效果:把“Kafka + Redis + 状态机 + 定时补偿”简化回“单库事务 + 唯一索引”,减少线上偶发故障。
- 高内聚低耦合:理清职责边界,不为拆而拆
典型指令:按高内聚、低耦合原则审查 OrderService 的职责边界,不要为了拆而拆。
实际效果:促使模型按模块化、信息隐藏与依赖反转原则检查代码,分清核心领域逻辑与外部接口隔离层。
组合 Prompt 示例:
“从第一性原理重新分析,对当前方案做对抗性审查;核心机制必须通过消融实验验证;方案遵循奥卡姆剃刀,代码保持高内聚、低耦合。”
五个动作依次对应:重新定义问题、攻击假设、验证收益、删减复杂度、理清系统边界。
二、日常开发的两阶段工作流
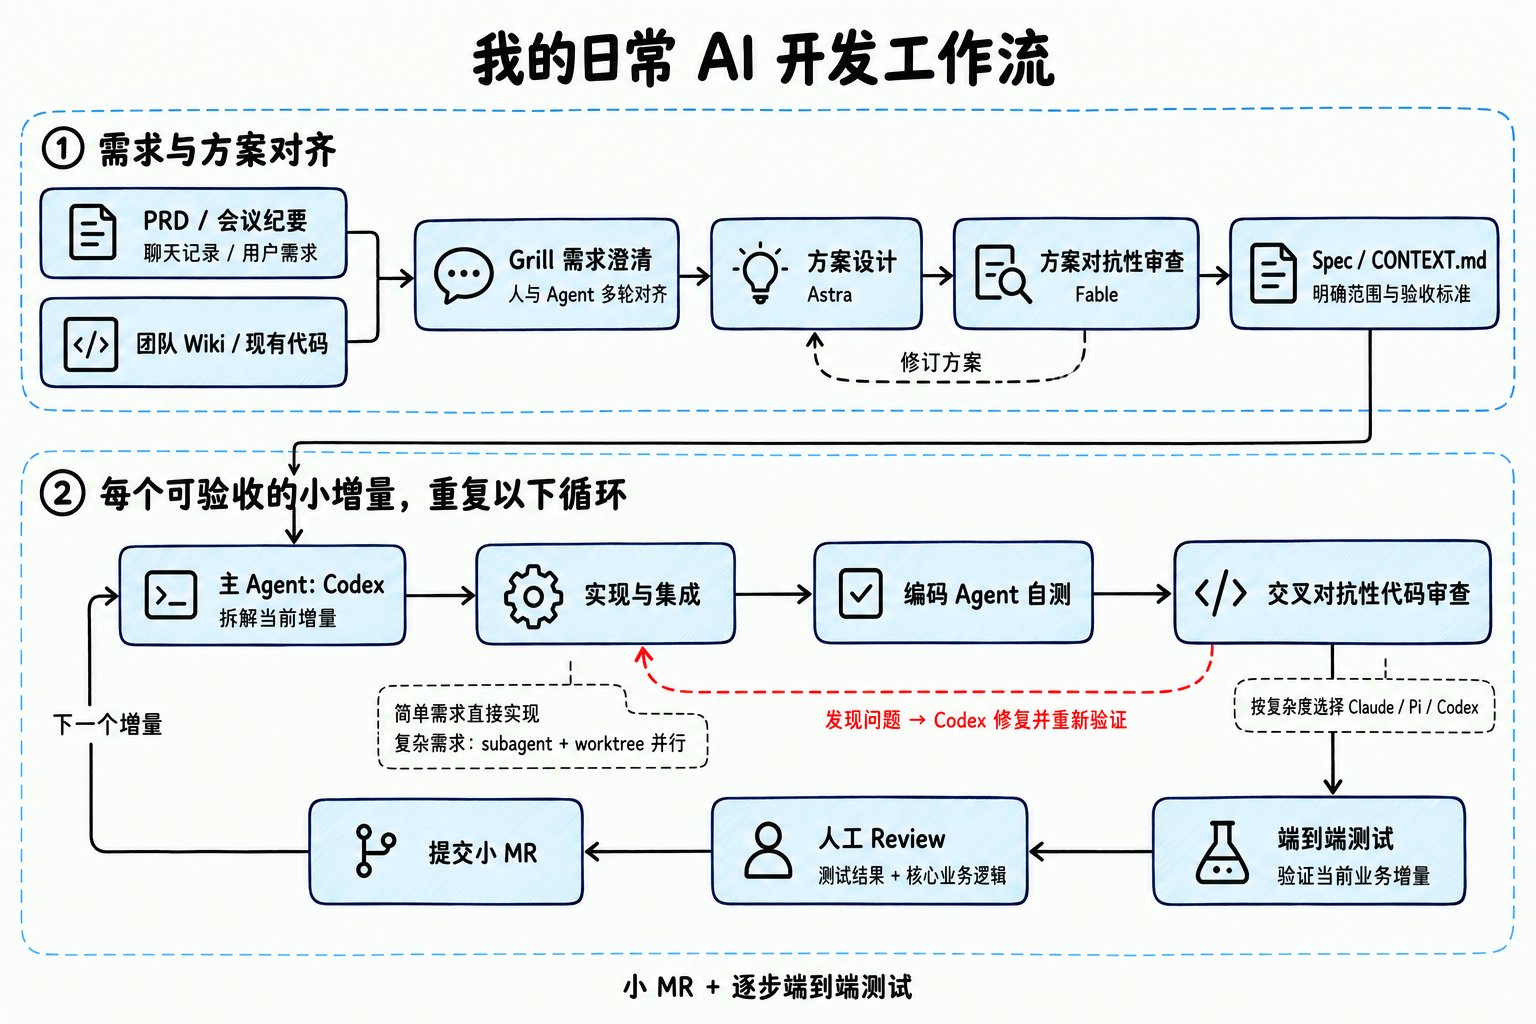 日常开发两阶段工作流
图 3:需求方案确认(阶段 1)与小增量迭代验证(阶段 2)流转图
阶段 1:确认需求与方案(控制前期讨论深度)
- 汇总多源材料:把 PRD、会议纪要、聊天记录和用户反馈一并交给 Agent,结合团队 Wiki 与现有代码通读。实际业务里这些文档经常互相冲突或过期。
- Grill 连续追问:让 Agent 扮演架构师连续发问,挖出影响实现的目标、边界与技术取舍。能定的当场敲定,不确定的找产品经理确认。
- 启动开发的节点:只要剩下的小问题不再影响整体技术方向和验收标准,就可以动手写代码了。不要强求提前定死每个微观细节,否则前期准备本身也会变成负担。
- 写入 Spec / CONTEXT.md:把本轮迭代的目标、边界、关键决策和验收标准写成文档。后续并行的 Subagent 直接读取这份文件,不用重读上万字的历史对话。
阶段 2:可验收的小增量循环
步骤 1
主 Agent(Codex)拆解增量:简单需求直接写代码;复杂需求拆成边界清晰、可独立验收的 Issue。
步骤 2
并行隔离开发:互不依赖的模块才派给 Subagent,放在各自的 git worktree 里并行编码,最后由主 Agent 合并。
步骤 3
交叉对抗审查:编码 Agent 自测通过后,按任务复杂度交给 Claude 5 Fable 或 pi 做交叉审查,查出的问题转回 Codex 修复重测。
步骤 4
端到端测试与小 MR 审查:人工不逐行通读所有代码,重点核对测试结果和核心业务逻辑,每次只提交小体量 MR。
三、搭建面向 Agent 的端到端测试 Harness
AI 现在很擅长写单元测试,修一个小 Bug 也能补上几百行单测代码,但上线后还是常出故障。根源在于缺少端到端测试环境,Agent 自测时根本没碰到真实的系统入口与数据库。
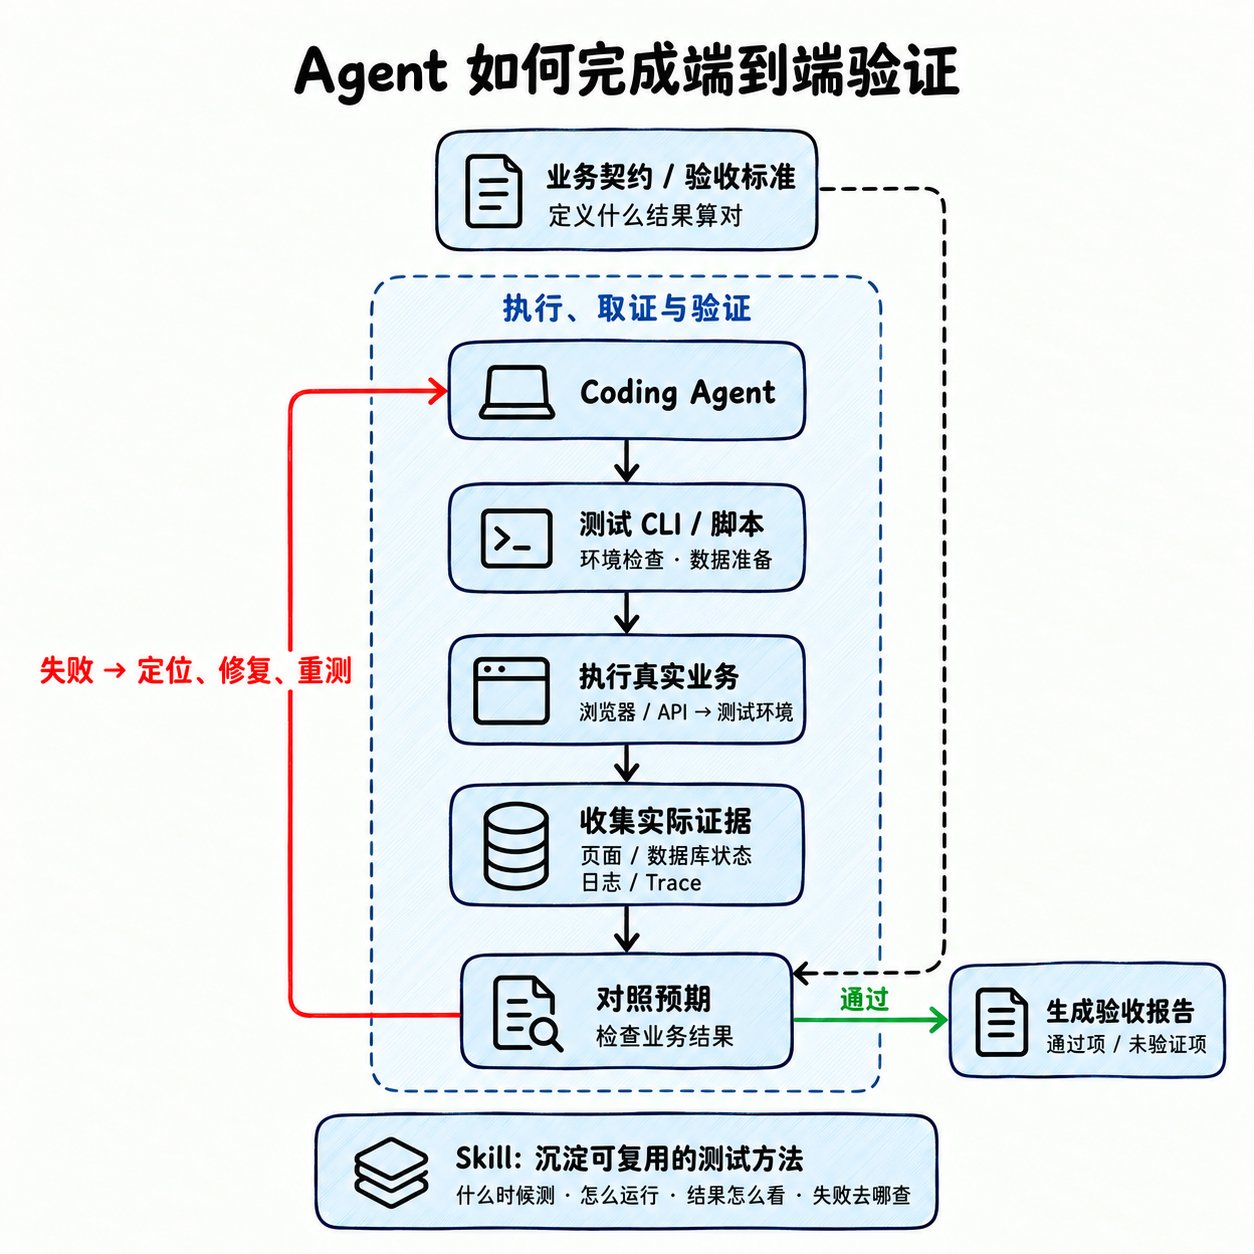 Agent 如何完成端到端验证
图 4:Agent 端到端验证流程(定义契约、执行取证与固化 Skill)
1. 端到端 Harness 的四项基础条件
- 让 Agent 熟悉环境
支持一键拉起沙盒或测试环境、构造测试数据,写清环境版本、权限范围与重置清理方式。
- 让 Agent 能操作业务系统
提供浏览器、API 或 CLI 命令行入口,让 Agent 能跑完真实业务流程。
- 方便查询库表与日志
配置只读数据库 MCP 核对落库数据,配合日志 Trace Skill 追查调用链路与异常堆栈。
- 固化高频操作流程
把稳定的重复操作写成脚本,将入口与排障步骤封装为 Skill,减少人工介入。
2. 四条实战经验
- 轻量浏览器自动化:涉及页面交互时,用开源的
ego lite搭配pi agent + DeepSeek V4 Flash,运行快、成本低,能明显缩短测试耗时。 - 操作统一封装为专用 CLI:把常用的 Skill、MCP 和脚本收进同一个内部测试 CLI,覆盖环境检查、造数、执行与清理。这套工具既供 Agent 调用,平时自己本地调试也很顺手。
- 按业务契约验收结果,不能系统返回什么就信什么: 注意验证陷阱:数据库用来查状态,日志用来排错,但预期结果必须依据明确的业务契约。在复杂业务里,接口很可能返回看似正常却违背业务规则的数值。工具只负责采集证据,不能替工程师定义正确标准。
- 给 Agent 产品加上质量评测(Eval):如果被测业务本身就是智能体,除了验证接口跑通,还要接入输出质量评测(Agent Eval)。
四、高效审查 AI 代码的方法
不管代码是不是 AI 生成的,线上业务的第一责任人始终是工程师自己。谁都不想半夜接报警电话起来 On-call,查到最后发现是漏审的 AI 代码埋了雷。
- 先看验收标准,再对照测试证据
别光看测试通过率是不是 100%,先核对测试代码到底验证了什么逻辑。AI 有时为了把测试跑绿,会顺着错误的代码实现去改写断言。
- 顺着业务路径抓高风险模块,放过稳定 CRUD
把有限的审查精力集中在高风险环节:权限校验、核心状态流转、并发竞争、失败重试、数据一致性,以及数据库 Migration 与回滚方案。套路固定的单表 CRUD 代码,我现在基本不再逐行细看。
- 专门审查新增的抽象层与过度机制
只要看到新增工厂类、泛型适配器或复杂状态机,就按奥卡姆剃刀追问:能不能写得更直白,是不是在为假想的未来需求过度封装。
- MR 规模变大时,接入专用 Review Bot
结合 Git 变更信息与团队代码规范搭建专用 Review Bot,在人工介入前先拦下 80% 的常见低级问题。
五、研发瓶颈转移与规则精简
现在日常开发最大的瓶颈已经转移到了人工 Code Review 的吞吐上限,编码速度本身早就不缺了。
Agent 可以在多个 worktree 里同时写 3 个需求,但工程师理解业务、权衡边界和验收测试的精力有限。一味让 AI 狂写代码,只会堆出一批没人敢合入的庞大 MR。
Harness 的关键作用:除了提供准确上下文,还要给 Agent 配备能跑通任务的真实运行环境,以及能验证对错的客观数据证据。
工作流也要定期做减法。很多旧规则是为了弥补早期模型的能力短板才加上的,模型升级后就要及时从 AGENTS.md 里删掉过时约束,减少上下文干扰。
AI 代劳排障后,工程师亲手踩坑定位底层问题的机会变少了。所以我现在每天都会留出固定时间,系统补齐底层技术原理并复盘线上问题。
下一步落地建议
不用一上来就搭大而全的自动化框架。先挑一条你平时最常跑的本地自测流程,让 Agent 独立跑通并留存验证结果,再把跑通的步骤写成脚本固定下来,你的个人研发 Harness 就跑起来了。
整理自一线后端与 Agent 研发实践
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。