
Qwen-Image-2.1 模型实测:7B 单流 DiT 架构、原生透明 RGBA 生成与多图编辑
FLAGSHIP OPEN SOURCE · 7B DiT — 2026 年 7B 开源图像生成与编辑模型
阿里巴巴通义千问开源 Qwen-Image-2.1:7B 统一生成与原生透明图层编辑
Qwen-Image-2.1 将视觉生成骨干控制在 7B 参数,降低了本地推理显存门槛。它在 Qwen-Image-Bench 评测中接近主流闭源模型,原生支持透明通道(RGBA)生成编辑与最多 10 张参考图融合。
GitHub Repository•Hugging Face Weights•ModelScope 魔搭社区
一、Qwen-Image-2.1 的四项核心升级
开源 AI 生图模型长期受限于显存开销与图层交付难题。高画质模型通常达到 12B 以上参数规模,消费级显卡难以流畅运行。在电商商拍、UI 设计、角色三视图和虚拟换装场景中,传统模型容易出现背景生硬、发丝边缘泛白和多图融合变形。
通义千问团队开源的 Qwen-Image-2.1 将文生图与图层编辑统一在单个模型内。其视觉生成骨干采用 32 层单流扩散 Transformer(Single-Stream DiT),参数量控制在 7B。
- 7B 单流架构与推理加速
采用 32 层 Single-Stream DiT 架构,结合混合粒度注意力与 KV Cache 静态上下文复用,在保持画质的同时降低多图推理显存与延迟。
- 原生透明通道(RGBA)生成与编辑
免去二次抠图后处理,由提示词直接控制输出 RGB 画面或 RGBA 透明图层。支持在透明图层内修改文字与表情,也可从实拍照片提取发丝级透明主体。
- 多图融合编辑:支持最多 10 张参考图
突破 1 张~2 张参考图限制,支持 10 件家具室内摆放、5 件单品虚拟试衣和 6 人肖像合成合影。配合三色圈注、画笔涂抹和独立 Mask 实现局部定向重绘。
- 真实光影质感与中英文排版
还原日光漫反射、发丝毛孔细节与影棚柔光质感,消除人物皮肤的塑料感。支持中英文复杂多层版式与艺术字排版,保持字形结构完整、字间距均匀。
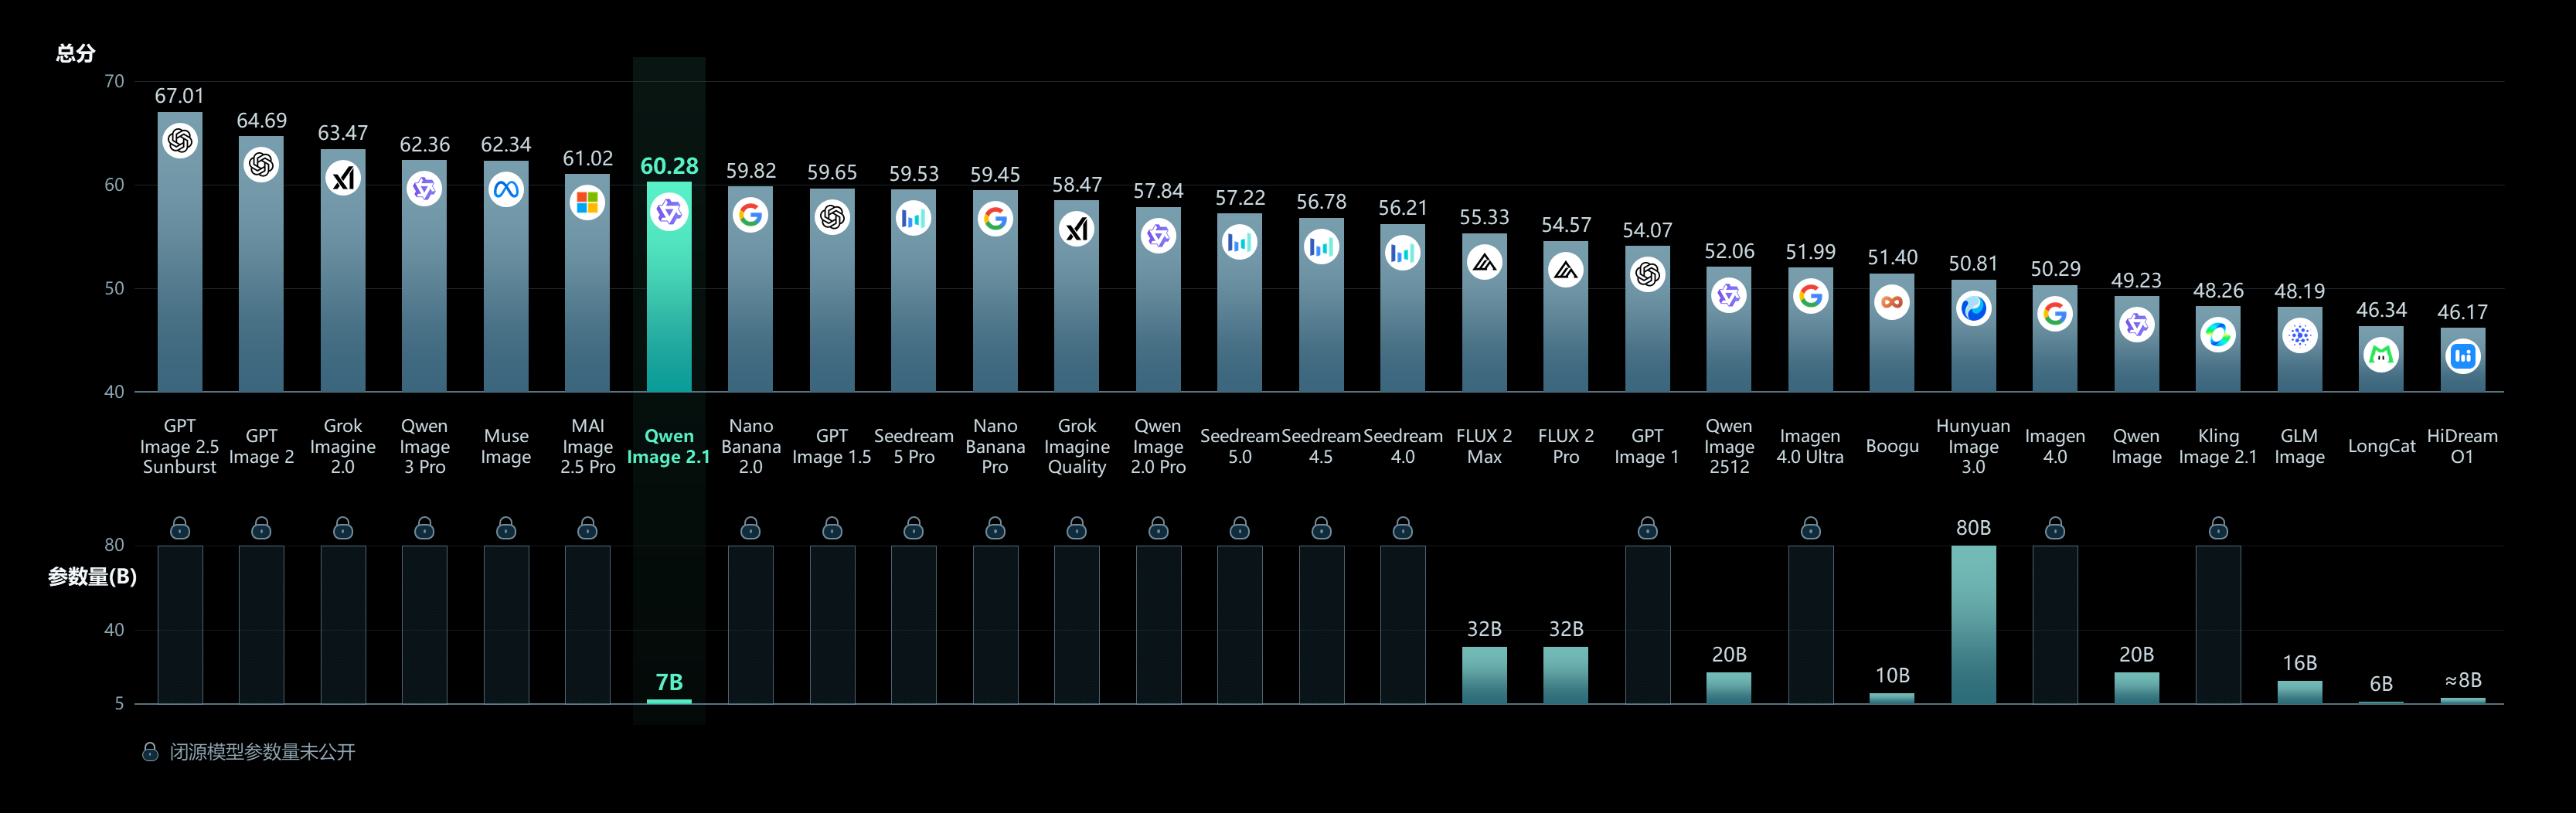 Qwen-Image-Bench evaluation comparison
▲ Qwen-Image-Bench 综合评测对比:7B 模型在文字排版、主体一致性和画面质感上接近主流闭源模型
二、架构解析:32 层 DiT 与混合粒度注意力机制
Qwen-Image-2.1 在 7B 参数规模下兼顾画质与多图编辑速度,依靠的是混合粒度注意力架构(Mixed-Granularity Attention Architecture)与 KV Cache 静态上下文复用。
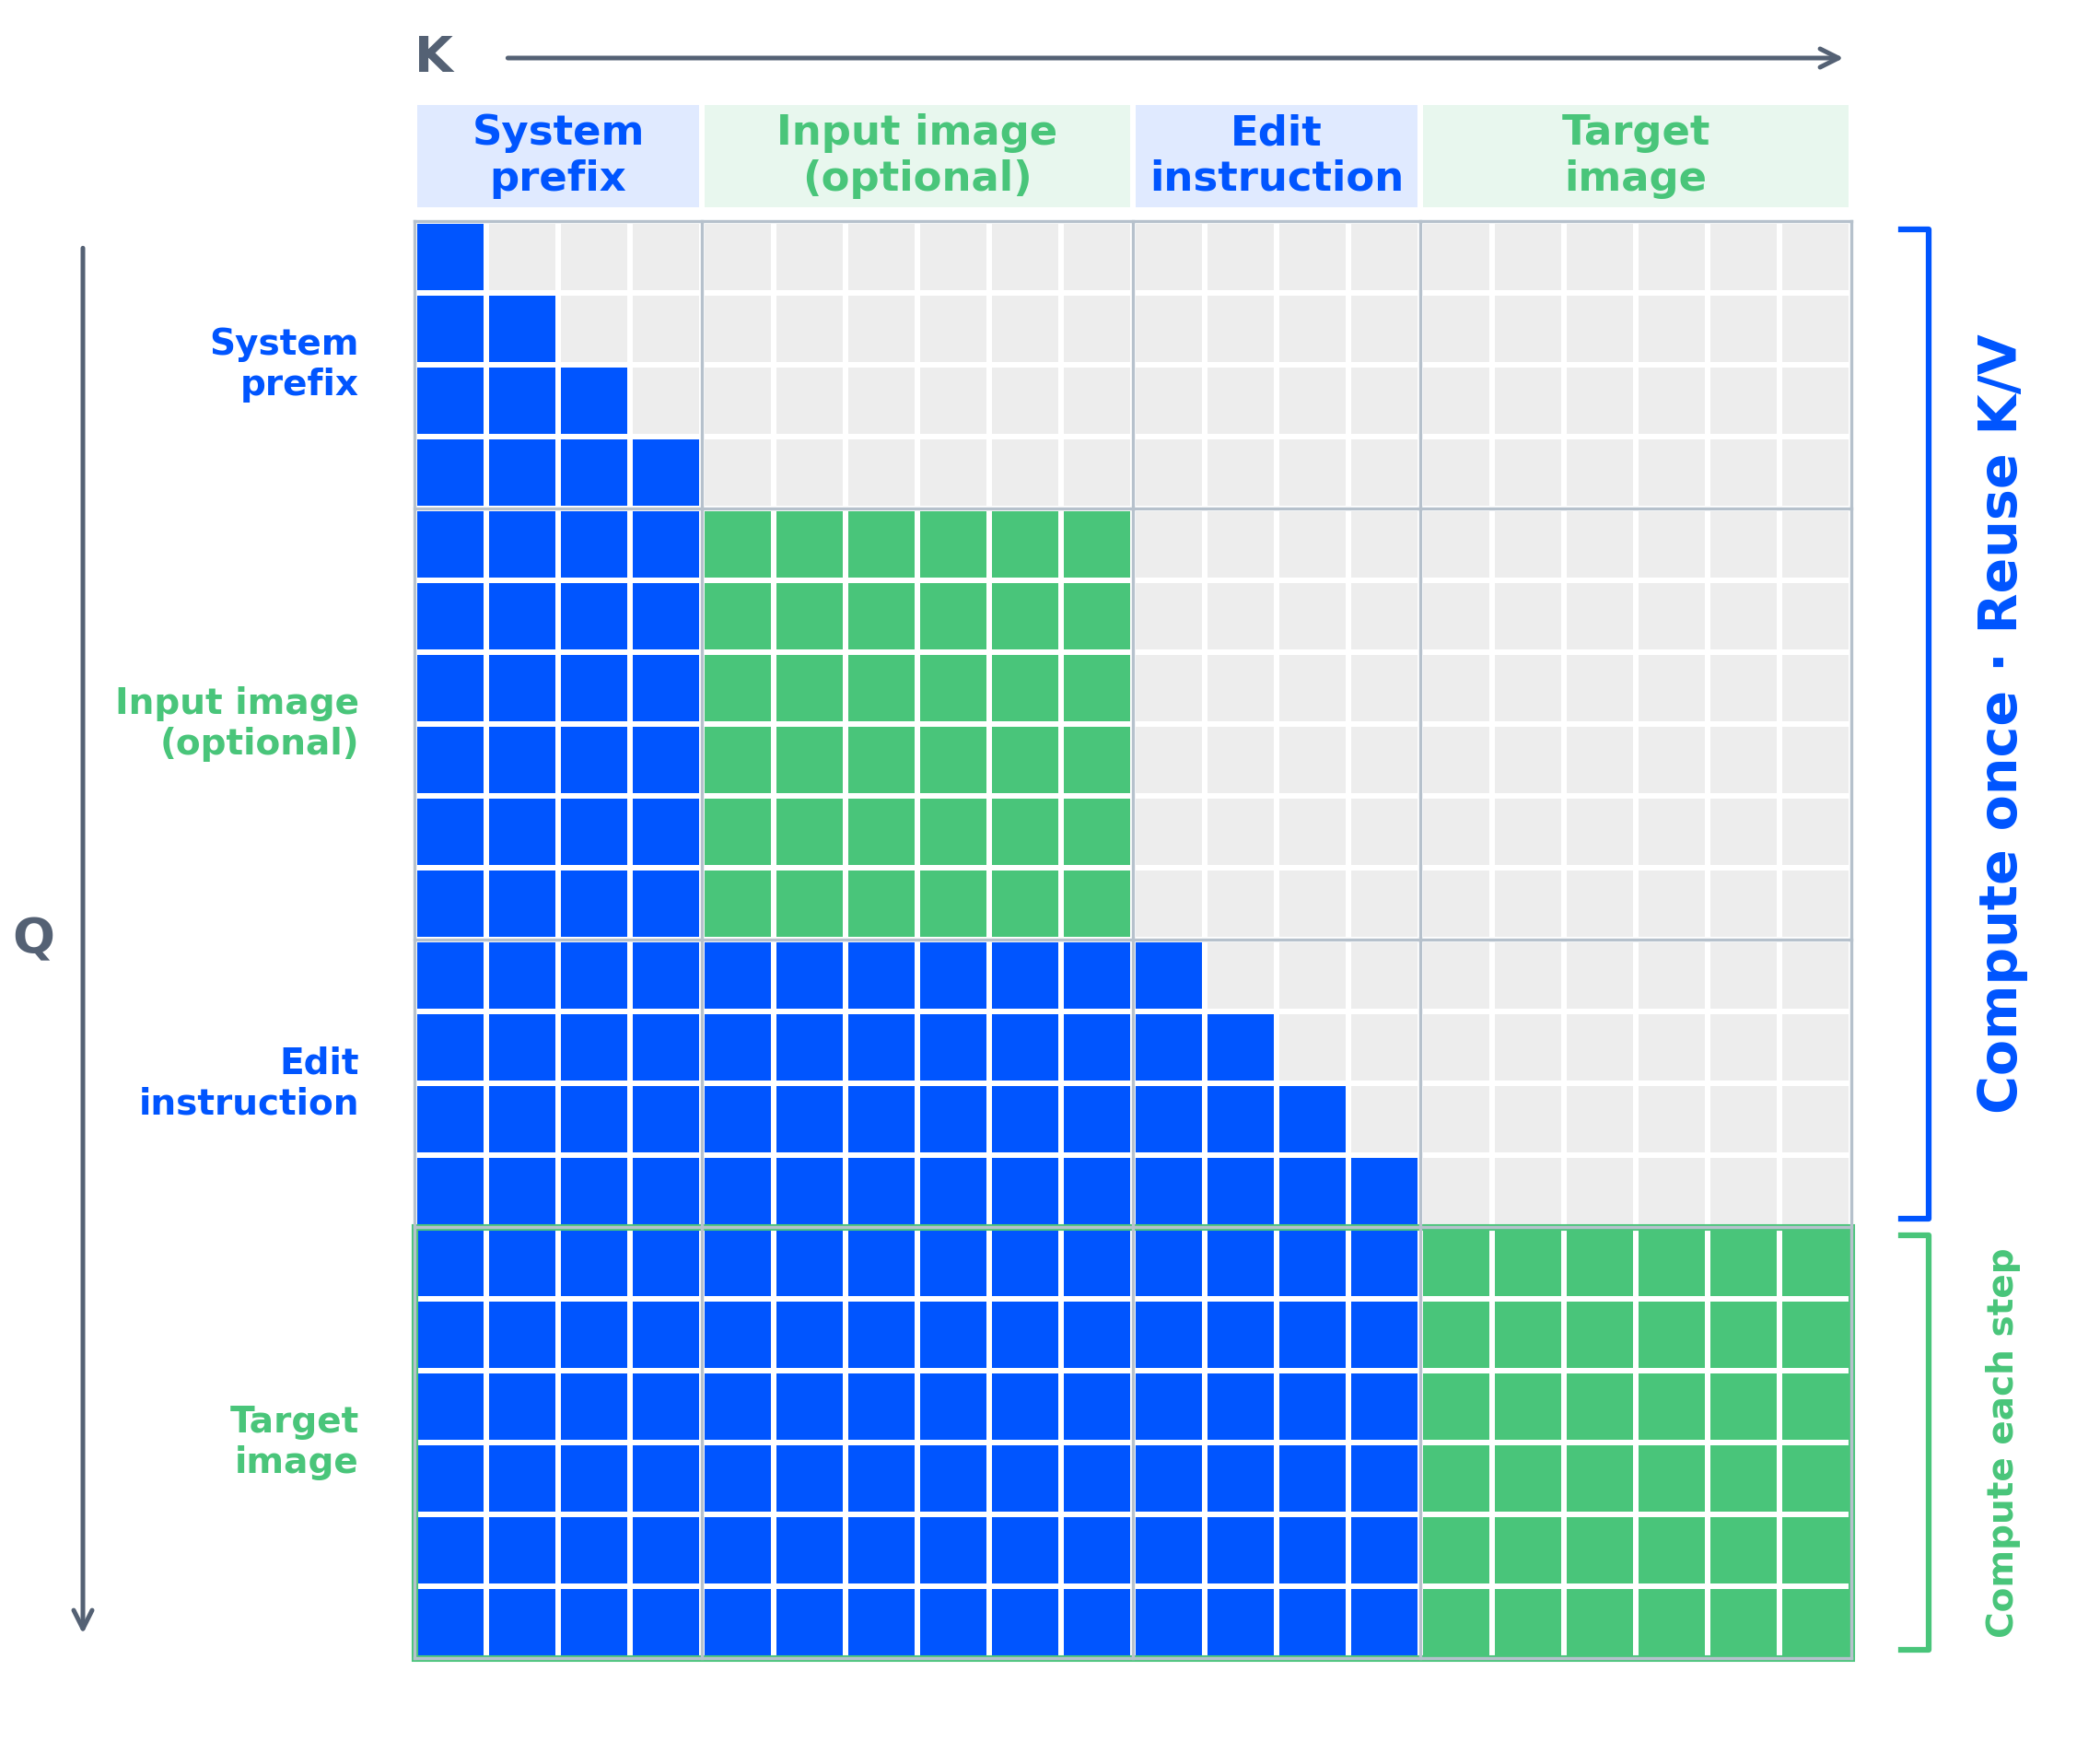 Qwen-Image-2.1 mixed-granularity attention architecture
▲ Qwen-Image-2.1 混合粒度注意力机制图解:Token 级掩码 + Chunk 级图像掩码 + 静态上下文预缓存
混合粒度掩码(Mixed-Granularity Masks)
文本部分(含 System Prefix、指令和编辑 Prompt)采用 Token 级因果掩码(Causal Mask),严格保持自然语言语序。图像生成与编辑区域采用分块级(Chunk-level)掩码,兼顾局部空间连贯性与全局注意力计算。
KV Cache 静态上下文复用加速
在多图编辑场景中,输入的 5 张~10 张参考图与系统指令作为静态上下文(Static Context)处理。模型在首步扩散推理时计算其 Key/Value 张量并缓存至显存,后续数十步去噪无需重复计算参考图自注意力,推理耗时下降 40% 以上。
三、原生透明通道(RGBA):免除后期抠图的图层直出
2025 年 12 月,通义千问推出独立的 Qwen-Image-Layered 模型探索透明图像生成。2.1 版本将该能力并入统一基础模型,根据 Prompt 语义自动判断输出普通 RGB 图像,还是包含 Alpha 通道的 RGBA 透明图层。
四、局部精准编辑:三色圈注、画笔涂抹与独立 Mask
传统局部重绘(Inpainting)通常只接收单张灰度 Mask,难以在单次操作中分区域执行不同指令。Qwen-Image-2.1 支持视觉提示词(Visual Prompting)。你可以用不同颜色的圆圈同时标出 3 个区域并分别指定修改内容,也可以用画笔涂抹,或传入独立的二值 Mask。
五、多达 10 张参考图输入:室内设计、虚拟试衣与多人合影
在实际业务中,传统生图模型处理多素材拼接时容易失真。例如合成模特人像与服装单品时,常出现颈部拼接痕迹或衣领结构变形。Qwen-Image-2.1 支持最多 10 张素材图联合输入,利用空间注意力机制统一各元素的透视关系与环境光照。
六、360° 全景图、信息图、分镜故事板与定格动画
除单幅静态图像外,Qwen-Image-2.1 还支持空间延展与连续分镜生成。输入一张自拍照可外推生成 360° 环视全景图,输入一套角色三视图可生成包含 9 个不同机位的分镜故事板。
七、48 组官方样张与 Prompt 示例库
下方收录了官方技术报告与评测中的 48 组生成案例。点击任意卡片可在全屏 Lightbox 中查看原图细节,点击右下角按钮可直接复制对应的官方 Prompt。
八、本地部署与 Diffusers 代码调用
模型权重已在 Hugging Face 与 ModelScope 开源,可通过 Transformers 与 Diffusers 库直接加载推理。以下代码演示如何调用 Qwen-Image-2.1 生成原生 RGBA 透明图像:
run_qwen_image_21_transparent.py(Python · Diffusers)
| 1 | import torch |
| 2 | from diffusers import QwenImagePipeline |
| 3 | |
| 4 | # 加载 Qwen-Image-2.1 7B 官方开源权重 (Bfloat16 精度) |
| 5 | pipe = QwenImagePipeline.from_pretrained( |
| 6 | "Qwen/Qwen-Image-2.1", |
| 7 | torch_dtype=torch.bfloat16, |
| 8 | device_map="auto" |
| 9 | ) |
| 10 | |
| 11 | # 提示词中明确指定透明通道生成 (pure alpha transparency) |
| 12 | prompt = ( |
| 13 | "A mythical crystalline wyvern dragon with translucent iridescent wings, " |
| 14 | "hovering mid-air, emitting subtle bioluminescence, pure alpha transparency background, " |
| 15 | "extremely sharp edges without fringe, ultra photorealistic, 8k resolution, cinematic lighting." |
| 16 | ) |
| 17 | |
| 18 | # 执行单步扩散生成 (直接产出 RGBA 4 通道图像) |
| 19 | image = pipe( |
| 20 | prompt=prompt, |
| 21 | num_inference_steps=30, |
| 22 | guidance_scale=4.5, |
| 23 | output_type="pil" |
| 24 | ).images[0] |
| 25 | |
| 26 | # 保存为支持无损透明通道的 PNG 格式 |
| 27 | image.save("qwen_crystal_dragon_transparent.png", format="PNG") |
| 28 | print("✅ Direct RGBA transparent image successfully saved!") |
推荐硬件配置与环境参考
最低配置(量化 / BF16)16GB VRAMRTX 4080 / 4090 或 Apple M2 / M3(16GB 以上)
推荐生产配置(10 图多参考)24GB VRAMRTX 3090 / 4090 / A10G 显卡
高并发推理集群80GB A100 / H100支持百毫秒级 KV Cache 高并发吞吐
九、模型获取与落地建议
你可以从 Hugging Face 或 ModelScope 下载 Qwen/Qwen-Image-2.1 权重文件。单卡 16GB 显存设备可运行单图与 RGBA 透明图层生成;若需运行 5 张~10 张参考图的电商商拍合成或室内软装排版,建议使用 24GB 及以上显存显卡并开启 KV Cache 复用。
接入业务流水线时,透明素材场景可在提示词中写明透明背景要求并输出为 PNG 格式;多区域局部修改场景建议传入独立二值 Mask 或分色圆圈标注图,以减少非编辑区域的像素变化。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。