
迭代 1 年的卡兹克 Agent 自动化系统架构与实战分享
完整收录卡兹克实战架构 · 附工程拆解与交互沙盒
卡兹克:耗时 1 年搭建的个人 Agent 自动化系统架构详解
原作者:数字生命卡兹克(@Khazix0918) · 发布日期:2026-11-02 · 本文完整保留卡兹克关于事件中台、多模型路由、本地 CI 与飞书审批的全部架构细节及 18 张配图,并提供可交互的「票拟 + 批红派单模拟器」与「rules.json 多模型调度工作台」。
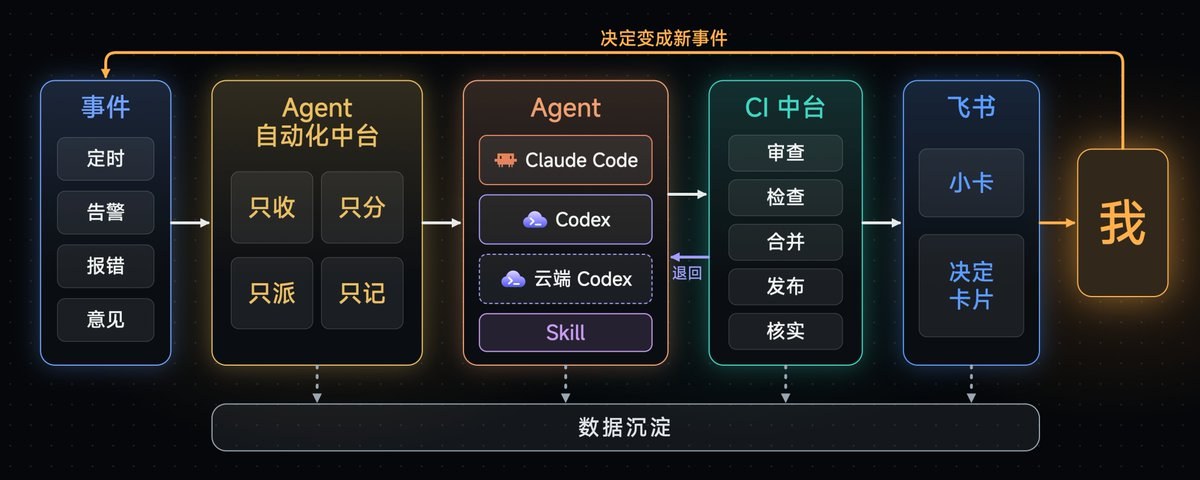 卡兹克 Agent 自动化系统五段式架构图
图 0:卡兹克 Agent 自动化系统核心流程总览(事件 → Agent 自动化中台 → Agent → CI 中台 → 飞书小卡决定卡片 → 人工拍板 → 决定变成新事件)
序言:从朱元璋 8 天 1660 件奏折看 Agent 时代的注意力瓶颈
上周六 DeepSeek 发布了一篇技术长文《Super-agent 设计探索:迈向更自主的 Agent 系统》,其中的架构思路很值得开发者细读。
整篇文章里最关键的判断,就在开篇这一句:
“一个人通常只能同时跟进 3 到 5 个活跃的会话,在这种设计下,单任务的上限取决于模型能力,多任务的上限取决于人的注意力。”
在整套 Agent 系统里,人的注意力是最稀缺的资源,也是最大的吞吐瓶颈。
历史上早有完全相同的案例。
1380 年,朱元璋借胡惟庸案废除中书省与丞相,六部直接对皇帝负责,天下政务全部直通他本人。
后果很快显现:洪武十七年九月,给事中张文辅给朱元璋报了一笔账。从十四日到二十一日共 8 天时间,内外各衙门送上来的奏札达 1660 件,里面包含待处理事务 3000 多件。
平均下来每天 200 多份奏札,朱元璋一个人每天要处理 400 多件事。
朱元璋向来勤政,面对这个强度自己也撑不住,当场对大臣说:“朕一人处此多务,岂能一一周遍。”
换成白话就是:
我一个人管这么多事,不可能每一件都顾得过来。
皇帝的注意力上限,跟普通人其实差不多。
六百多年后进入 AI 时代,每个人手头都带着一批干活的 Agent,只是递奏折的对象从六部九卿变成了一个个模型会话。
如何设计 Agent 调度机制,把自己的注意力从琐碎执行中抽离出来,只做关键决策,是每个重度使用者都要解决的课题。
这种协作能力对应到团队管理里,就是:
领导力。
这篇文章整理了我过去近 1 年搭建个人 Agent 自动化系统的架构与实战经验,拆解如何让 Agent 自动接单处理日常事务,以及人如何抽身出来只做关键拍板。
工程批注 01 · 为什么 3~5 个聊天窗口是开发者的并发上限
卡兹克借“朱元璋日批 200 份奏折、处理 400 件事”的典故,指出了多数开发者使用 Claude Code 和 Codex 的常见瓶颈:把 Agent 当成需要人眼盯着交互的聊天框(Chat Session)。下表对比了三种协作架构的差异:
| 对比项 | 阶段一:窗口监工模式(洪武硬扛制) | 阶段二:零散脚本轮询(多头藩镇制) | 阶段三:卡兹克中台制(内阁票拟 + 皇帝批红) |
|---|---|---|---|
| 任务触发起点 | 人手动打开终端输入指令(人不说话则全体停工) | 各处散落的 Cron 定时脚本与独立 Bot | 统一事件驱动(Webhook 实时触发 + 集中排程) |
| 并发规模上限 | 3~5 个窗口(受限于人脑工作记忆与上下文切换) | 10~15 个脚本(易出现并发覆盖与状态丢失) | 单月合入近 1000 个 PR(统一鉴权、去重、排队与并发锁) |
| 人的角色与精力开销 | 人工盯屏监工 + 手动审查 + 手动部署 | 多个告警群轮流刷屏,产生告警疲劳 | 仅在触碰 7 类高危红线时,在飞书点击一次审批卡片 |
1. Agent 自动化系统
先谈我对 Agent 自动化的定义。
目前多数人使用 Agent 仍停留在对话模式:
打开 Claude Code 或 Codex,输入一项任务,盯着它跑完,人工检查结果后再发下一条指令。
这种模式的局限很明显:所有事情的起点都是你。只要你不打开那个终端窗口,什么都不会发生。不管模型本身多强,你能同时推进的任务永远受限于盯得过来的那 3~5 个窗口。
要用好 Agent 必须切换成团队管理视角:把触发任务的起点从人身上拿掉,用外部事件信号自动唤醒 Agent 干活,无需事事等待人工下令。
日常事务遇到信号就由 Agent 自行处理完毕;只有遇到拿不准或触及安全边界的事项,才上交到你面前做决定。
这就是搭建个人 Agent 自动化系统的核心目标。
就像带研发团队一样,成熟的团队不会事事向你汇报,而是自己推进落地,只把需要拍板的选择题交给你,其余环节放手信任即可。
基于这套思路,我搭建的整体系统架构与流转路径如下:
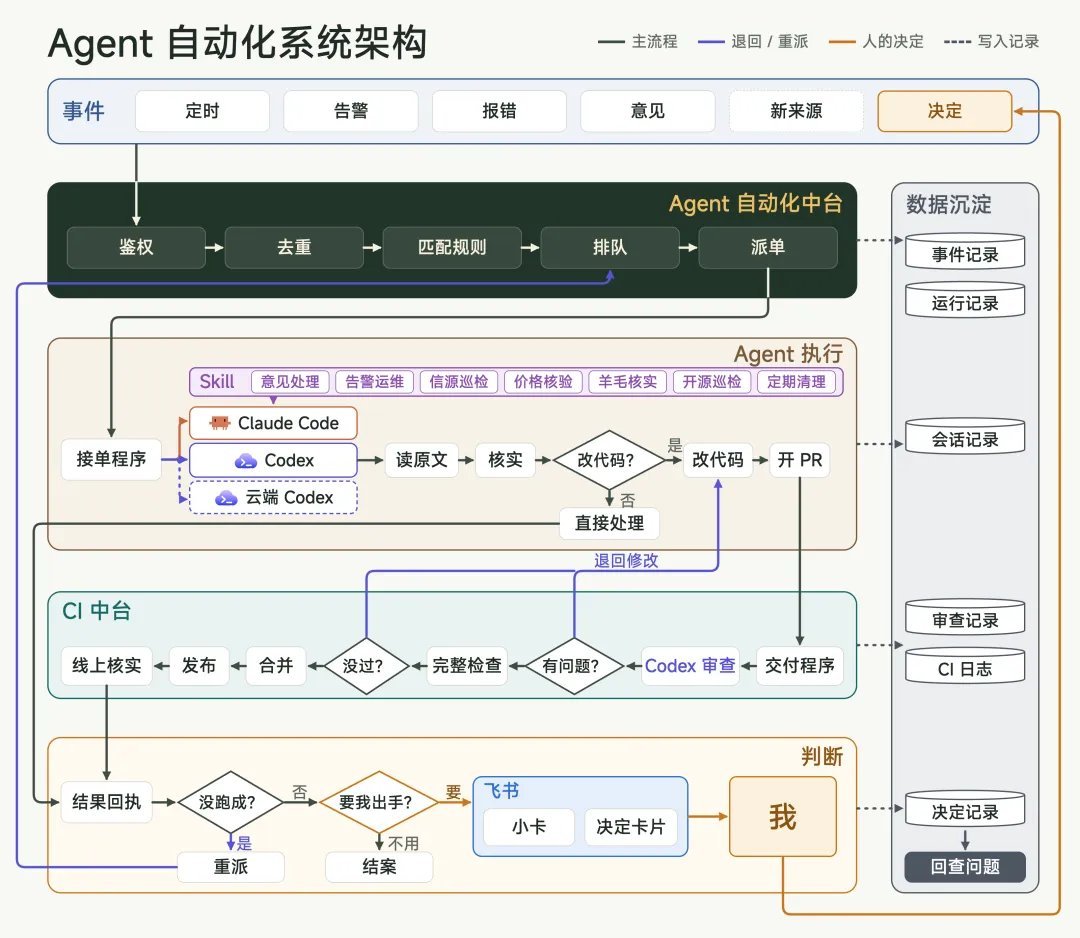 Agent 自动化系统架构图
图 1:Agent 自动化系统分层架构图(事件层 → Agent 自动化中台 → Agent 执行层 → CI 中台 → 飞书判断层 → 右侧全程任务记录)
我日常只需参与最后一步,我称之为“批奏折”。
飞书里的 AI 助理“小卡”会推送一张结构化决定卡片,我点一下选项按钮即可完成审批。
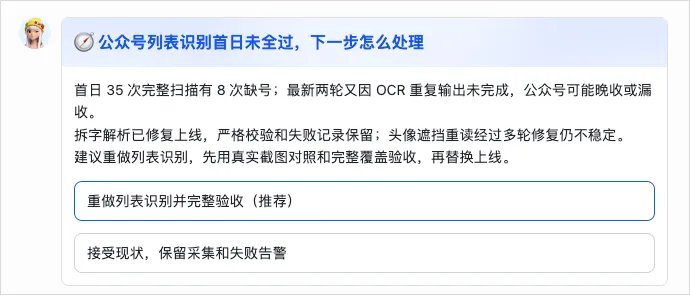 飞书 AI 助理小卡推送的决定卡片
图 2:飞书 AI 助理“小卡”推送的决定卡片(票拟方案 + 推荐选项点击批红)
点完按钮后,挂起等待的 Agent 立即收到审批结果,继续自动完成后续工作。
下面顺着数据流向,逐个模块拆解实现细节。
INTERACTIVE WORKBENCH 01 · 动态流程仿真沙盒
内阁“票拟 + 批红” × Agent 自动化五层流水线模拟器
点击切换 4 类真实生产信号,查看从事件触发到飞书审批的流转过程
1事件层(统一五元组格式)virxact-hub :: feedback.new
对象:#12 ·摘要:同事给虚实中台提了一条新交互与字段优化意见(后又补了一句话和一张截图)
2Agent 自动化中台(鉴权 → 去重 → 匹配 rules.json → 50s 长轮询派单)tell: "needed"
去重引擎:已合并去重(拦截同事连续追发的 2 条补充事件,保持单会话串行)
目标节点与模型:Claude Opus 5.5(High 推理)(m5-claude(M5 Pro 本地 50s 长轮询接单))
3Agent 执行层(挂载专属 Skill:hub-feedback)读写代码 + 开 Draft PR
读取意见原文与截图 → 核实 ~/code/work/virxact-hub 代码实现 → 发现涉及产品方向调整则先挂起等待拍板;若属明确交互优化则直接改代码并开 Draft PR。
4本地 M4 CI 中台(审查 → 检查 → 合并 → 发布 → 线上核实)耗时:2 分 18 秒
Codex(GPT-6.1 Sol)只读审查 2 轮,发现 1 处真实问题并自动修复 1 处;M4 一次性虚拟机:Typecheck + 全量测试 + 构建 + DB 只增不改校验通过(跑完销毁 VM)
点击上方卡片按钮,模拟卡兹克在飞书里点击审批卡片后的事件回流过程
2. 自动化中台
先看最核心的调度枢纽:Agent 自动化中台。
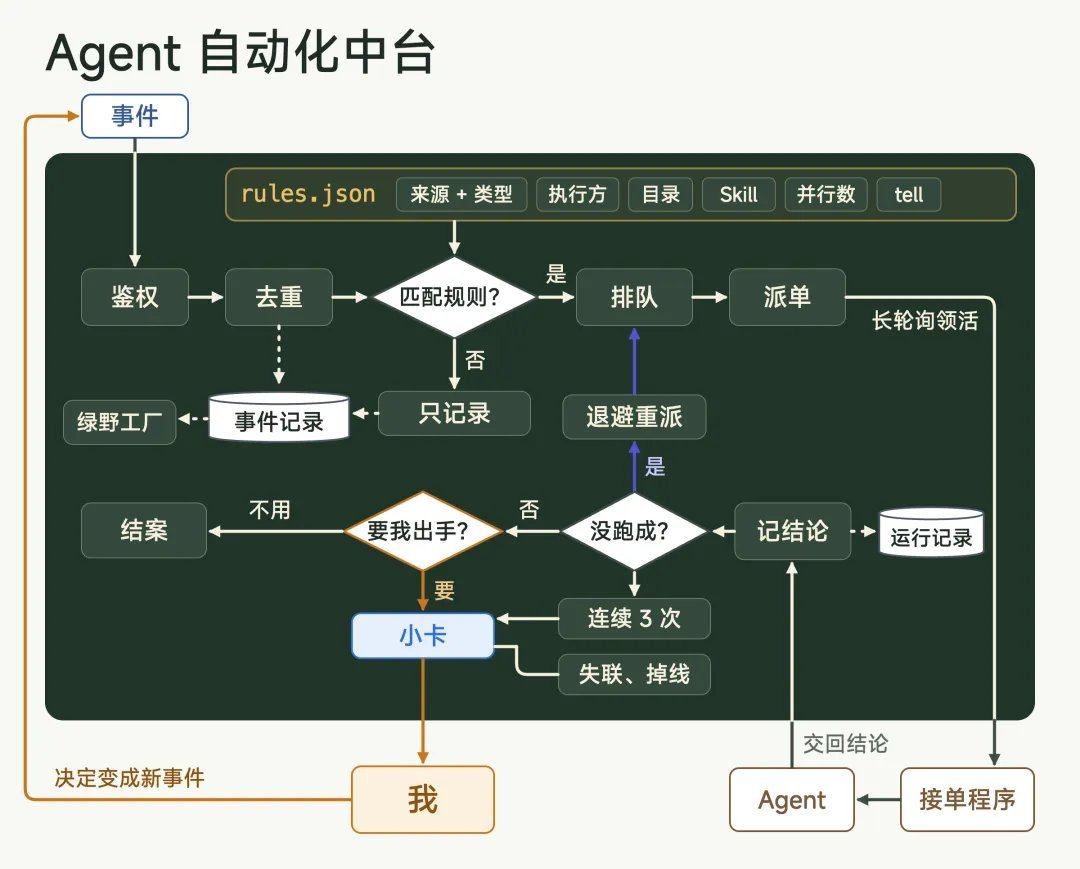 Agent 自动化中台架构图
图 3:Agent 自动化中台内部流转机制(事件 → 鉴权 → 去重 → 匹配 rules.json → 排队 → 派单 → 50s 长轮询领活 → 记结论 → 判断是否需人工介入)
既然要把人从日常触发起点中移开,何时、由什么信号唤醒 Agent 开始干活,就需要一套统一规范。
这个触发信号就是“事件”。
任何外部变化或定时动作,都可以抽象为一条标准事件。
例如定时任务属于主动轮询事件,每分钟或每小时查一次状态;Webhook 属于被动推送事件,包括收到新消息、收到邮件或监控系统触发告警。
单纯的定时任务,Claude 和 Codex 桌面客户端本身已经支持得很好,设好每天几点运行即可。我手头有一批常规巡检任务就直接放在客户端里跑:
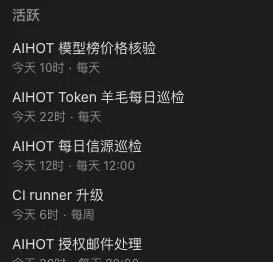 Claude / Codex 应用内的活跃定时任务列表
图 4:日常活跃的定时巡检任务(AIHOT 模型榜价格核验、Token 额度每日巡检、每日信源巡检、CI runner 升级与授权邮件处理)
每天下午,Codex 还会自动从微信群聊天记录、X、小红书和抖音搜索用户对 AIHOT 的讨论与反馈,汇总成评估报告,给出是否值得排期优化的建议。
每周它会操控本地浏览器,依次打开豆包、DeepSeek、千问、元宝、ChatGPT 和 Gemini,提问预设的业务问题,检查 AIHOT 在各平台的 GEO 展现表现。
AIHOT 开源后,每天都有社区开发者在 GitHub 提 Issue 和 PR。Claude 每天 18:00 自动扫描仓库,处理问题并审查合入社区提交的改动。
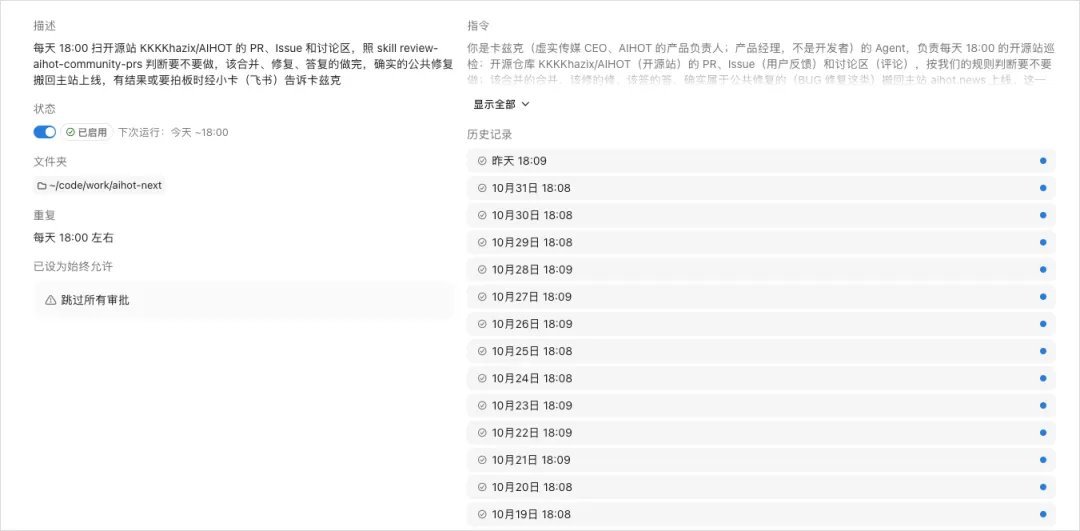 每天 18:00 自动扫描开源站 KKKKhazix/AIHOT 的定时任务配置
图 5:每天 18:00 自动扫描开源仓库 KKKKhazix/AIHOT 的 PR、Issue 和讨论区,按 review-aihot-community-prs Skill 处理并同步回主站上线
但定时轮询天然不够及时。同事刚提了一条产品意见,或者线上突然报错,显然不能等到第二天早上的定时任务才去响应。
这类实时事件一发生就得立刻唤醒 Agent,必须依赖上游系统主动推送 Webhook。
而找上门来的事件来源很多,飞书消息、飞书机器人、邮件和各类监控告警的原始报文结构各不相同。
同时,不同模型的能力长板与计费成本有明显差异。为了兼顾处理质量并节省 Token,不同事件触发后需要唤醒的 Agent、模型和推理深度也各不相同。
比如复杂开发需要唤醒 Claude Code 运行 Claude Opus 5.5(high 推理);无接口的网页采集需要唤醒 Codex 运行 GPT-6.1 Terra(xhigh);线上故障定位与修 Bug 则交给 GPT-6.1 Sol(xhigh)。
如果每接一种新事件都单独写一套脚本去解析来源、唤醒对应的模型,维护三五个还能应付,攒到几十个必定乱成一团。
为了避免失控,我自建了这个自动化中台统一接管所有事件触发,后续也把定时任务一并纳入集中管理。
中台本身是一个轻量独立服务,部署在一台云端轻量服务器上,配有独立域名与数据库。
它的职责很清晰:所有事件一律先发到这里,由中台统一匹配规则、唤醒对应的 Agent 并回收执行结论;遇到真正需要人工拍板的事项,再通过飞书推送决定卡片。
中台做的第一件事是统一事件格式。无论上游是哪个系统,发进中台的都是一条简短的结构化消息,只包含五项信息:来源(source)、类型(type)、对象(objectId)、一句话摘要和原处链接。例如虚实中台发来一条 feedback.new #12,代表同事给虚实中台新提了编号为 #12 的产品意见。
格式统一后,中台收到事件就去查路由规则。所有规则集中写在一个 rules.json 文件里,例如处理同事意见的规则配置如下:
rules.json(卡兹克原文规则配置)
| 1 | { |
| 2 | "name": "中台意见", |
| 3 | "when": { |
| 4 | "source": "virxact-hub", |
| 5 | "types": ["feedback.new", "feedback.followup", "feedback.decided"] |
| 6 | }, |
| 7 | "to": "m5-claude", |
| 8 | "cwd": "~/code/work/virxact-hub", |
| 9 | "skill": "hub-feedback", |
| 10 | "ask": "按其中“被 Agent 自动化中台叫起来的”一节处理。", |
| 11 | "group": "hub-feedback", |
| 12 | "parallel": 3, |
| 13 | "tell": "needed" |
| 14 | } |
这段配置的含义很直白:收到产品新意见、同事补充说明或我拍板后的决定时,统一派给 M5 上的 Claude Code,在虚实中台代码目录下按 hub-feedback 这个 Skill 处理。每条意见单独开一轮会话,同一条意见同一时刻只跑一轮,最多并行跑 3 条。执行完毕后,只有在需要我拍板时才发通知,其余情况直接静默结案。
唤醒本地 Agent 时有个网络障碍:Webhook 能把消息推到云端中台,但云端推不进我的本地 Mac。我的 Claude 和 Codex 都装在家里与办公室局域网的两台 Mac 上,外网无法直接连入。
解决办法是反向拉取:每台 Mac 上常驻一个接单程序,主动挂在中台上等待任务,单次连接最长等待 50 秒。一有任务立刻领走,超时没活就重新挂起等待。这样本地 Mac 无需暴露到公网,响应速度也与实时推送相当。
这套中台跑下来有五个直接收益:
第一,接入新事件只需改配置。不用另写对接脚本,往 rules.json 里加一条规则即可。直接让 Agent 修改配置文件并通过检查,几分钟就能上线生效。
第二,切换执行模型只需改一行字。哪类任务派给谁全写在规则里。今天交给 Claude Opus 5.5,明天想换成 GPT-6.2 Astra,改一行字段就能完成替换。
第三,统一拦截重复事件。自动化系统里同一件事重复发来是常态:网络抖动会触发上游重发;同事提完意见又补一句话、贴一张截图,也会连续产生多条事件。如果每来一条都唤醒一个新 Agent,几个会话同时改同一份代码必然互相覆盖。由中台统一合并去重后,同一对象始终保持单会话串行。
第四,所有通知收敛到唯一出口。不管哪个 Agent 或哪条任务需要找我,只走飞书里的 AI 助理“小卡”这一条通道。规则里限定了仅在需要人工判断时才发消息,杜绝多个脚本和机器人轮番刷屏。
第五,全程留存可回溯的任务记录。所有事件都经过中台流转,触发时间、来源、接单 Agent、最终结论、是否请求人工介入以及后续处理方式,全部记在中台数据库里。点开任意一条任务,还能直接跳回当时 Agent 干活的原始会话排查过程。长期积累后,哪条流水线最忙、哪个模型干活最多、哪类任务经常报错都一目了然,后续换模型或调规则都有数据支撑。
集中调度还顺带满足了我对可视化的偏好。受《戴森球计划》这类自动化建造游戏影响,我很喜欢直观看到所有流水线自动运转的状态。
于是我专门做了一个可视化网页,把整套流水线做成微缩城镇展示,并与现实世界的时间和天气同步。外面下雪时,网页里的自动化小镇也会同步下雪。
下面是之前录制的实机运行视频:
卡兹克《戴森球计划》风格微缩 Agent 自动化小镇实机演示(同步现实时间与天气)
原演示推文背景补充(@Khazix0918):
“花了 5 天时间把这套 Agent 自动化流水线可视化界面做出来了。第一版只是普通网页列表,后来参考《戴森球计划》改成了微缩流水线小镇,平时可以接个桌面副屏展示。画面里的产线对应预设自动化规则,发出的包裹代表单次触发任务,自动路由到两台机器的 Agent 上执行,并与现实世界的时间和天气同步,现实下雪时小镇里也会下雪。开发分工上,由 Claude Opus 5.5 搭建整体视觉框架,调度 GPT-6 Astra 完成建模与渲染,再由 Codex 在本地 CI 机器上跑端到端测试。”
自动化中台的作用,就是让每个事件一发生就能自动匹配该干活的 Agent,只把极少数需要人工决策的事项递到我面前。
INTERACTIVE WORKBENCH 02 · 声明式事件路由生成器
定制你的 rules.json 路由表 + 50s 内网长轮询设计解析
3. Agent 执行
事件触发并完成路由后,下一步是本地 Agent 领单与执行。
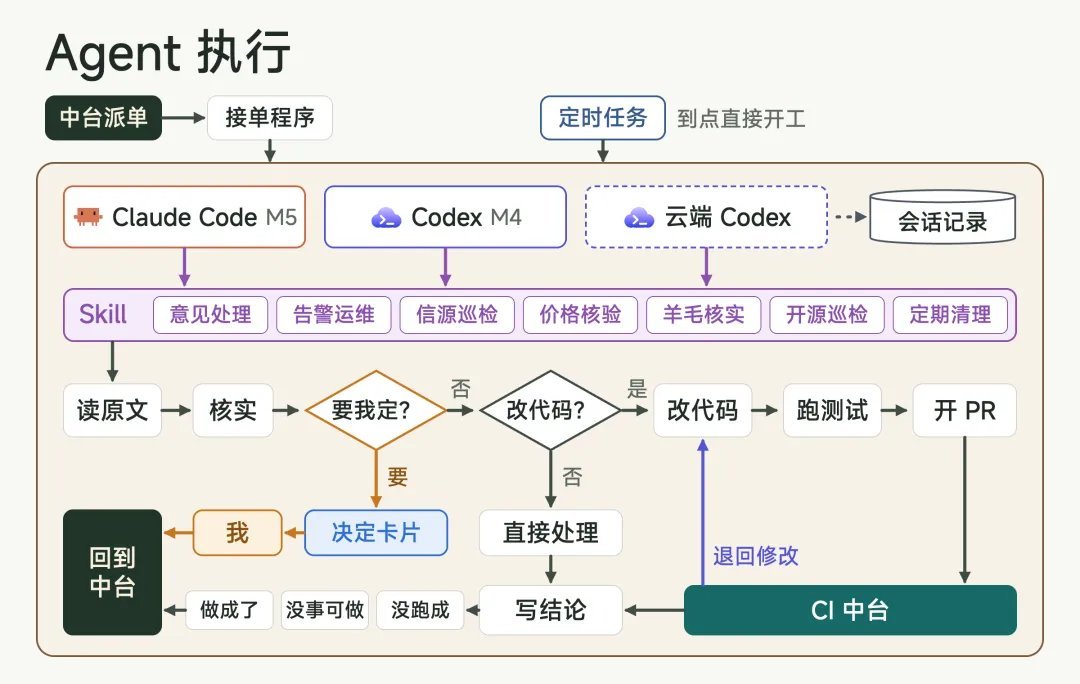 Agent 执行流程图
图 6:Agent 执行层工作流(中台派单/定时任务 → Claude Code M5 / Codex M4 / 云端 Codex → 挂载 7 类 Skill → 读原文并核实 → 判断是否需人工拍板或修改代码 → 开 PR 移交 CI 中台)
先说明一个现实前提:我们的 Token 额度有限。即使订阅了每月 200 美元的 Claude Ultra 套餐,高强度跑自动化任务,3 天就会用掉当周总限额的近 90%。
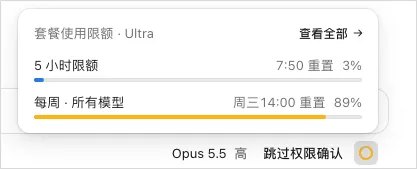 Claude 200 美元 Ultra 套餐使用限额截图
图 7:每月 200 美元的 Claude Ultra 会员在高强度自动化负载下,3 天消耗了每周所有模型限额的 89%
加上几款主流模型擅长的任务类型各有侧重,必须按分工精细调度,才能控制住订阅成本。
目前我采用每月 200 美元 Claude 会员 + 100 美元 GPT 会员的组合,日常吞吐基本够用。
主力调度以下三个模型:
Claude Opus 5.5:承担主力开发工作。像 AIHOT 的功能迭代、处理同事对公司中台提的改进意见这类复杂度高、需要自主拆解与判断的任务,基本都由它完成。我手头几个核心仓库的大部分代码也是它写的。
GPT-6.1 Sol:负责所有项目的日常运维,包括告警排查、每日早报巡检与到期复查。遇到异常它会自行查日志定位问题并直接提交修复补丁,准确率和 Token 性价比都很高。
GPT-6.1 Terra:专门负责浏览器与桌面操控。它能直接控制 Mac mini 上那个已登录各平台账号的本地 Chrome。前面提到的每天去社交平台搜 AIHOT 讨论,以及每周去 6 家 AI 平台问一遍 GEO 问题,这些没有公开 API 的数据采集全靠它处理。
我平时手动发起的任务也一律用 Claude 统筹。社区里常看到有人用 Grok 或其他轻量模型充当上层调度去指挥 Claude,这种排布很容易出问题:负责做决策和任务拆解的模型,推理能力与主动性必须最强;用弱模型去指挥强模型,顶层方向一旦跑偏,执行层越强错得越远。
硬件方面,我桌面配了两台 Mac mini:一台新买的 M5 Pro,一台去年买的 M4。
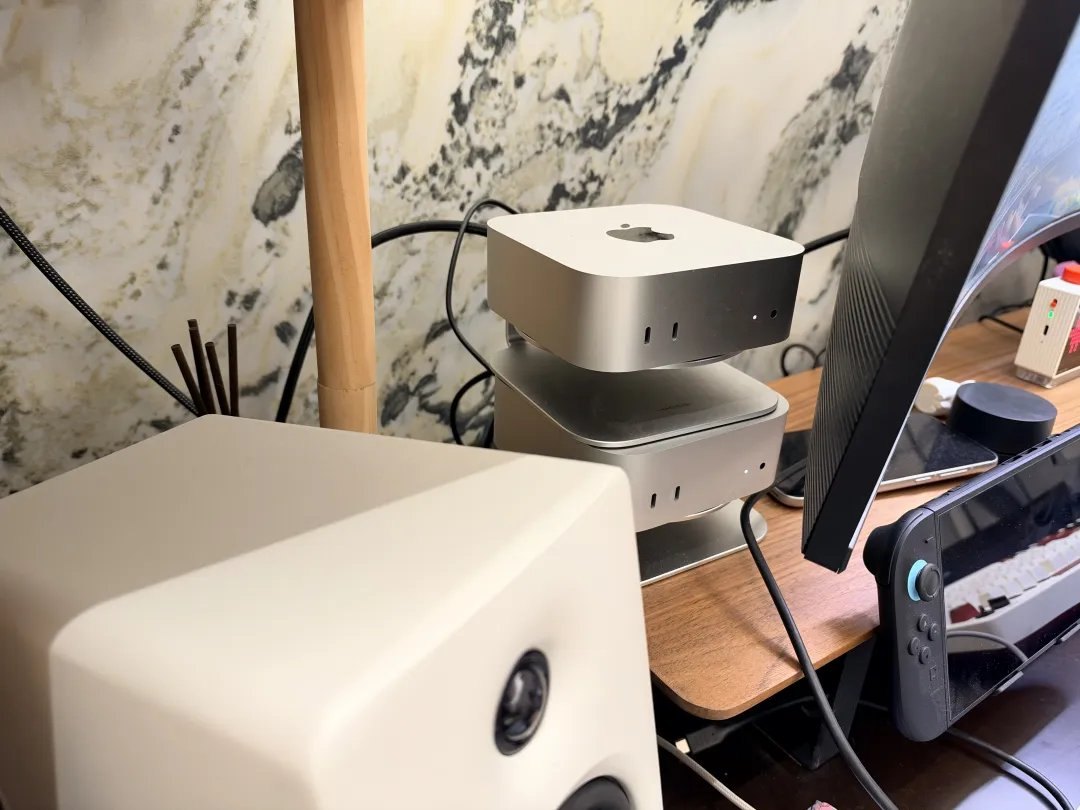 卡兹克桌面叠放的两台 Mac mini(M5 Pro 与 M4)实拍
图 8:桌面上下叠放的两台 Mac mini:上层 M5 Pro 用于日常主力办公,下层 M4 全天候运行 Agent 自动化与本地 CI 虚拟机
M5 Pro 是我的日常主力机,Agent 自动化任务基本都跑在 M4 那台机器上,两台设备通过局域网互通,核心执行层留在本地没有上云。
主要原因是我的代码仓库、发布权限、飞书身份,以及登录好各平台账号的 Chrome 全在这两台 Mac 上。
如果把 Agent 搬到云端服务器,就得把这些密钥和账号登录态在云主机上重新配一遍,维护繁琐且有安全隐患。
此外,海外云端 Agent 跨境访问国内北京的服务器经常慢甚至超时;涉及浏览器操控的任务更明显,像微信这类国内平台,一旦放到云端虚拟机浏览器里打开,很容易触发风控掉线。
两台 Mac mini 本身就是现成设备,待机功耗很低,24 小时常开也很稳定。
平时需要从 M5 Pro 查看或接管 M4 时,直接让 Agent 局域网调用或用 UU 远程桌面连接即可。
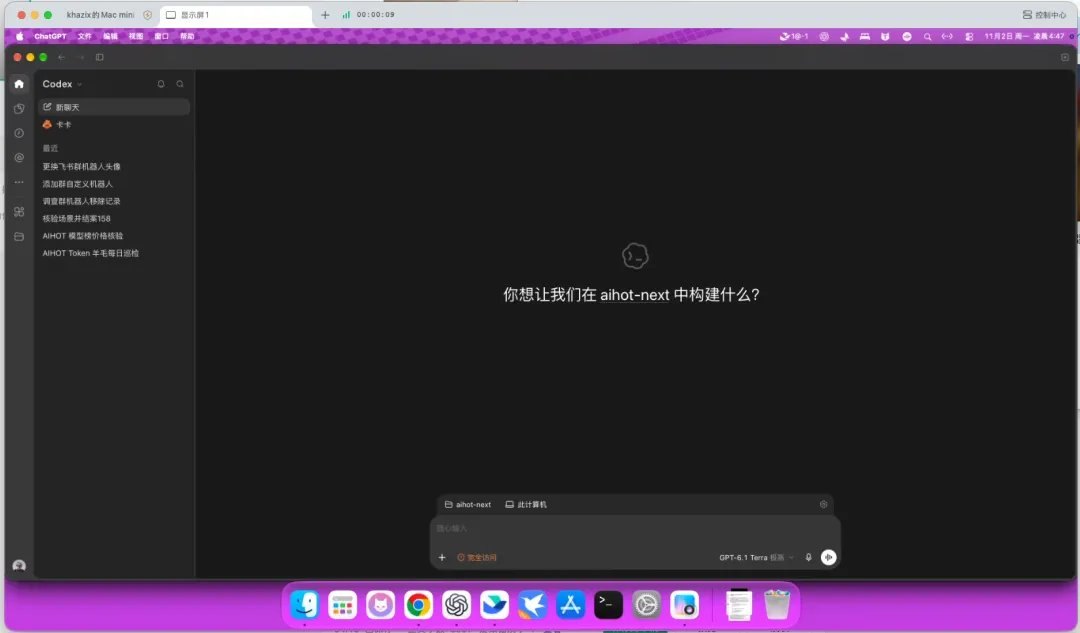 通过远程连接查看 Mac mini 上的 Codex(GPT-6.1 Terra 极高推理)运行界面
图 9:远程连接至卡兹克的 Mac mini,Codex(挂载 GPT-6.1 Terra xhigh 推理)正在处理群机器人移除调查与价格核验任务
在执行层里,另一个关键设计是每个自动化任务都配有专属的 Skill。
Skill 本质上是给 Agent 阅读的标准化操作流程(SOP),里面写清了执行规则、参考文档与配套脚本。
例如每周日早上 06:00 的定期清理任务绑定了专门的 sweep-aihot-leftovers Skill,负责清理这一周高频合入留下的冗余代码。清理范围包括重复实现、针对个案的临时补丁、功能停用后残留的废弃代码,以及变成流水账的文档。清理完成后会自动走测试上线。
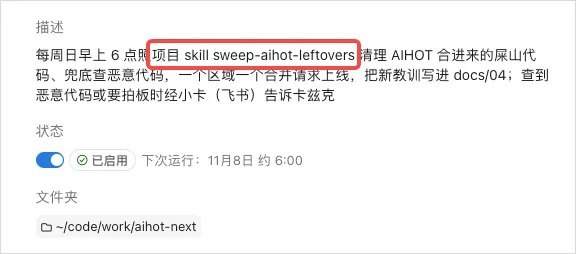 每周日早上 6 点 sweep-aihot-leftovers 清理冗余代码 Skill 配置
图 10:每周日早上 6 点绑定 sweep-aihot-leftovers Skill 自动清理冗余代码、排查可疑逻辑并将新经验写进 docs/04
这样做的好处是职责分离、易于维护:想调整某项任务的处理细节,直接修改对应的 Skill 文档即可,无需改动底层调度与执行器代码。
工程批注 02 · 每月 300 美元订阅组合与顶层模型选型原则
卡兹克的执行层设计体现了两条工程经验。第一是不用弱模型指挥强模型:顶层调度的推理能力决定了系统上限,若路由用了弱模型,底层的 Claude Opus 5.5 反而会放大方向偏差。第二是执行器与业务规则解耦:Runner 只负责接单拉起进程,具体规则全部封装在独立的 SKILL.md 中,周日早上还会运行 sweep-aihot-leftovers Skill 清理高频 PR 积累的技术债。
| 主力模型编队 | 订阅预算组合 | 核心职责定位 | 核心能力特点 |
|---|---|---|---|
| Claude Opus 5.5(High) | $200/月 Claude Ultra | 核心项目主力开发、复杂需求拆解、跨模块重构、日常主动任务统筹 | 复杂需求拆解与架构决策能力强,胜任顶层统筹角色 |
| GPT-6.1 Sol(xhigh) | $100/月 GPT 会员 | 全项目运维告警排查、早报巡检、到期复查、Bug 定位修复 + CI 只读代码审查 | 代码缺陷检出率高(298 个 PR 查出 333 条真实问题),Token 消耗低 |
| GPT-6.1 Terra(xhigh) | $100/月 GPT 会员 | 接管 M4 本地已登录 Chrome:跨微信群、小红书和抖音抓取反馈 + 6 大 AI 平台 GEO 巡检 | 本地 GUI 与真实浏览器操控稳定,避开无 API 限制与云端环境风控 |
4. CI 中台
Agent 写完代码并提交 PR 后,流程移交第三块核心模块:CI 中台。
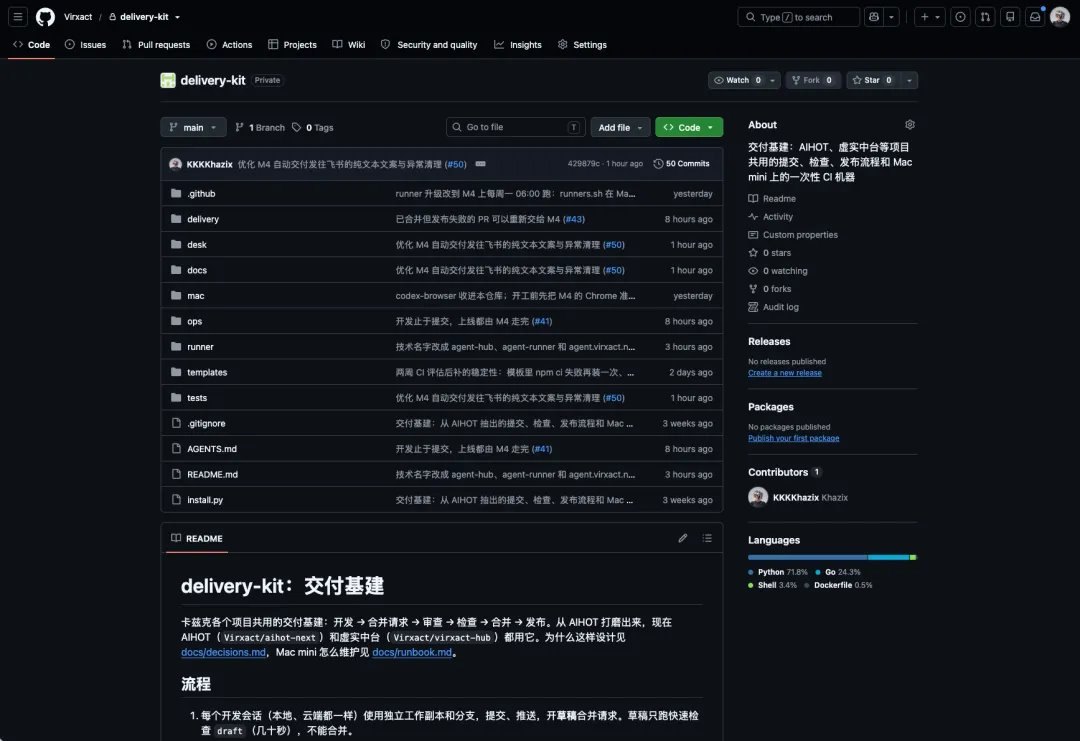 Virxact/delivery-kit 交付基建 GitHub 仓库截图
图 11:卡兹克抽离出的通用交付基建仓库 Virxact/delivery-kit(开发 → 合并请求 → 审查 → 检查 → 合并 → 发布,供 AIHOT 与虚实中台等所有项目共用)
CI(持续集成)是指代码写完后,自动完成代码审查、自动化测试、构建打包与部署上线的一整套流水线。
之所以单独抽出来自建 CI 中台,直接原因是日常提交量太大。
GitHub 官方自带的 Actions 托管机器,即使开了会员每月也只有 3000 分钟免费额度,超出后按分钟计费。单看 AIHOT 一个项目,整个 10 月合入了近 1000 个 PR,平均每天二三十个,每个 PR 还要来回跑多轮检查,免费额度很快就会耗尽。
我测算过,按目前的 PR 提交频次,如果继续跑在 GitHub 托管节点上,每月仅超额账单就要多付 50 美元以上。
于是我直接用家里那台 M4 Mac mini 自建了本地 CI 中台。硬件现成不用额外花钱,单核性能强,机器就在北京本地,构建和部署速度比 GitHub 海外节点快得多。
如果手头有 x86 Linux 主机做 CI 节点会更直接;Mac mini 是 ARM 架构,部分环节需要跑模拟环境,不过日常吞吐完全够用。
随着手头项目和 Agent 数量增加,我把这套本地 CI 升级成了通用中台,供所有仓库共用。
完整流水线如下:
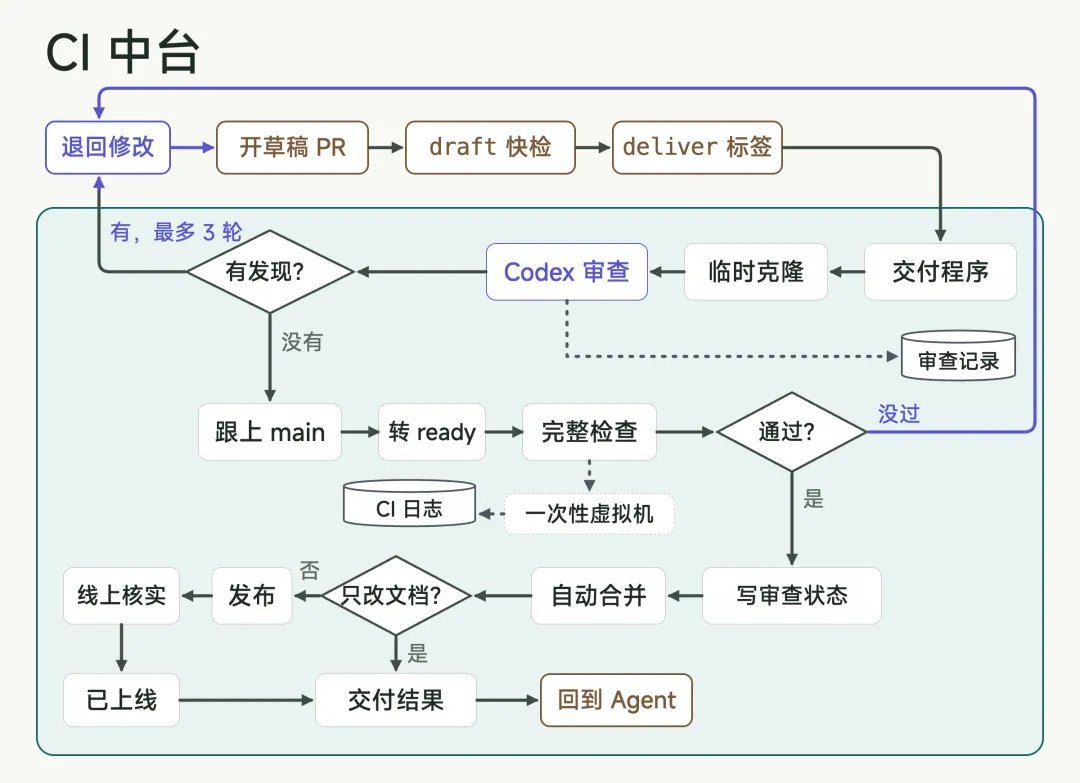 CI 中台五步流水线架构图
图 12:本地 M4 CI 中台五步流水线(开草稿 PR → draft 快检 → deliver 标签 → 临时克隆 → Codex 最多 3 轮只读审查 → 一次性虚拟机完整检查 → 自动合并 → 发布 → 线上核实 → 写回状态)
不管是 Claude 还是 Codex,开发 Agent 的权限边界都止步于提交代码并创建 PR,它自己不能直接发版上线。后续动作全部移交 CI 中台,按固定五步执行:审查、检查、合并、发布和核实。
第一步,Agent 交叉审查。这是整套交付系统里最关键的质量门禁。
目前几个主力仓库的代码大多由 Claude 编写,但每一个 PR 在合入主干前,都必须先过一遍 Codex(GPT-6.1 Sol)的独立代码审查。GPT 系列模型在静态找错上表现很扎实。
早期也遇到过反复挑刺不收敛的情况,Codex 能连续审上 10 轮。后来参考了 Anthropic 团队发布的《How the Claude Code team does code review》,每个改动合入前必审,但硬性限制最多审查 3 轮。
最近两周在 4 个项目上累计审查了 298 个 PR,Codex 报出 333 条问题,其中 306 条在合并前完成修复,包含 51 条最高严重等级的缺陷。
审查环境同时设了四条硬规矩:Codex 仅有只读权限(只能看不能改)、全程断网、读不到任何密钥,且只报真正会引发运行错误的缺陷,不挑代码风格。否则模型会挑出几十条命名或写法建议反复打回。
单次审查耗时中位数约 2 分多钟,Token 消耗约占该次开发任务的 5%~15%。
第二步,全量检查。代码审查通过后,开始跑完整检查:类型检查、全量测试、打包构建,以及“数据库只能新增字段、不能删改旧列”这类硬性校验,任一环节不过都不能合并。
这些检查全部跑在 M4 Mac mini 上。每个任务都会拉起一台全新的虚拟机,跑完测试连机器带临时身份一并删除,Agent 写的代码从不在宿主机系统上直接裸跑。
第三步,自动合并。审查和检查全部通过后,由 GitHub 自动合并。这两道门禁写死在 GitHub 分支保护规则里,没过审查或没过检查的代码,任何 Agent 和工具都无法合入主干。
第四步,隔离发布。代码合入主干后自动启动发布流程,同样派给 M4 单独开一台专用发布虚拟机执行部署。
第五步,线上核实。代码合并并发出后流程仍未结束。M4 上的交付程序会等发布脚本跑完,再去线上接口查询当前运行版本是否已包含本次改动,确认真实生效后把结果写回 GitHub,整轮交付才算完成。
负责开发的本地 Agent 只需看一眼 GitHub 状态,就能确认改动是否已顺利上线。
五步走下来,从 Agent 提交代码到线上核实完毕,耗时中位数只有 2~3 分钟,全程无需人工盯守,线上故障率与返工率大幅下降。
抽成通用 CI 中台后,后续启动任何新项目都能直接接入复用这套交付标准。
工程批注 03 · CI 中台的异构模型交叉制衡与沙盒隔离机制
- 编写权与上线权物理隔离
开发 Agent(Claude / Codex)的最高权限止步于创建草稿 PR(Draft PR),不持有直接推送到 main 分支或触发生产部署的密钥,从权限源头阻断误操作导致线上故障。
- 异构模型四不原则审查
Claude 写的代码统一交由异构的 GPT-6.1 Sol 审查,严格执行“只读、断网、无密钥、不挑代码风格只报真缺陷 + 最多 3 轮”,两周拦截 51 条高危缺陷,仅消耗 5%~15% Token。
- 一次性 VM + DB 只增不改
每次检查与发布均在 M4 上拉起全新一次性虚拟机(跑完连机带身份销毁,不污染宿主机),并硬性校验数据库迁移只能新增字段或表、不能删改存量列。
5. 在飞书上批奏折
常规开发与运维事务都由 Agent 自动处理完毕。
最后能推到我面前的,只有必须由人拍板的重大决策。
我没有额外引入其他独立的聊天机器人客户端,而是直接接入日常使用的飞书。遇到需要拍板的事项,AI 助理“小卡”直接往飞书推一张卡片,我第一时间就能看到:
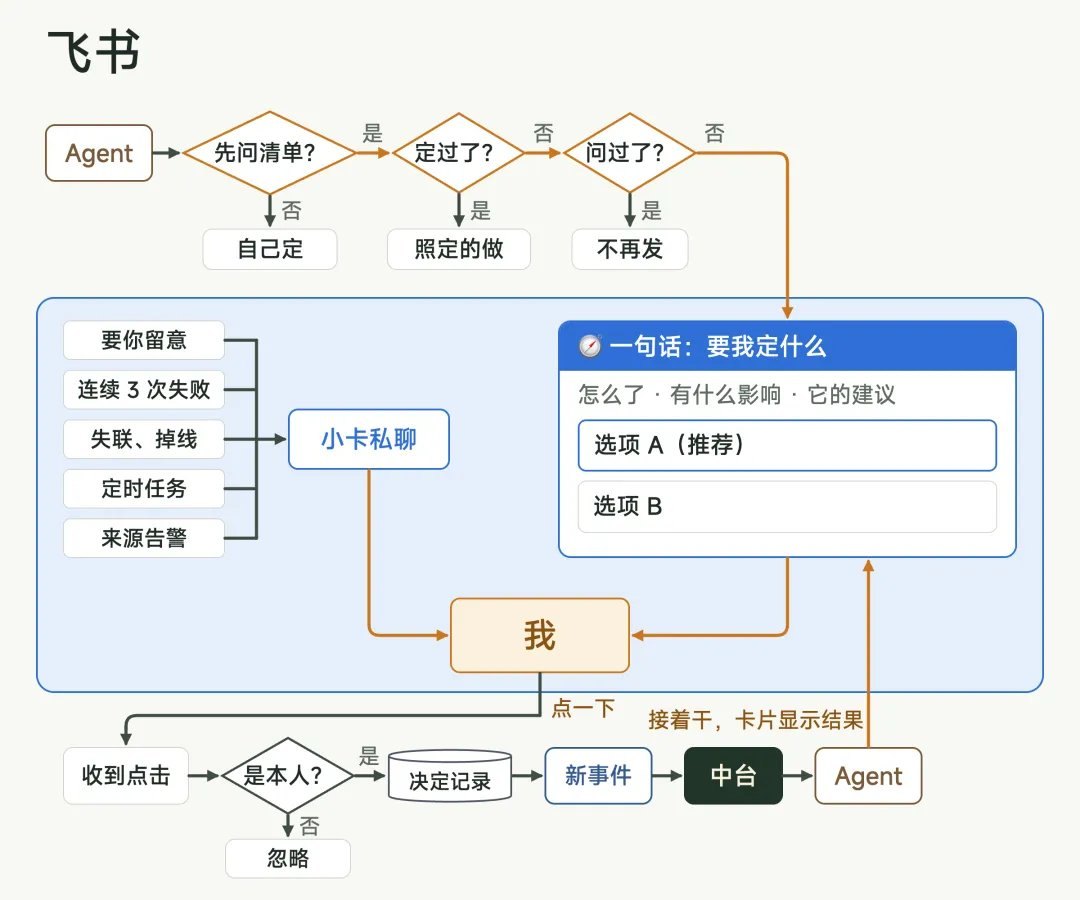 飞书决策过滤与事件回流流程图
图 13:飞书审批前的三道过滤门禁(属于先问清单?→ 之前定过了?→ 已经问过了?)与点击后“核验本人 → 决定记录 → 新事件 → 中台 → Agent”的回流路径
卡片下方直接提供可点击的选项按钮:
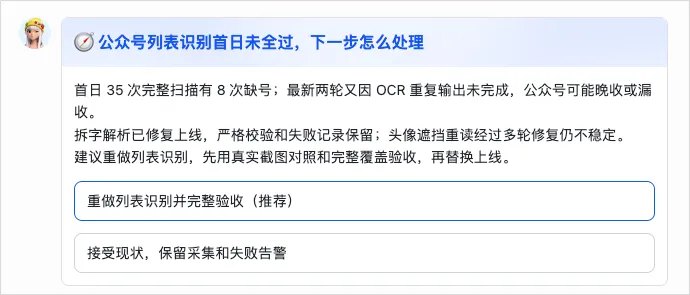 飞书决定卡片二选一交互界面
图 14:飞书决定卡片直接给出背景、影响范围与推荐选项,点击即可完成拍板
这套交互模式对应到历史制度里,就是明代内阁的“票拟”与“批红”。
朱元璋废丞相后一个人硬扛奏折,到了他的后代,逐步演化出了“票拟”与“批红”的分工机制。
奏章送上来先交内阁,大学士把建议处理方案写在小票上贴于奏章封面,称为“票拟”;皇帝审阅后若认可,用红笔批示确认即可下发执行,称为“批红”。
飞书里的这张决定卡片,就是 Agent 为我草拟的“票拟”。
我只做最终判断,点一下按钮即可完成审批。原先挂起等待的 Agent 收到回流事件后接着往下干,卡片也会自动更新为最终执行结论。例如 11 月 2 日凌晨 04:14,一名外部用户混进 AIHOT 的飞书主群,移除了群里的推送机器人后退群。推送报错随即触发自动化排查工作流,向我推来了下面这张审批卡片:
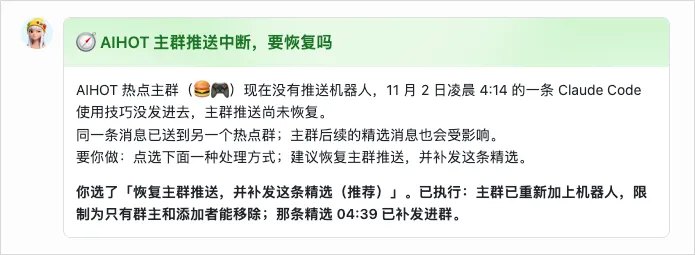 AIHOT 主群推送中断并恢复的飞书卡片实录
图 15:凌晨 04:14 主群推送机器人遭移除后自动触发告警票拟卡片,点击后自动重加机器人、收紧移除权限并于 04:39 补发精选消息
卡片交互虽然省事,但更关键的边界在于:到底什么事才应该推到我面前。
早期边界没收紧时踩过不少坑,有时一天能弹出几十条卡片,反而切碎了正常工作的注意力。
现在我把必须事先请示的事项收敛为 7 类红线:删数据、停服、花钱、对外发消息、改产品方向、新建或轮换密钥、修改权限。不触碰这 7 类红线的事务,Agent 全部自主做完并走 CI 上线。
同时定下一条规矩:我已经定过的事,Agent 不会问第二遍。
代码仓库里专门维护了一份《卡兹克定的事》,只记录我亲口拍板的决定,附带原话与日期。
旁边还配有一份《定了不做的事》,记录我明确拒绝过的提议。后续 Agent 再碰到同类诉求,直接照着文档回复结案,不再重复推送卡片。
整套流程里只有一件事我没有交给 Agent 自动过滤,每一条都会亲自过目,挑出有价值的内容再手动发给 Agent 执行落地。
这件事就是真实用户反馈。
每天我都会收到用户发来的直接反馈建议:
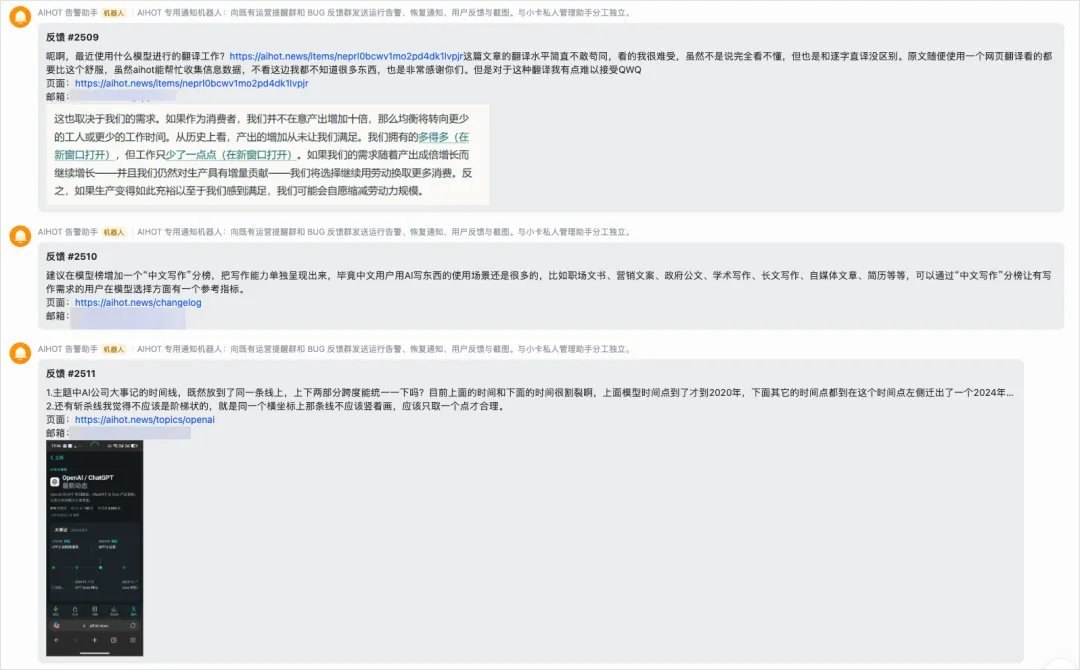 AIHOT 告警助手收集的真实用户反馈截图
图 16:AIHOT 告警助手推送的真实用户反馈(#2509 翻译质量反馈、#2510 增加“中文写作”分榜建议、#2511 时间线坐标轴优化建议)
只要评估下来合理可行,每一条我都会复制发给 Agent 修复上线,并在解决后亲自给用户的邮箱写一封回信告知进展。
6. 一年实践复盘
一年前,我还是一个不懂代码开发的设计师,连 CI 和 CDN 是什么都没接触过。
一年后的今天,我搭起了这套个人 Agent 自动化系统,做出了百万月活的公益产品 AIHOT 并开源,在 GitHub 上获得了 9000 Stars。
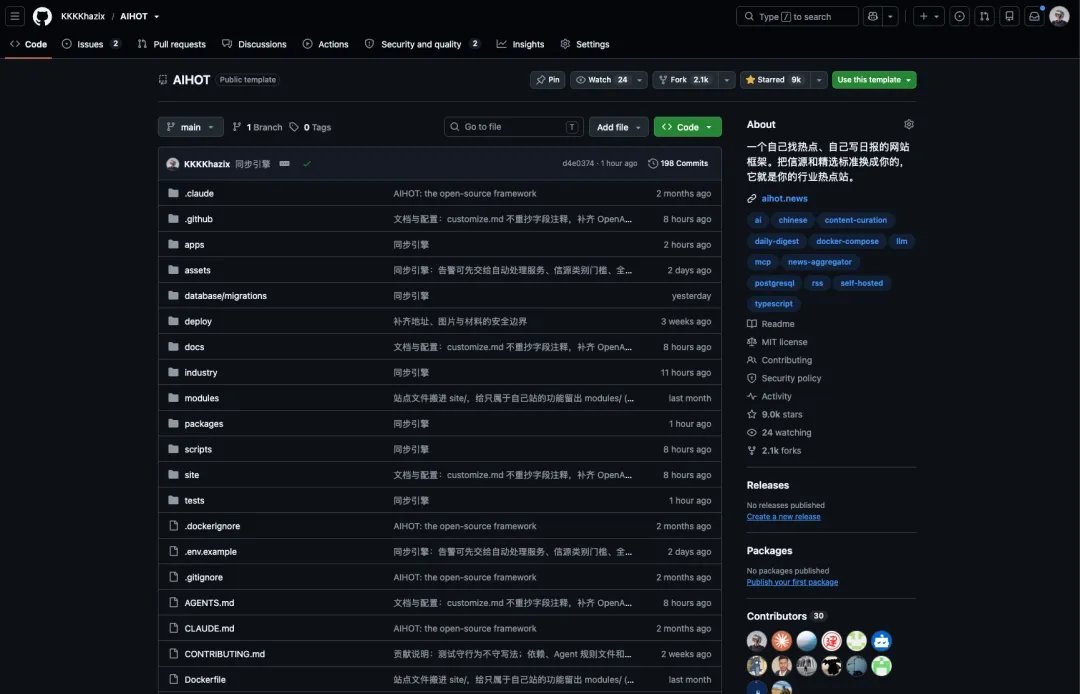 开源项目 KKKKhazix/AIHOT 获得 9.0k Stars 仓库截图
图 17:开源仓库 KKKKhazix/AIHOT(自动抓取热点与生成日报的网站框架)在 GitHub 获得 9.0k Stars 与 2.1k Forks
我同时用这套架构搭起了公司内部的业务中台(详见《我花了 5 天时间,对公司进行了一场 AI 化改造》),用事件驱动与 Agent 协作的方式持续迭代日常业务。
EXECUTIVE BLUEPRINT · 核心治理清单
复刻卡兹克 Agent 自动化系统的两项核心配置(7 类审批红线 + 双决策档案)
必须交由人工“批红”的 7 类高危红线(先问清单)
-
- 删数据(Data Deletion):任何破坏性删除表、集合或生产历史记录的操作;
-
- 停服(Service Downtime):会导致线上服务中断、维护关停或核心路由下线的变更;
-
- 花钱(Financial Spend):采购新云资源、升级付费套餐或触发超额账单的行为;
-
- 对外发消息(External Broadcast):向用户群、公域社媒或外部客户批量发送通知;
-
- 改产品方向(Product Direction Shift):改变核心交互逻辑、功能取舍或产品定位;
-
- 新建或轮换密钥(Secret Rotation):API Key、证书或环境变量的生成与替换;
-
- 修改权限(Permission Escalation):变更代码仓库、群组管理员或服务器访问控制。
避免重复打扰的双决策文档机制
文件一:《卡兹克定的事》(decisions-approved.md)
只记录负责人明确拍板通过的决定,附带决策原话与日期。Agent 在触发飞书卡片前先检索此文件,已有先例则直接按既定方案执行。
文件二:《定了不做的事》(decisions-rejected.md)
记录负责人明确拒绝过的需求或提议。当社区 PR、同事反馈或巡检报告再次提出同类诉求时,Agent 直接引用该文件回复并结案。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。