
本地大模型下载指南:读懂 Hugging Face 模型卡与量化参数
作者:雪瑜(@xueyu1125)•发布日期:2026-09-01•本地大模型下载指南
 本地大模型下载与 Hugging Face 参数解读指南
首次在 Hugging Face 搜索本地模型时,常会遇到一个困扰:页面上的单个缩写似乎都见过,组合在一起却不知道该下载哪一个文件。
以 Qwen3.8-27B 为例,搜索结果里可能同时出现原版、FP8、4bit、MLX、GGUF 和 AWQ。点进 GGUF 仓库,又会看到 Q4_K_M、IQ4_XS 等十几个权重文件;查阅社区教程时,还会同时遇到 Transformers、llama.cpp、Ollama、MLX、MLX-LM 和 MLX-VLM。
刚开始接触时,很容易把不同层级的概念混在同一维度比较,例如纠结 GGUF 和 MLX 哪个更好、误以为 Ollama 和 llama.cpp 是两种文件格式,或者把 Dense 和 MoE 当成两种量化精度。
本文目标:
本文聚焦首次下载本地模型前必须理清的四个问题:硬件提供什么资源、模型采用什么结构、权重使用什么精度与格式,以及用哪款工具运行模型。理清这四点,就能直接按硬件条件选对下载文件。
01|将本地运行栈拆分为五层
理解本地大模型的关键,是先明确每个技术名词所属的层级:
| 1 | 硬件资源 |
| 2 | Windows + NVIDIA:内存 RAM、显存 VRAM |
| 3 | Apple Silicon:统一内存 Unified Memory |
| 4 | ↓ |
| 5 | 模型本身 |
| 6 | Qwen3.8-27B、Dense / MoE、Base / Instruct、文本 / 多模态 |
| 7 | ↓ |
| 8 | 权重精度与量化 |
| 9 | BF16、FP16、FP8、8bit、6bit、4bit、AWQ、GPTQ |
| 10 | ↓ |
| 11 | 文件或仓库组织 |
| 12 | Safetensors、GGUF、MLX 转换仓库、配置、Tokenizer、权重分片 |
| 13 | ↓ |
| 14 | 推理框架与上层工具 |
| 15 | Transformers、llama.cpp、MLX、MLX-LM、MLX-VLM、Ollama、LM Studio |
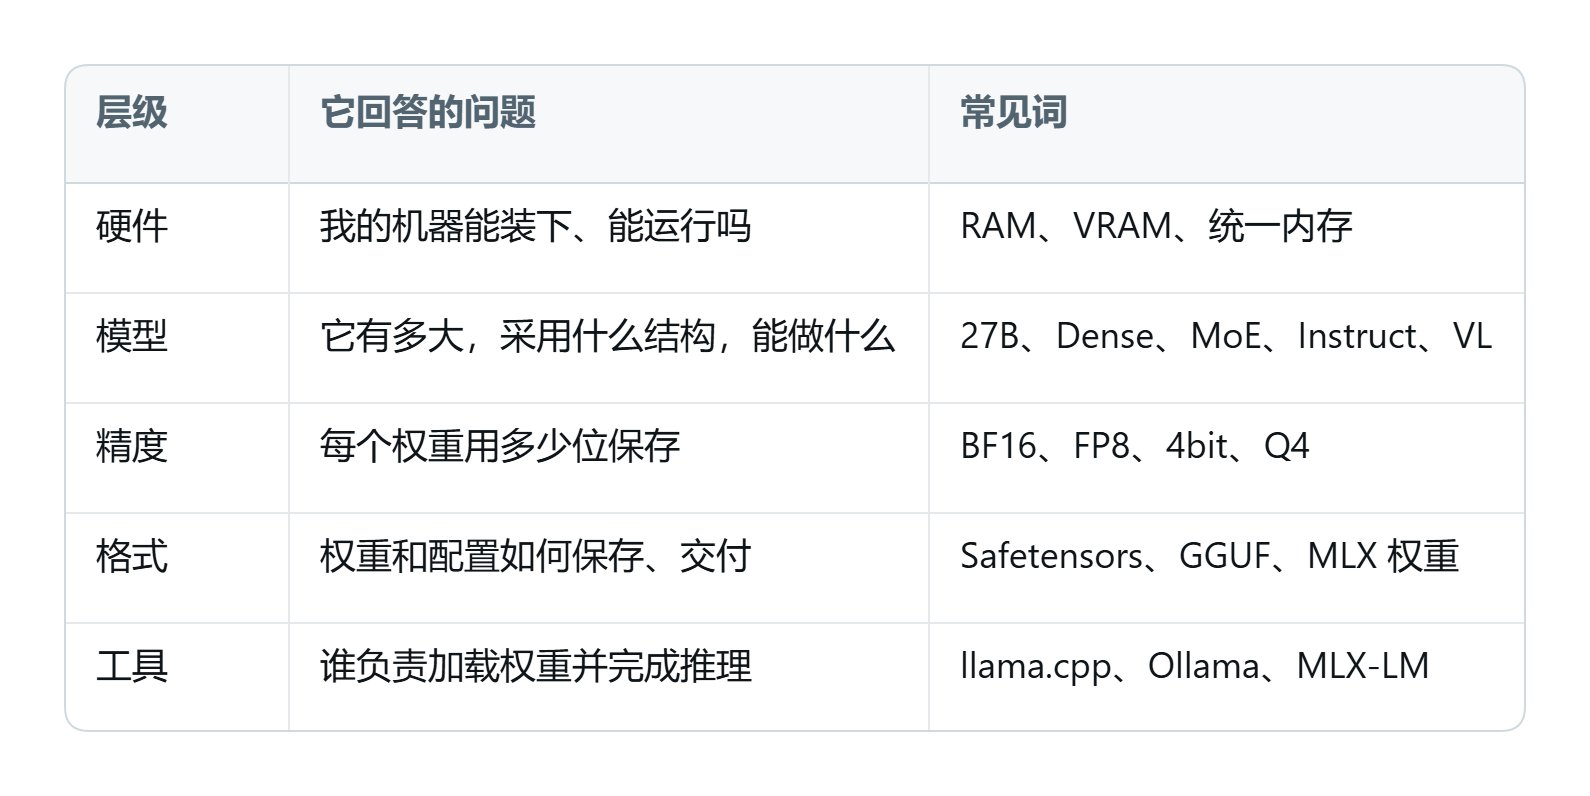 本地大模型五层运行栈图解
按层级划分后可以看到:Dense 和 MoE 属于模型架构,4bit 属于量化精度,GGUF 属于文件格式,llama.cpp 是底层推理引擎,Ollama 则是上层模型管理与服务工具。
后续遇到陌生缩写时,先确认它处于哪一层,就能避开跨层比较的误区。
02|显卡、显存、系统内存与 Mac 统一内存的区别
显卡是计算设备,例如 NVIDIA RTX 5060、5070 和 5090。显存是显卡板载的高速内存(VRAM),而 Windows 任务管理器中显示的内存则是系统内存(RAM),主要供 CPU 和常规程序调用。
- Windows + NVIDIA:RAM 和 VRAM 相互独立。模型完整装入显存时推理速度最快;显存装不下时,部分工具可将多余层留在系统内存中由 CPU 协同计算(即部分 GPU Offload 卸载),模型虽能运行,但生成速度会明显下降。
- Apple Silicon(M 系列 Mac):采用统一内存(Unified Memory) 架构,CPU 与 GPU 共享同一内存池,无需在 RAM 与 VRAM 之间复制权重。由于 macOS 系统与后台程序同样占用该内存池,48GB 统一内存的实际可用上限低于 48GB 独立显存,但仍支持 GPU 直接访问大容量权重。
硬盘空间不等于运行显存:硬盘容量只决定能否存下模型文件,不决定能否加载运行。一个 17GB 的权重文件可以存入 1TB SSD,但无法完整装进 16GB 显存。实际运行时除了静态权重,还需额外占用上下文缓存(KV Cache)、临时计算缓冲区、视觉编码器及推理框架开销。
03|参数量(27B)与实际文件大小的换算关系
模型名称中的 B 代表 billion(十亿),27B 表示模型约有 270 亿个参数。参数即模型训练得到的数值矩阵,权重文件主要存储这些数值。
权重基础大小 ≈ 参数量 × 每个参数所占位数 ÷ 8
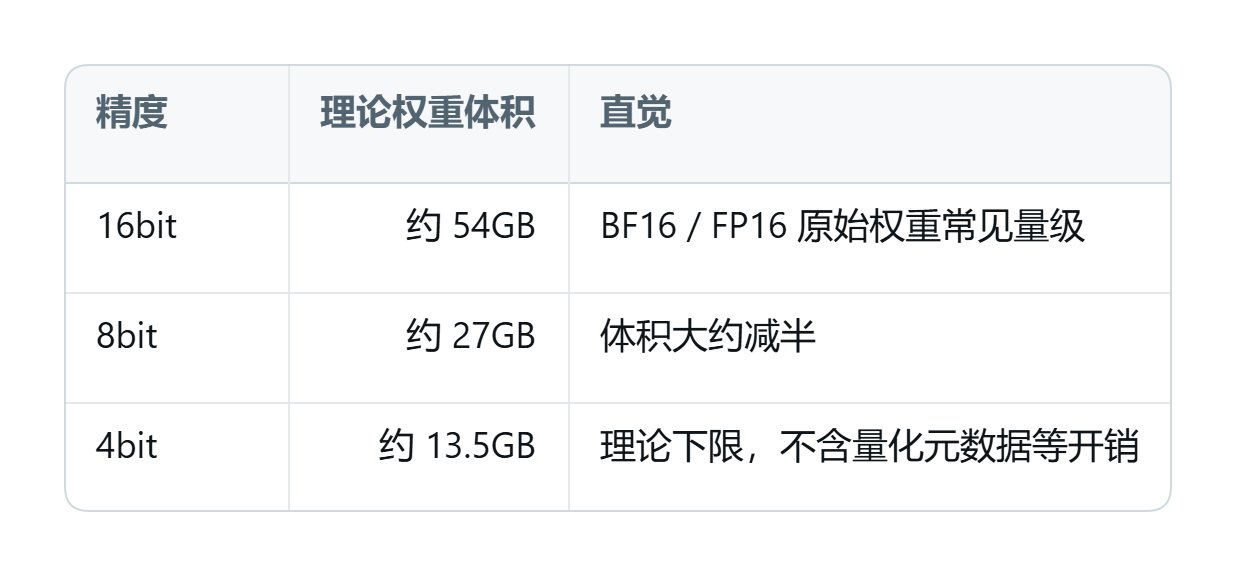 27B 参数量与精度换算
实际文件体积通常略大于理论公式值。这是因为量化文件还需保存缩放因子与分组元数据,部分敏感层也会保留更高精度;多模态模型还会额外打包视觉编码器。因此 Qwen3.8-27B 的社区 4bit 权重实际体积约为 16GB,略高于理论计算的 13.5GB。
04|Dense 与 MoE 的架构差异及显存占用
Dense 是稠密模型,每次生成 Token 时模型全部主干层都会参与计算。Qwen3.8-27B 即属于 27B 级 Dense 模型,全部参数均参与单次推理。
MoE 是 Mixture of Experts(混合专家模型),内部包含多组专家子网络,每次推理时通过路由层仅激活其中一部分专家参与计算。
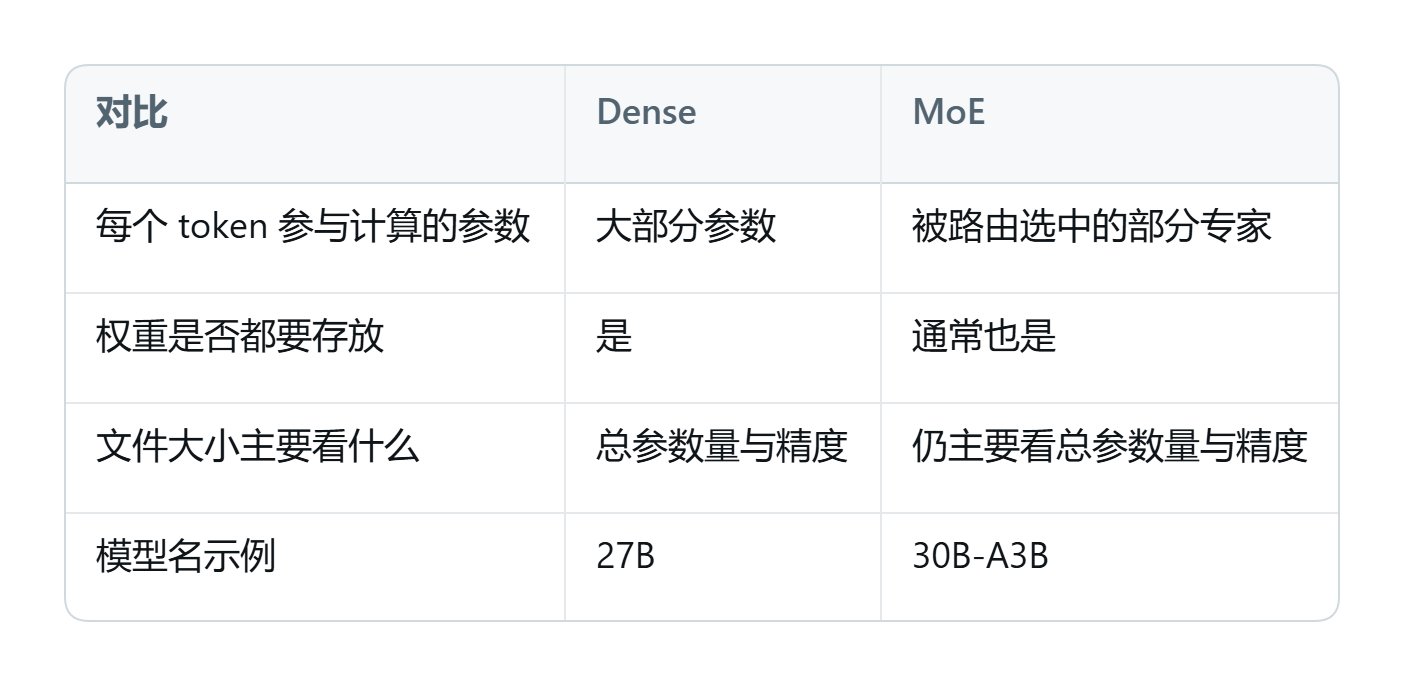 Dense vs MoE 对比
MoE 模型的显存占用常见误区:以 30B-A3B 为例,单次推理激活的计算量虽为 3B 级别,但本地运行时通常仍需将全部 30B 专家权重完整加载进内存或显存,存储与显存需求仍按 30B 规模计算。
05|Base、Instruct、Chat、Coder 与 VL 后缀选型
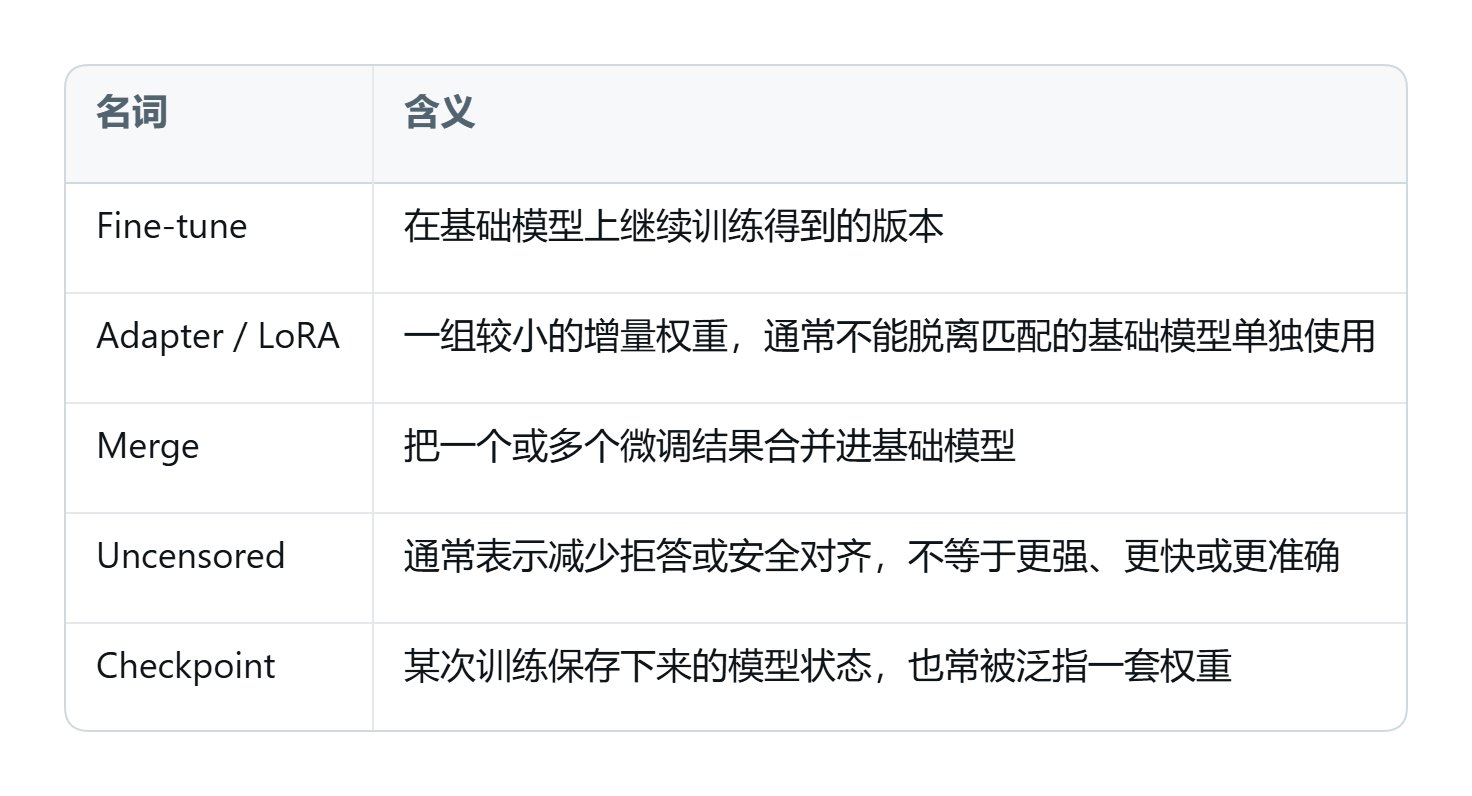 模型后缀与用途图解
Base(基座模型)
根据上文预测下文,适合算法团队继续微调训练,不适合直接用于日常对话。
Instruct / Chat(指令微调版)
经过指令遵循训练,能直接回答问题并执行系统提示词,是本地日常对话的默认选项。
Coder(代码专用版)
针对代码生成、重构与排障任务做了专项训练。
VL / VLM(多模态视觉版)
支持输入图片等视觉信息,需配合多模态推理框架运行并额外占用显存。
06 & 07|BF16、FP8、4bit 量化与 GGUF(Q4_K_M)格式说明
这些标记用于说明模型权重参数的存储精度:
- BF16 / FP16:16 位浮点数,保留原始模型精度,文件体积与显存占用最大;
- FP8:8 位浮点数,需要较新的显卡硬件与推理框架支持;
- 8bit / 6bit / 4bit:低比特量化权重。不同于无损还原的 ZIP 压缩,量化通过减少参数位数来近似原始权重,会产生一定精度损失。
GGUF 是 llama.cpp 生态采用的单文件模型格式,广泛用于 Ollama 与 LM Studio。仓库中常见的 Q4_K_M 属于 K-quant 分块量化的均衡档位,适合作为本地运行的首选起点。
08|Safetensors 权重分片与配置文件的作用
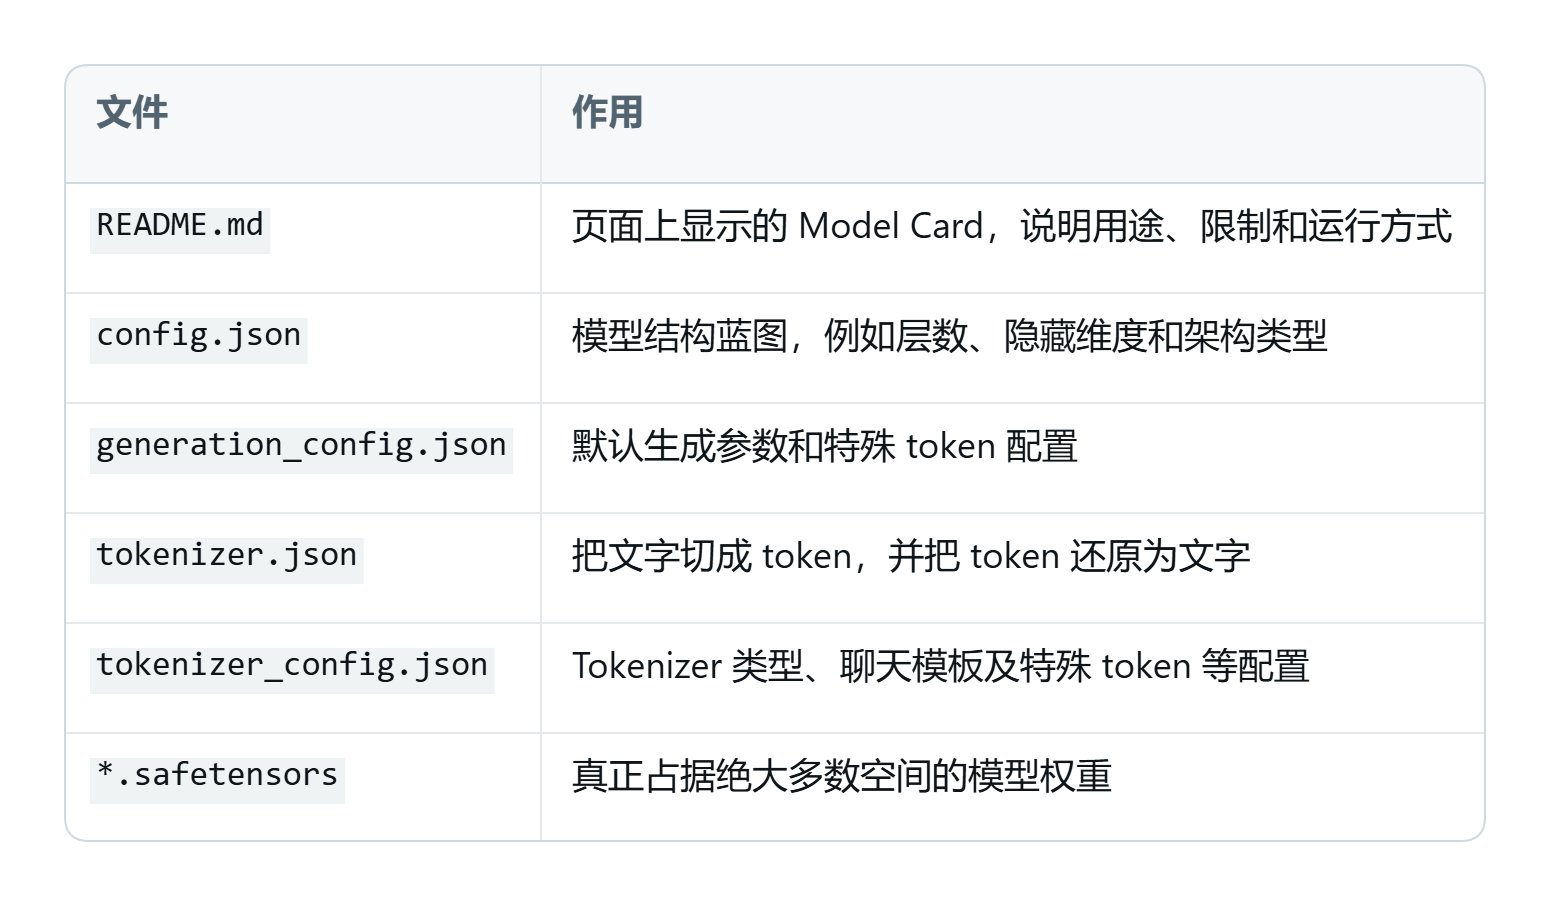 Safetensors 目录结构与配置文件
• model-00001-of-00018.safetensors:表示同一套大权重被拆分为 18 个分片文件,必须下载全部分片才能拼接加载,不能只挑其中一个下载。
• tokenizer.json / tokenizer_config.json:分词器配置文件,负责将文本切分并映射为 Token ID。
• config.json / generation_config.json:定义模型层数、注意力头数与结束符(EOS)。若聊天模板(Chat Template)匹配错误,模型容易出现答非所问或无法正常停止输出。
09|Hugging Face 模型主页的核查顺序
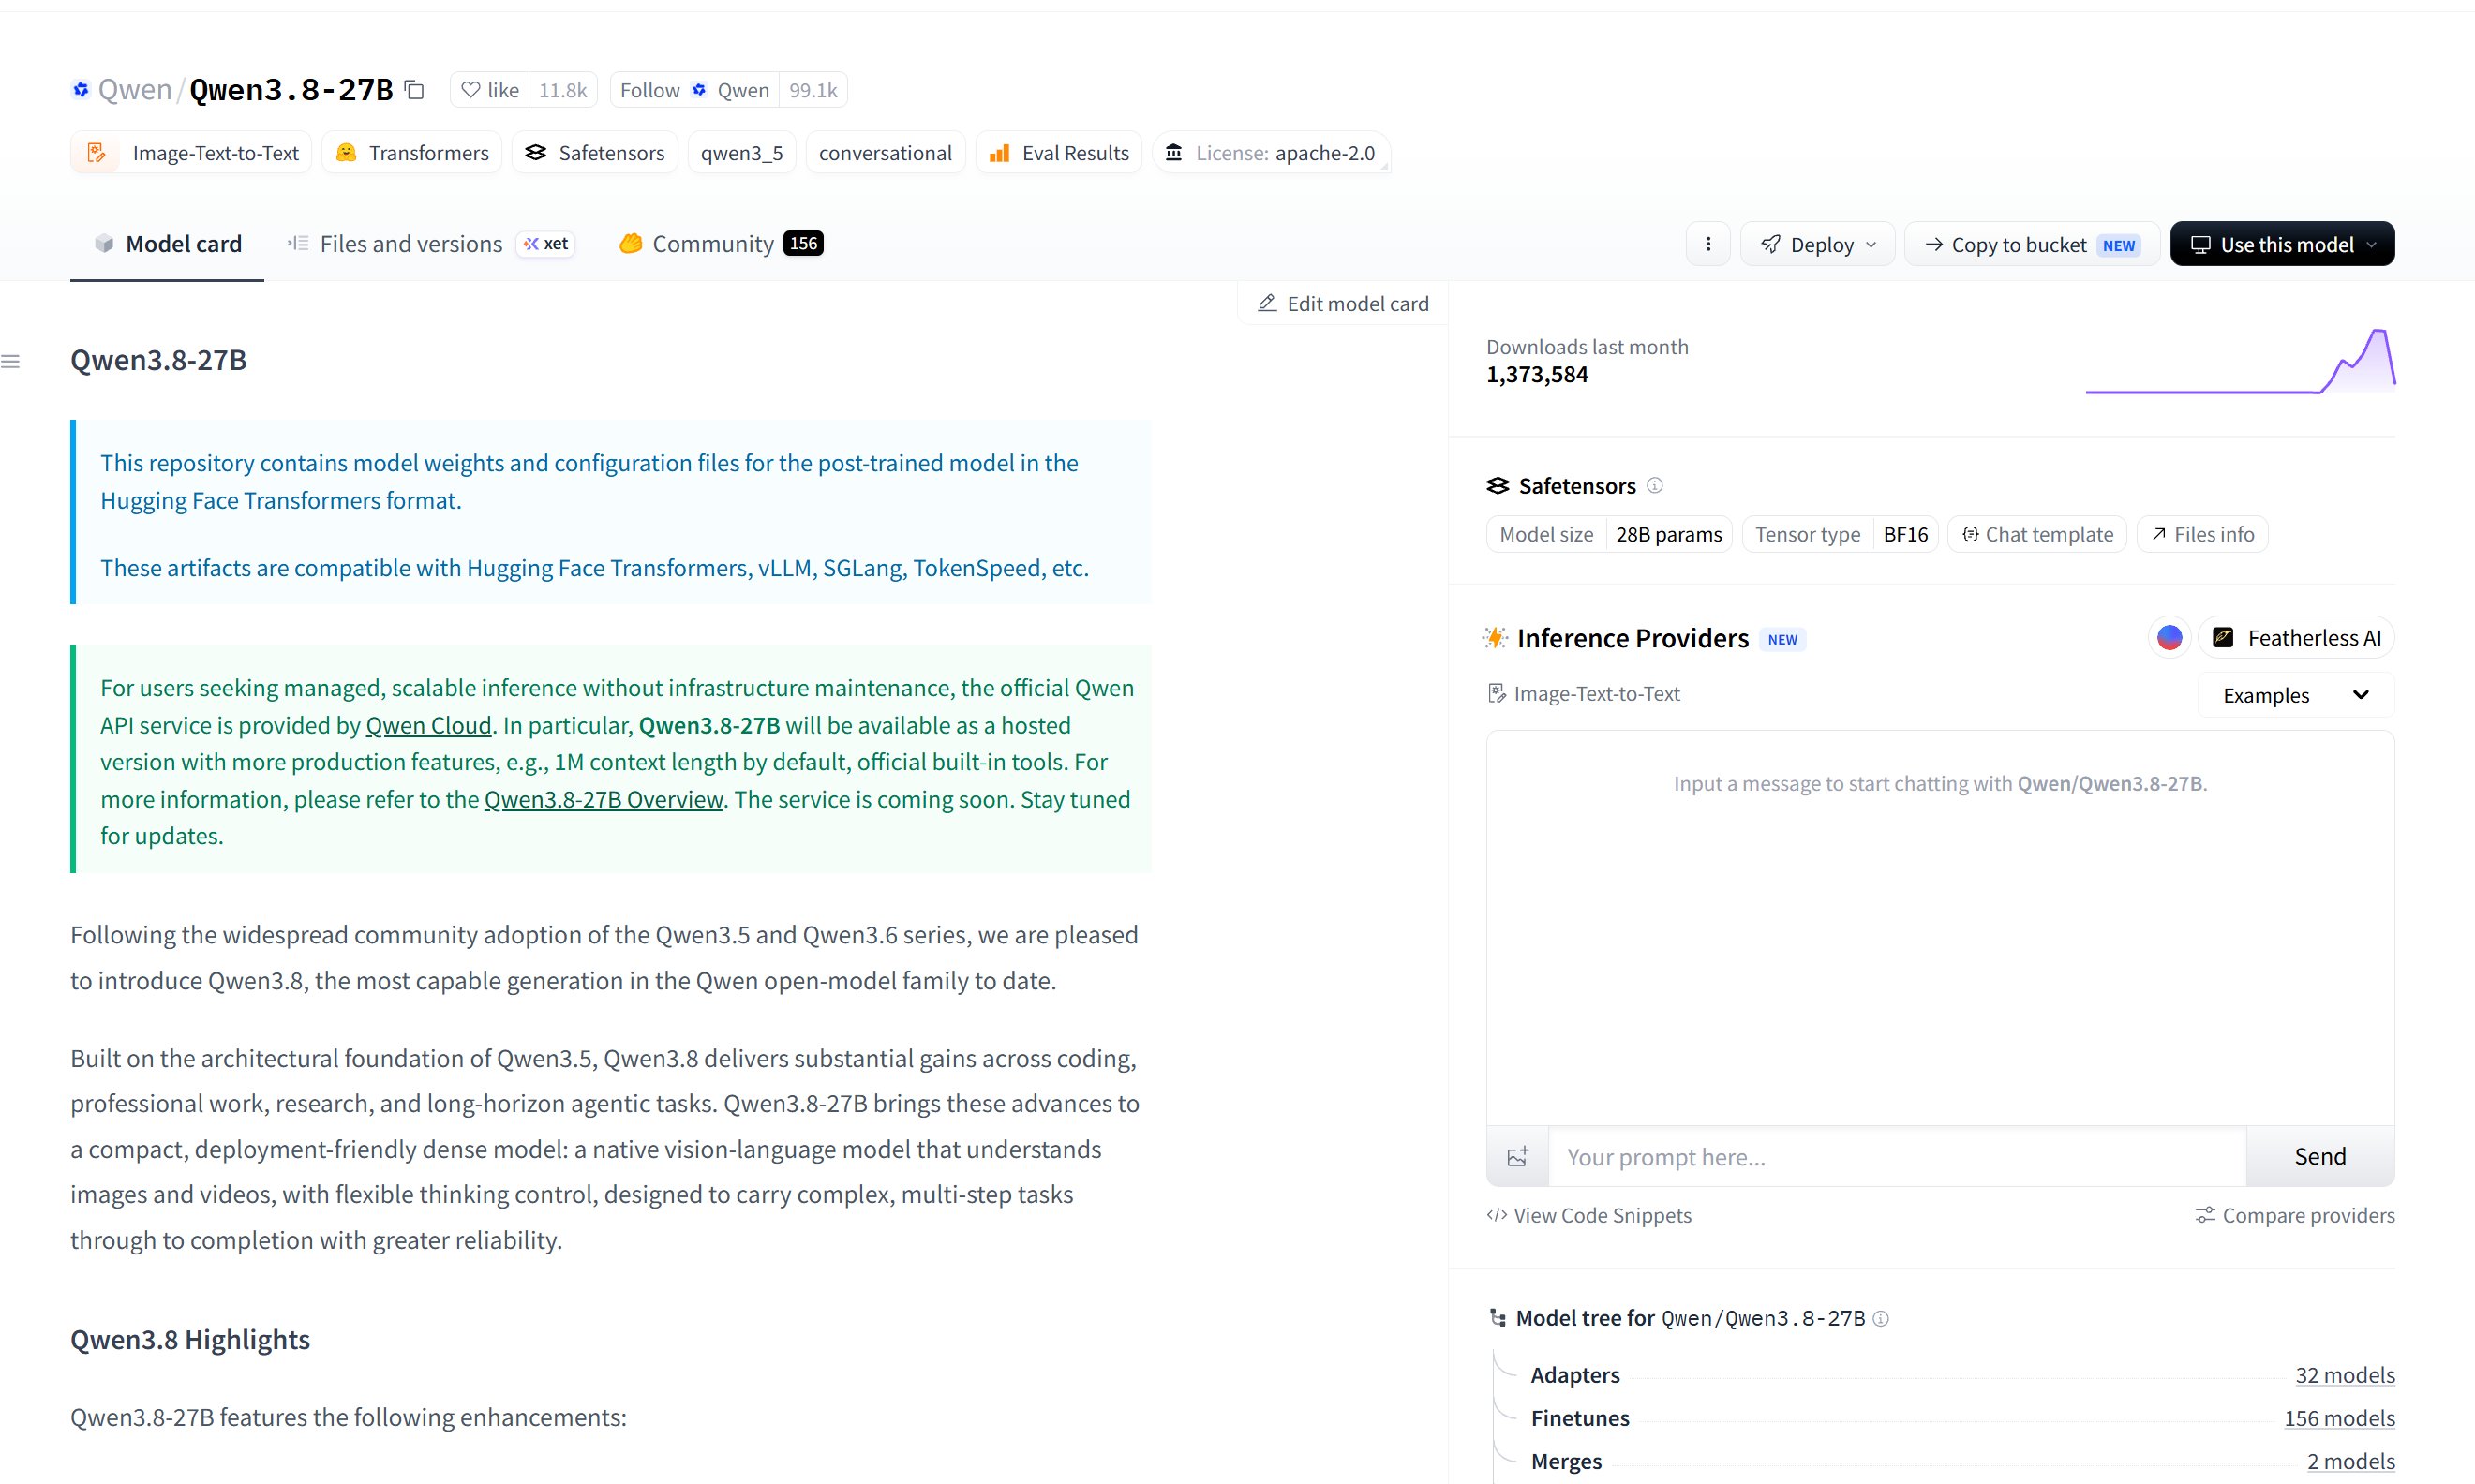 Hugging Face 页面阅读指南
- 发布者:确认是官方团队(如 Qwen)还是常用社区转换维护者(如 mlx-community、bartowski);
- 模型名称:核对参数规模、Base / Instruct 类型、是否含 VL 视觉后缀及量化标记;
- Model Card:查看适用场景、开源协议、上下文长度上限与官方推荐的推理工具;
- 标签与元数据:区分纯文本生成(text-generation)与图文输入(image-text-to-text);
- Files and versions:查看文件总大小、分片数量与可选量化档位列表;
- 更新时间与 Community 讨论区:排查近期版本是否存在分词器或聊天模板兼容性问题。
10 & 11|工具分工:MLX、llama.cpp、Ollama 与 LM Studio
本地推理工具类比对照:
GGUF 相当于媒体文件(承载量化后的权重数据)
llama.cpp 相当于底层解码引擎(负责张量计算与硬件加速)
Ollama 相当于模型管理器 + 本地后台 API 服务 + 命令行工具
LM Studio 相当于带图形界面与模型下载器的桌面客户端
在 Apple Silicon(Mac)平台上,MLX 是苹果原生的底层数组计算框架,其中 MLX-LM 用于运行纯文本大模型,MLX-VLM 用于运行视觉多模态模型。Windows 与 Linux 设备无法运行 MLX 专用权重。
12|选型示例:按四步法筛选 Qwen3.8-27B 权重
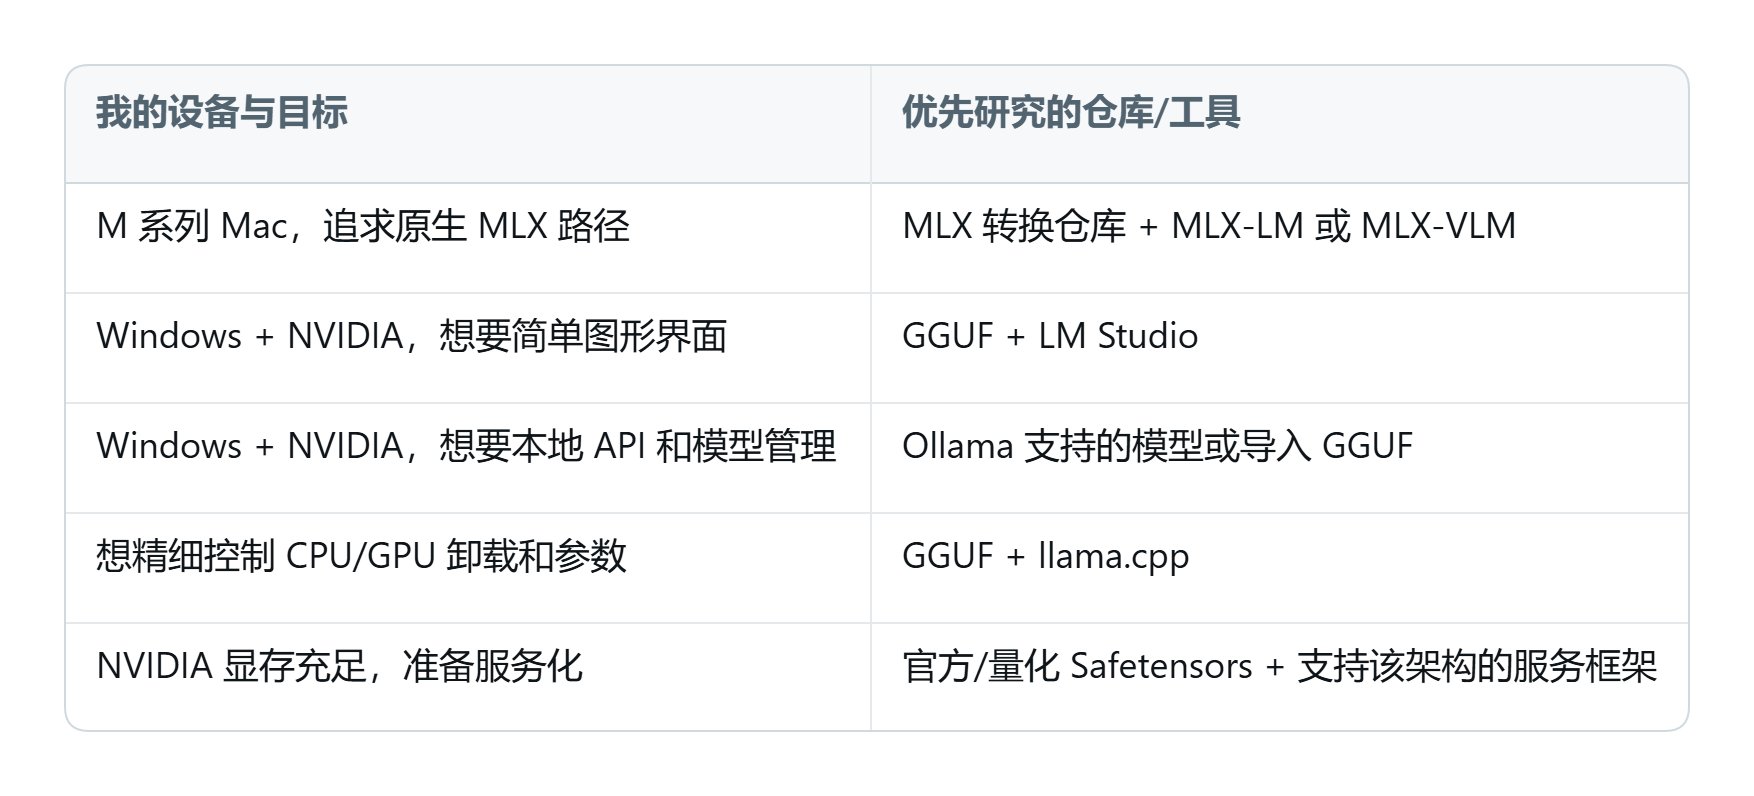 Qwen3.8-27B 选择决策流
1确认模型规格:27B 稠密架构,若需图像理解则确认推理工具支持 VL 多模态。
2测算显存需求:4bit 静态权重约占 16GB,加上 KV Cache 建议准备 20GB 以上显存或统一内存。
3匹配运行生态:Windows 或 Linux 选 GGUF(配合 llama.cpp、Ollama 或 LM Studio),Apple Silicon Mac 选 MLX 或 GGUF。
4确定量化档位:GGUF 默认选 Q4_K_M,显存偏紧改选 Q3_K_M,显存充裕可升至 Q5_K_M 或 Q8_0。
官方参考来源与技术文档
- Qwen3.8-27B 官方模型仓库
- Hugging Face Model Cards 规范文档
- Transformers 仓库文件结构说明
- Hugging Face MLX 官方文档
- MLX Community 社区模型库
- Qwen llama.cpp 量化官方指南
- llama.cpp 官方开源项目
- Ollama 官方模型导入文档
原文作者:雪瑜(@xueyu1125),本文梳理了 Hugging Face 参数体系、显存估算与量化格式选型规则。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。