
深度实测 GPT-6.2 Astra 与 Sol:OpenAI 在“偏科战神”的道路上越走越远了
数字生命卡兹克 (@Khazix0918) 一手深度实测 · 19 图 + 6 视频全量收录
从 11 月 1 日灰测拖延近 20 天后,OpenAI 终于在 ChatGPT、Codex 与 API 同步上线了双子星模型:前沿旗舰 GPT-6.2 Astra(gpt-6.2-astra) 与日常高效主力 GPT-6.2 Sol(gpt-6.2-sol)。一句话定性:OpenAI 在“偏科战神”与“To 精英工业重器”的道路上越走越远了——它在非科研方案沟通与 2D 动效审美上几乎被 Claude Fable 5.2 与 Gemini 4 Carbon 吊打,但在 极低单任务 Token 成本(Agents' Last Exam 单题 $3 vs Claude $60)、自动化代码找 Bug(84% / 96% 检出率)、终端科研(Vals 科学指数第 1) 以及 Three.js 3D 空间世界构建上展现出了恐怖的统治力。
API 定价 & 缓存大降
$8 / $40 · 缓存 $0.40
Astra 降 20%,缓存直降 60%
Agents' Last Exam
~78% · 仅 $3 / 题
高出 Fable 5.2 5.5分,成本仅 5%
AA 智能指数排名
62 分(全球第 2)
Astra 暴涨 +6 分,Sol 达 57 分
xhigh 代码审查检出率
Sol 84% · Astra 96%
6.2 Sol xhigh 成性价比第 1
 图 01:等了近 20 天,OpenAI 正式同步发布前沿旗舰 GPT-6.2 Astra 与日常主力 GPT-6.2 Sol(ChatGPT、Codex 与 API 同步上线)
点击放大原图
图 01:等了近 20 天,OpenAI 正式同步发布前沿旗舰 GPT-6.2 Astra 与日常主力 GPT-6.2 Sol(ChatGPT、Codex 与 API 同步上线)
一、GPT-6.2 双模型基本信息:知识截止日期、灰测暗号与缓存读取降价 60%
这次 OpenAI 一次性端出了两款定位清晰但性格一致的模型,已在 ChatGPT、Codex 及官方 API 全量铺开:
- GPT-6.2 Astra(API 编号:
gpt-6.2-astra):官方定位是“给你最难的项目用的前沿模型”,知识库截止日期更新至 2026 年 5 月 18 日(前代 GPT-6 Astra 为 4 月 30 日)。 - GPT-6.2 Sol(API 编号:
gpt-6.2-sol):官方定位是“日常工作用的高效模型”,知识库截止日期更新至 2026 年 6 月 1 日(叠加后训练 Post-training,实际感知知识时间会再往后延一些)。
一个极客圈小彩蛋:11 月初大家在测试账号是否被灰度到 GPT-6.2 时,用的正是知识库截止日期盲测法——直接问一句「禁止联网,你知道 Fable5 吗」。因为旧版 GPT-6 Astra 与 GPT-6.1 Sol 根本不知道 Fable 5 这个模型,只要不联网能答出来,就说明命中新模型灰度了:
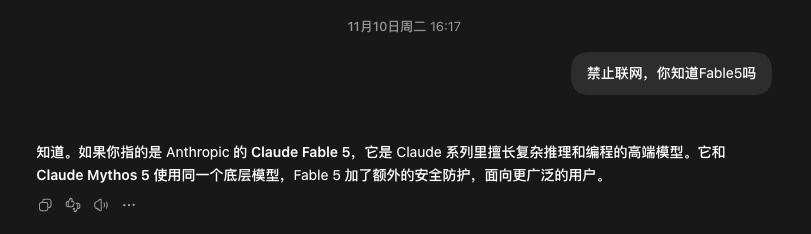 图 02:灰测鉴别实录——通过询问「禁止联网,你知道 Fable5 吗」验证知识库截止日期是否已推进至 2026 年 5–6 月
点击放大原图
图 02:灰测鉴别实录——通过询问「禁止联网,你知道 Fable5 吗」验证知识库截止日期是否已推进至 2026 年 5–6 月
1.1 定价全面对齐 Claude Fable 5.2,缓存读取从 $1.00 暴降至 $0.40
在 API 定价策略上,OpenAI 再次上演贴身对齐:继上周 Claude Fable 5.2 降价至 $8 / 1M 输入、$40 / 1M 输出 后,本次 GPT-6.2 Astra 也整体降价 20% 至 $8 / $40;更关键的是此前贵到离谱的缓存读取(Cached Input)从 $1.00 直接砍到 $0.40(降幅高达 60%)!而 GPT-6.2 Sol 维持 $2 / $10 / 缓存 $0.10 不变。
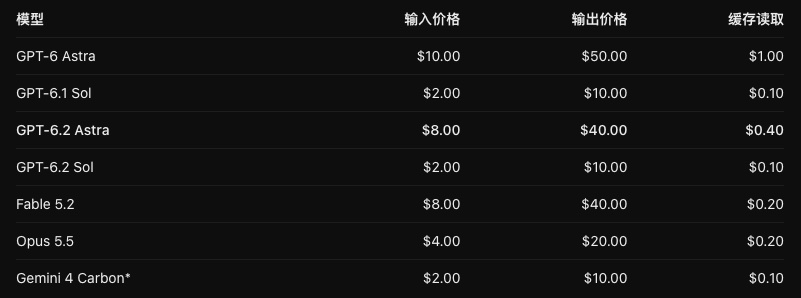 图 03:主流旗舰模型 API 价格横评表(单位:美元 / 百万 Token)——注意缓存读取价格与实际单任务 Token 消耗才是决定账单的胜负手
点击放大原图
图 03:主流旗舰模型 API 价格横评表(单位:美元 / 百万 Token)——注意缓存读取价格与实际单任务 Token 消耗才是决定账单的胜负手
虽然单看缓存读取单价,GPT-6.2 Astra($0.40)仍高于 Claude Fable 5.2($0.20)以及目前限时半价的 Gemini 4 Carbon($0.10),但相比刚发布时“一天就能烧穿一个 $200 Pro 账号额度”的 GPT-6 Astra($1.00 缓存读取)已经温和了太多。更重要的是——评估 Agent 成本绝对不能只看每百万 Token 单价,还必须乘以“完成单个任务实际吐出的 Token 总量”!
二、核心护城河:「每个任务花多少钱」与近 7 倍的推理 Token 效率差
因为纯粹拼极限综合智力与灵性确实很难正面压制 Claude,OpenAI 这次几乎所有官方评测图表的横轴都死死钉在同一个维度上:Cost per task(完成每个任务花多少钱)。
2.1 Agents' Last Exam(Agent 期末大考):高出 5.5 分,成本却只有 Claude 的 5%
在考察多步骤专业工作闭环的 Agents' Last Exam v1.1 评测中,出现了极具冲击力的一幕:
- GPT-6.2 Astra:得分约 78%,平均每个任务成本仅约 $3(相比自家上一代 GPT-6 Astra 分数高出 5.2 分,成本不到三分之一);
- Claude Fable 5.2:得分约 73%,平均每个任务成本高达约 $60——GPT-6.2 Astra 分数反超 5.5 分,成本却只有对方的 5%!
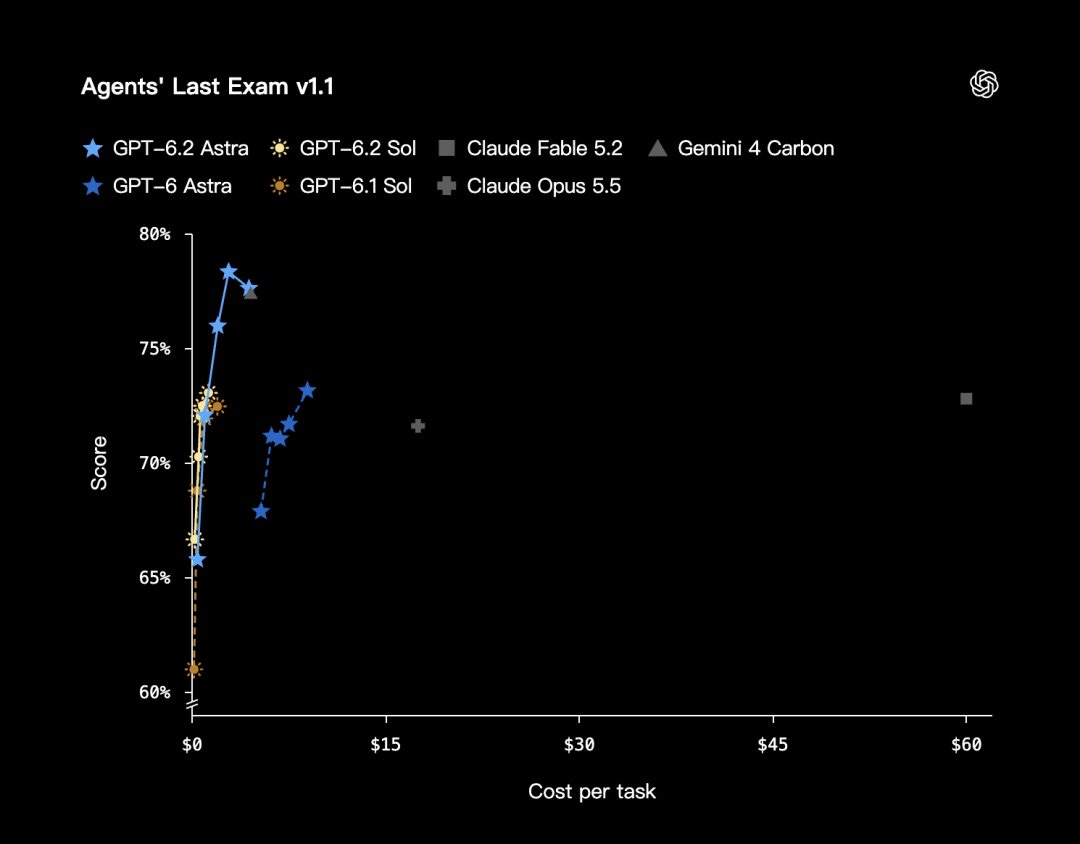 图 04:OpenAI 官方 Agents' Last Exam v1.1 得分与单任务成本(Cost per task)散点曲线——GPT-6.2 Astra 贴着最左侧低成本轴冲上 ~78%,而 Claude Fable 5.2 落在最右侧 $60 处
点击放大原图
图 04:OpenAI 官方 Agents' Last Exam v1.1 得分与单任务成本(Cost per task)散点曲线——GPT-6.2 Astra 贴着最左侧低成本轴冲上 ~78%,而 Claude Fable 5.2 落在最右侧 $60 处
为什么纸面单价一样(甚至缓存单价 Claude 更便宜),最终单题账单能差出 20 倍?Artificial Analysis 统计的单项任务输出 Token 加权平均值揭开了真相:GPT-6.2 Sol 仅 40k、GPT-6.2 Astra 仅 41k,而 Claude Fable 5.2 为了暴力堆高能力上限,单题平均狂飙到 274k 输出 Token(相差近 7 倍)!
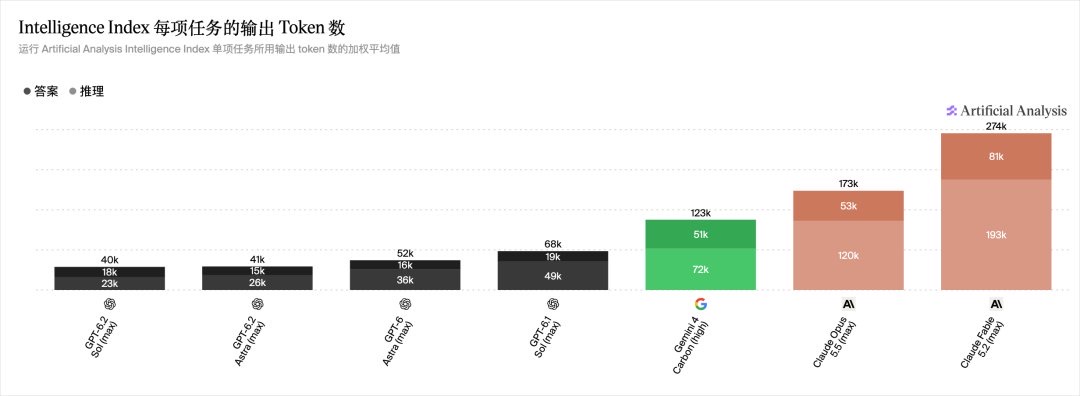 图 05:Artificial Analysis Intelligence Index 每项任务输出 Token 数对比(答案 + 推理)——GPT-6.2 Sol/Astra 仅 40k/41k,Claude Fable 5.2 高达 274k
点击放大原图
图 05:Artificial Analysis Intelligence Index 每项任务输出 Token 数对比(答案 + 推理)——GPT-6.2 Sol/Astra 仅 40k/41k,Claude Fable 5.2 高达 274k
卡兹克用自己的 $200 ChatGPT Pro 会员周额度 验证了这一体感差异:本轮实测跑完 4 个视频与 3D 大 Case + 2 个大型方案规划 + 近 100 次代码审查,周额度从剩余 12% 降到 6%,全程仅消耗 6% 周额度;而上周测 Claude Fable 5.2 时,仅跑 10 个 Case 就直接烧掉了近 30% 的周额度。
2.2 终端科研榜首(Vals 科学指数第 1)、GDPval v2 与 AA 智能指数重回全球第 2
在科研人员最看重的终端实验基准 Terminal-Bench-Science 0.1 中,GPT-6.2 Astra 取得约 77% 得分且单任务仅约 $7(前代 GPT-6 Astra 为 68% / 约 $24),并在第三方 Vals Science Index v1(科学指数) 中夺得全球第一,OpenAI 也底气十足地将其称为“世界上最适合科学家的模型”。在考察咨询、金融、设计长程知识工作的内部基准 GDPval v2 上同样延续了高分省钱曲线:
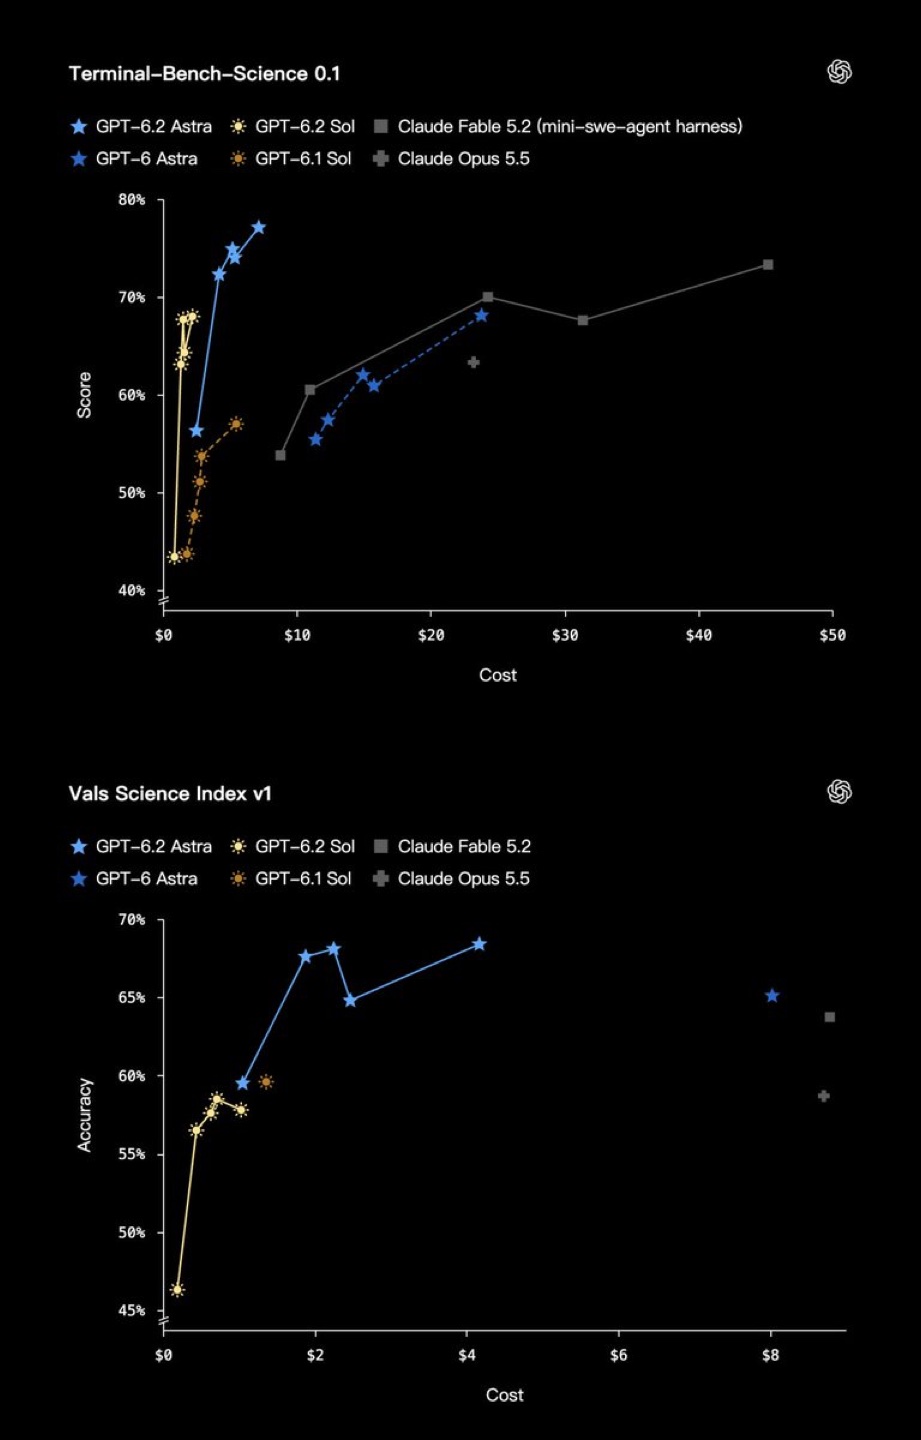 图 06:Terminal-Bench-Science 0.1(~77% / ~$7)与第三方 Vals Science Index v1 双双登顶——科研圈公认的主力实验模型
点击放大原图
图 06:Terminal-Bench-Science 0.1(~77% / ~$7)与第三方 Vals Science Index v1 双双登顶——科研圈公认的主力实验模型
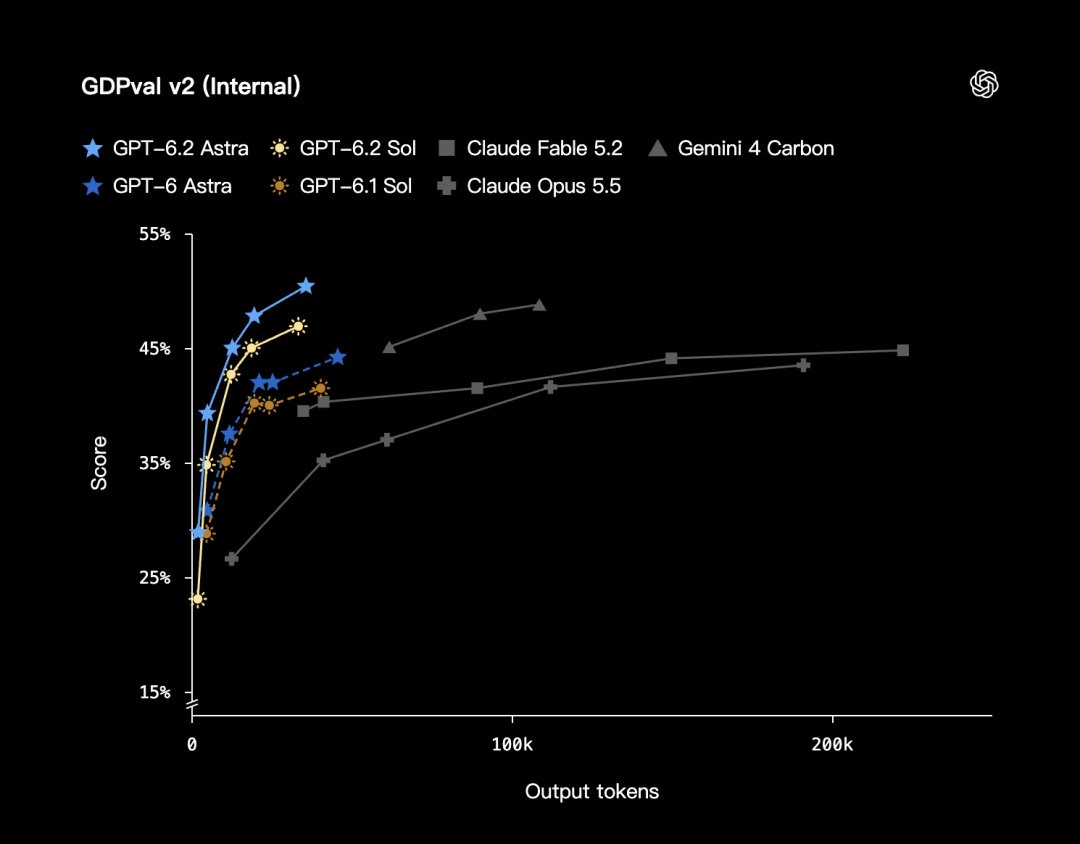 图 07:OpenAI 内部 GDPval v2(咨询、金融、设计等真实行业长程知识工作)输出 Token 效率曲线
点击放大原图
图 07:OpenAI 内部 GDPval v2(咨询、金融、设计等真实行业长程知识工作)输出 Token 效率曲线
而在第三方权威榜单 Artificial Analysis Intelligence Index v5.0.1 上,GPT-6.2 Astra 暴涨 6 分拿到 62 分,重回全球第 2(仅次于 Claude Fable 5.2 的 65 分,领先 Gemini 4 Carbon 的 60 分与 Claude Opus 5.5 的 59 分);GPT-6.2 Sol 小涨 2 分达到 57 分(追平前代旗舰 GPT-6 Astra)。注:由于 AIHOT 模型榜采用 ELO 机制,需等待过半数评测机构开分后(约发布后 1 天)才会正式计入总榜排名,以免早期稀疏样本造成剧烈波动。
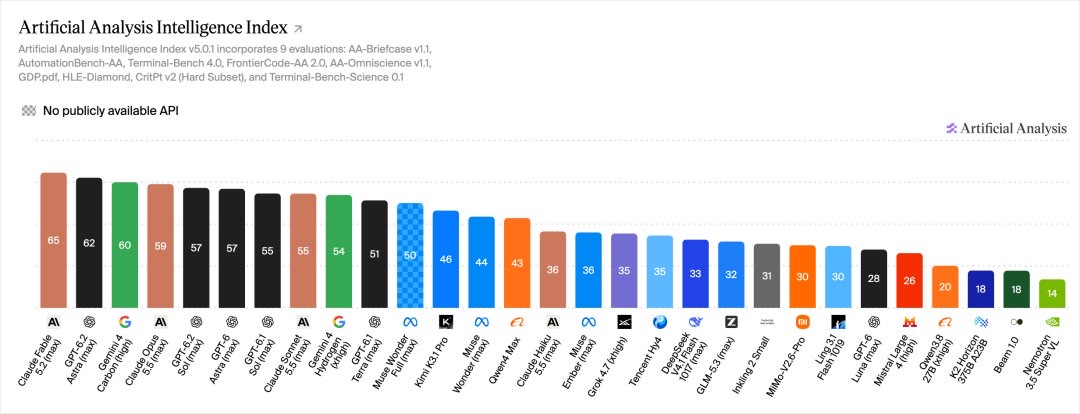 图 08:Artificial Analysis Intelligence Index v5.0.1 最新全球排名——Claude Fable 5.2 (65) 第 1,GPT-6.2 Astra (62) 第 2,Gemini 4 Carbon (60) 第 3,GPT-6.2 Sol (57) 第 5
点击放大原图
图 08:Artificial Analysis Intelligence Index v5.0.1 最新全球排名——Claude Fable 5.2 (65) 第 1,GPT-6.2 Astra (62) 第 2,Gemini 4 Carbon (60) 第 3,GPT-6.2 Sol (57) 第 5
三、四大维度真刀真枪实测:极致的短板与极致的统治力
3.1 沟通与产品方案规划(惨败短板):AIHOT 合规留言区实测,24 分钟跑出“人工审评论”
过去两个月,不少读者希望在卡兹克业余独立维护的资讯项目 AIHOT 每条新闻下方加一个留言交流区:
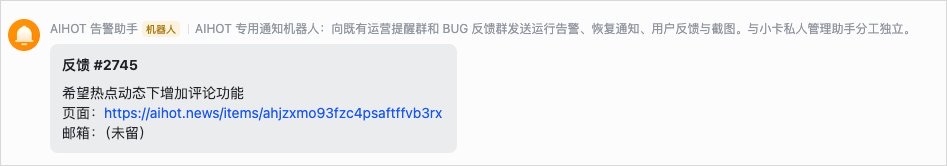 图 09:读者真实需求反馈(一)——希望在 AIHOT 每条新闻下方增加评论交流区
点击放大原图
图 09:读者真实需求反馈(一)——希望在 AIHOT 每条新闻下方增加评论交流区
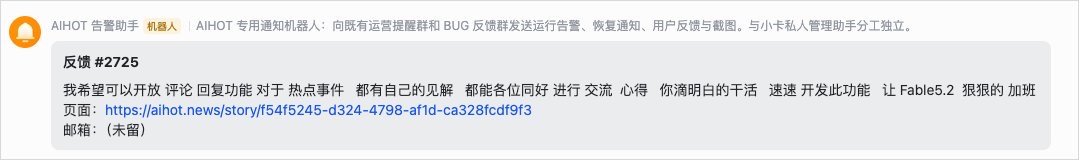 图 10:读者真实需求反馈(二)——功能开发只需几分钟,真正的门槛在于国内实名制短信成本与“先审后发”合规风控
点击放大原图
图 10:读者真实需求反馈(二)——功能开发只需几分钟,真正的门槛在于国内实名制短信成本与“先审后发”合规风控
对个人维护的非商业项目来说,写个评论框毫无技术难度,真正的死穴在于国内合规与成本:既要强制手机号实名认证(短信验证码很贵),又必须严格落实“先审后发”内容审查。用同一段极简大白话需求分别测试 Gemini 4 Carbon 与 GPT-6.2 Astra,高下立判:
实测题 1:AIHOT 最小成本合规留言区架构评估产品规划 & 可读性
| 1 | 最近已经收到很多用户的反馈,希望我们能在AIHOT中间加一个简单的留言区,方便大家来简单的交流。那基于这个背景,你可以帮我评估一下,如何在保证合规且安全的情况下,来以最小的成本去设计整个的留言与交流功能。 |
先看 Gemini 4 Carbon(耗时约 5 分钟):第一句话就精准抓住了个人维护项目的痛点,清晰列出全部必守合规红线,随后给出极具实操启发性的“最小成本方案”——不开放自定义昵称、不做多层盖楼、不开全量只开精选留言,并在“先审后发”环节直接复用 AIHOT 现成的 Agent 全自动新闻审查管线,最后附上清晰的方案对比表请用户拍板(配合 Claude 再交叉审一道幻觉即可直接落地):
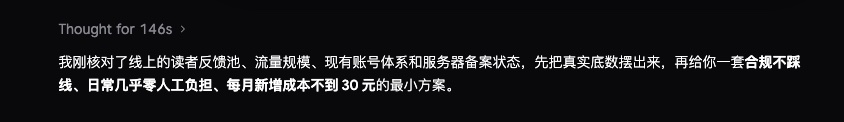 图 11:Gemini 4 Carbon 方案开篇(耗时 5 分钟)——第一句话即精准共情“个人维护项目的合规风险与短信/审核成本”
点击放大原图
图 11:Gemini 4 Carbon 方案开篇(耗时 5 分钟)——第一句话即精准共情“个人维护项目的合规风险与短信/审核成本”
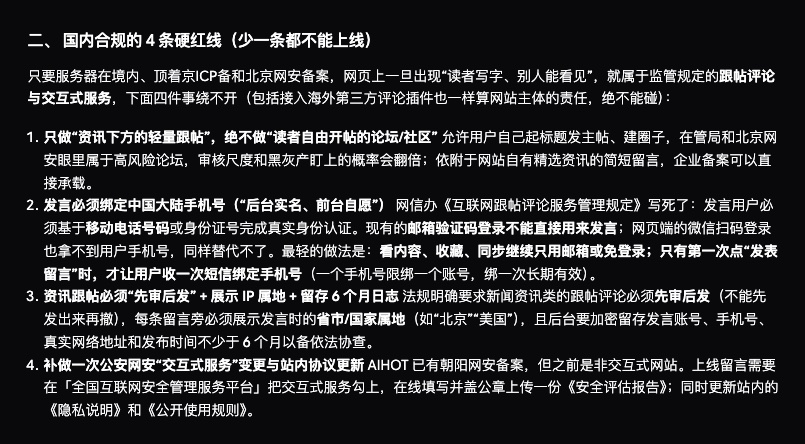 图 12:Gemini 4 Carbon 拆解的国内社区留言必守合规红线清单(实名认证、先审后发、日志留存)
点击放大原图
图 12:Gemini 4 Carbon 拆解的国内社区留言必守合规红线清单(实名认证、先审后发、日志留存)
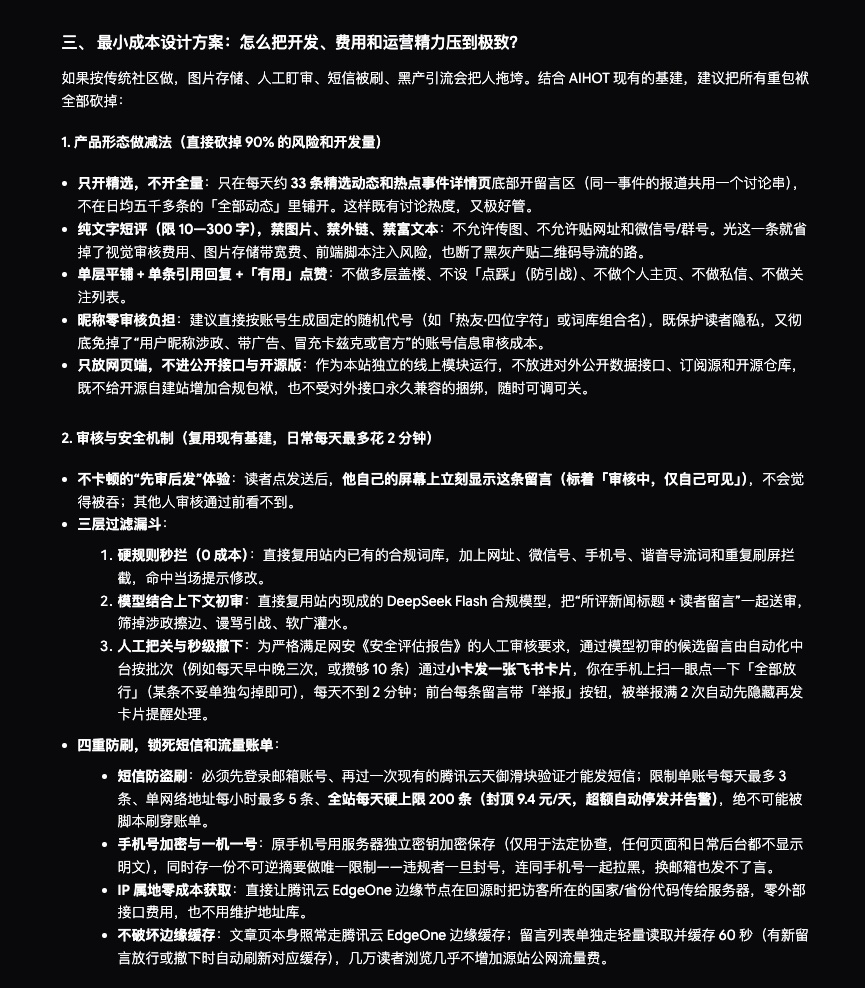 图 13:Gemini 4 Carbon 给出的极简低成本设计——禁自定义昵称、不盖楼、只做精选,直接复用现有 Agent 自动审核机制
点击放大原图
图 13:Gemini 4 Carbon 给出的极简低成本设计——禁自定义昵称、不盖楼、只做精选,直接复用现有 Agent 自动审核机制
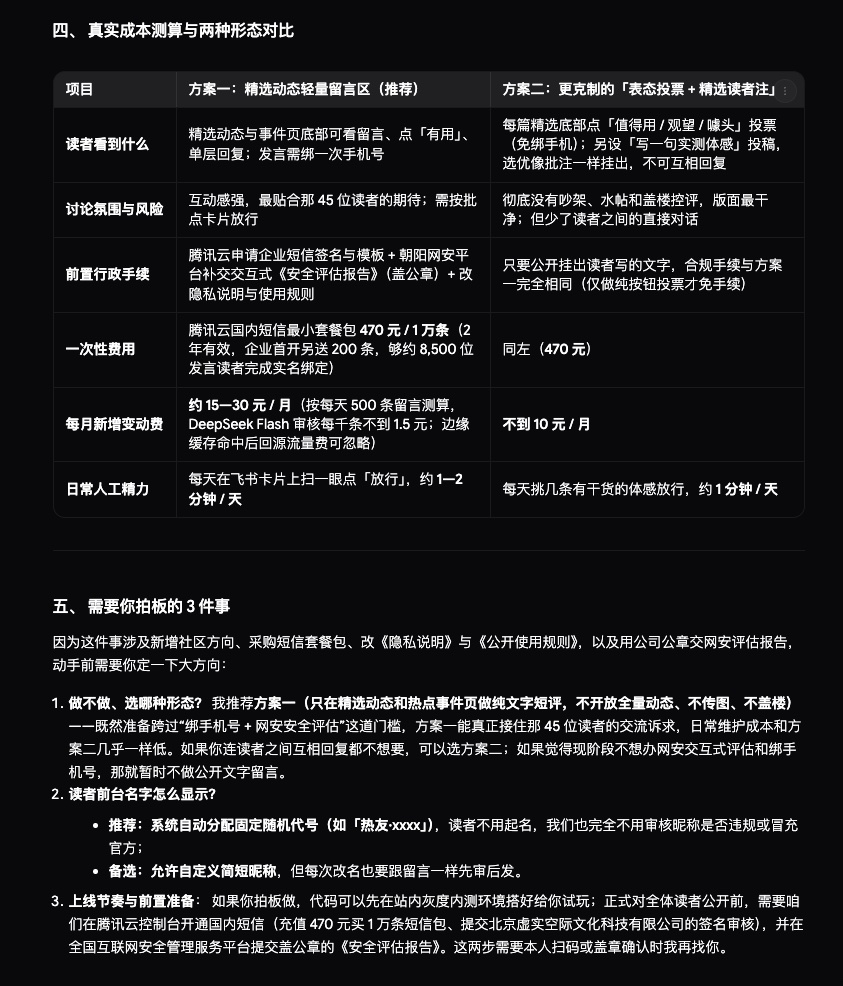 图 14:Gemini 4 Carbon 结尾提供结构化方案对比与决策引导,排版清爽、可读性极强
点击放大原图
图 14:Gemini 4 Carbon 结尾提供结构化方案对比与决策引导,排版清爽、可读性极强
再看 GPT-6.2 Astra(足足跑了 24 分钟,慢了近 5 倍!):篇幅明明很短,读起来却云里雾里、信息组织生硬累人,甚至荒唐地建议个人业余项目“前期采用人工审核”(难道让开发者 24 小时蹲在屏幕前手动审评论?);另一份排行榜方案规划同样可读性极差:
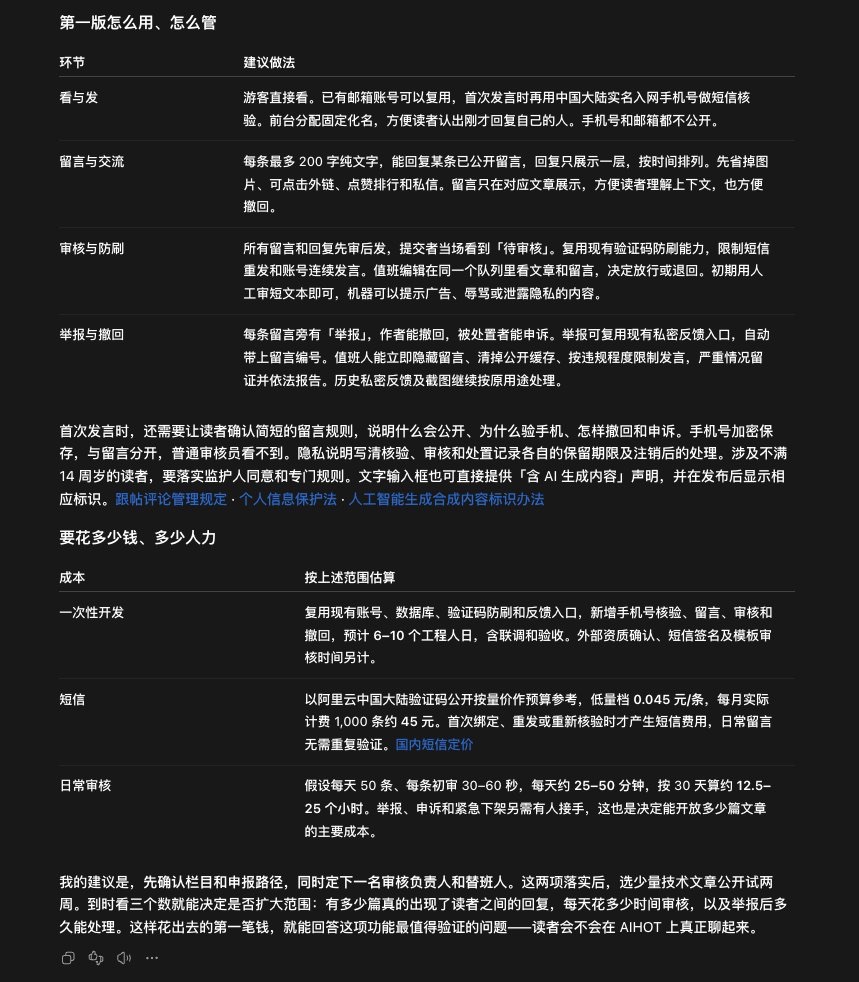 图 15:GPT-6.2 Astra 苦跑 24 分钟给出的留言区方案——行文晦涩如天书,甚至给出“前期人工审核”的脱离实际建议
点击放大原图
图 15:GPT-6.2 Astra 苦跑 24 分钟给出的留言区方案——行文晦涩如天书,甚至给出“前期人工审核”的脱离实际建议
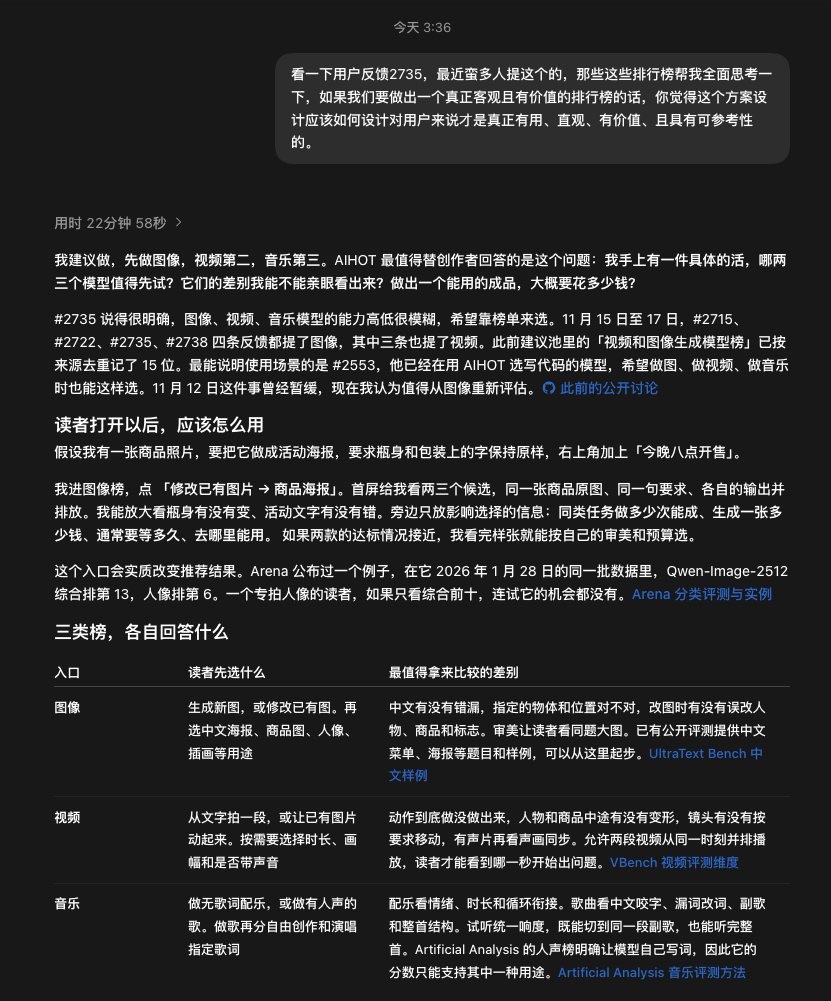 图 16:GPT-6.2 Astra 在排行榜方案规划任务中同样暴露出主动性弱、人类阅读体验极差的顽疾
点击放大原图
图 16:GPT-6.2 Astra 在排行榜方案规划任务中同样暴露出主动性弱、人类阅读体验极差的顽疾
3.2 自动化代码审查(王牌杀手锏):GPT-6.2 Sol xhigh 跃升至 84%,Astra 狂飙至 96%!
在工程流水线中,卡兹克目前最高频调用 GPT 的核心场景正是 Automated Code Review(自动化代码审查):每当 Claude 写完业务代码后,自动化脚本会驱动 GPT 在 xhigh 推理强度下最多审查 3 轮,把隐藏 Bug 扼杀在上线前。
在基于真实项目构建的内部评测集(共 102 个真缺陷样本)上,三代模型同开 xhigh 的硬核成绩单如下:
- GPT-6.1 Sol (xhigh):仅检出 65%(命中 61、部分命中 3、漏掉 38),中位耗时 5.7 分钟,单次 $0.31;
- GPT-6.2 Sol (xhigh):检出率大幅跃升至 84%(命中 80、部分命中 7、仅漏 15),中位耗时反而缩短至 3.9 分钟,单次仅 $0.43;
- GPT-6.2 Astra (xhigh):史无前例干到近乎满分的 96%(命中 91、部分命中 1、仅漏 10),中位耗时 8.1 分钟(慢约 1 倍),单次 $1.60(贵约 4 倍,换来多抓十几个深水 Bug)。
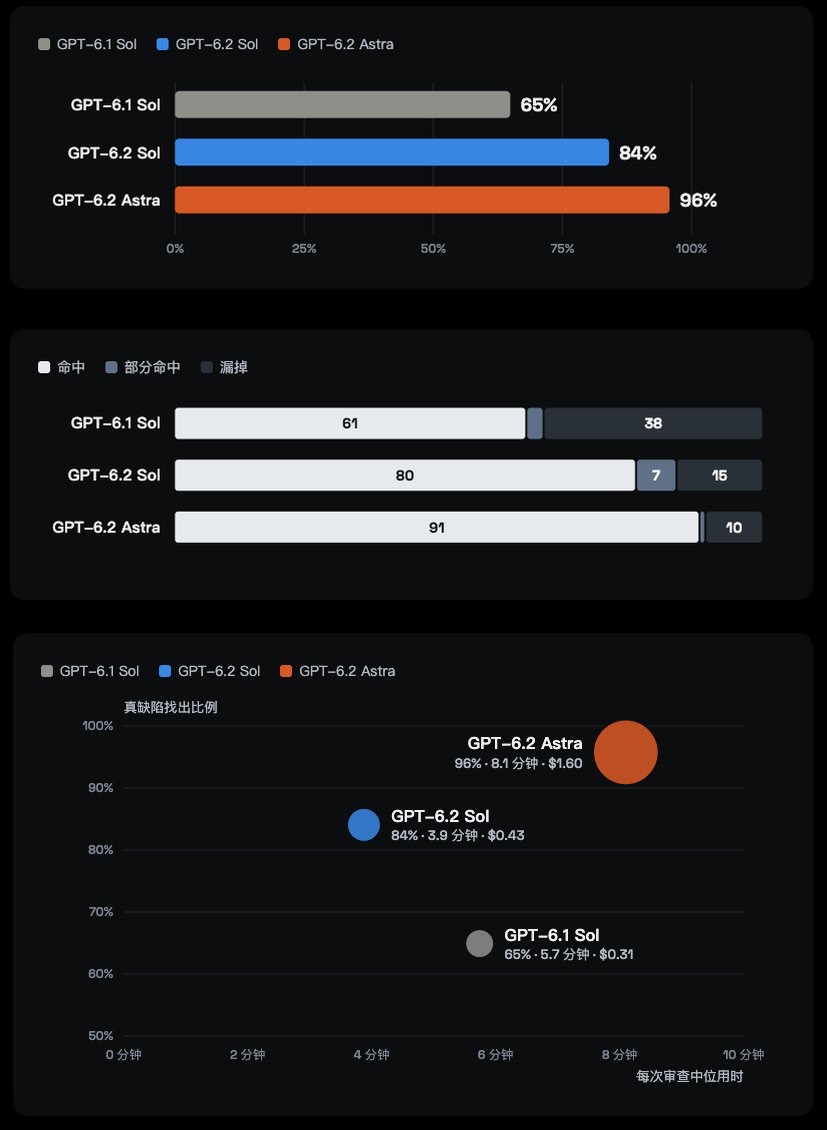 图 17:xhigh 推理强度下代码审查真缺陷检出比例、命中分布与耗时/成本散点图——GPT-6.2 Sol xhigh(84% · 3.9分钟 · $0.43)加冕日常性价比最强默认审查模型
点击放大原图
图 17:xhigh 推理强度下代码审查真缺陷检出比例、命中分布与耗时/成本散点图——GPT-6.2 Sol xhigh(84% · 3.9分钟 · $0.43)加冕日常性价比最强默认审查模型
3.3 平面与 2D 动效视频审美(惨不忍睹):ChatGPT 四周年致敬短片三模型同台处刑
除了 3D 空间之外,OpenAI 在传统平面与 2D 动效上的审美依然毫无长进。用经典的《ChatGPT 四周年致敬动效视频(2022.11.30–2026.11.30)》同题横向对比三家旗舰,点击下方播放器即可直观感受差距:
实测题 2:ChatGPT 四周年第三方致敬动效视频(40–60 秒)2D 动效 & 视觉审美
| 1 | 做一支 40 秒到 1 分钟的 ChatGPT 四周年致敬动效视频(2022.11.30–2026.11.30),16:9 横版,无旁白,配原创音乐。内容自己联网查证,讲这四年的关键版本、里程碑和数字,不得杜撰。动手前先去 OpenAI 官网、博客和近期发布视频里观察他们的视觉风格,提炼后作为这支片子的视觉基调。节奏要快,动效密、画面饱满,随音乐卡点。片子定位是第三方致敬,不要做成 OpenAI 官方出品的样子。 |
对比视频 01:Claude Fable 5.2 生成的 ChatGPT 四周年致敬动效短片(58s)
审美统治级标杆 · Claude Fable 5.2
对比视频 02:Gemini 4 Carbon 生成的 ChatGPT 四周年致敬动效短片(52s)
节奏在线 · Gemini 4 Carbon
对比视频 03:GPT-6.2 Astra 生成的 ChatGPT 四周年动效短片(52s · 看完沉默现场)
2D 审美反面教材 · GPT-6.2 Astra
3.4 3D 空间视觉与 Three.js(意外惊喜):为具身智能打底,1 小时肝出极繁古希腊世界
与拉胯的 2D 动效截然相反——由于 OpenAI 一直在发力空间视觉(Spatial Vision) 为具身智能打基础,GPT-6.2 Astra 在 3D 游戏与 Three.js 大场景上的进化非常猛!
案例 A:第一人称 3A 写实风《神庙逃亡》(1 轮微调超预期)
实测题 3:第一人称照片级图形《神庙逃亡》可玩游戏3D 游戏构建
| 1 | 给我做一个第一人称的「神庙逃亡」游戏。极度详细的游戏画面质量,视觉上看起来要能跟 AAA 级游戏匹敌。让它规模小一点,但其他方面要有令人印象深刻的照片级真实图形。 |
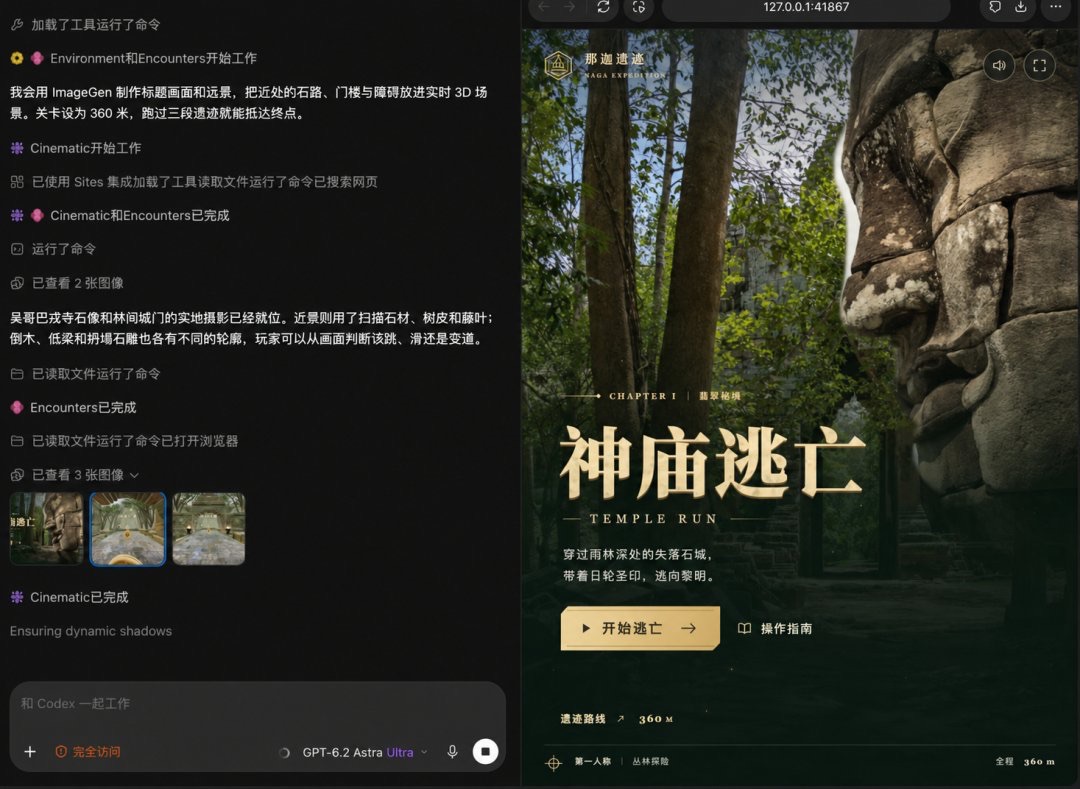 图 18:GPT-6.2 Astra 生成的第一人称《神庙逃亡》游戏启动封面——光影纵深与石刻材质已初具大作气象
点击放大原图
图 18:GPT-6.2 Astra 生成的第一人称《神庙逃亡》游戏启动封面——光影纵深与石刻材质已初具大作气象
实机演示 04:GPT-6.2 Astra 第一人称《神庙逃亡》针对玩法微调 1 轮后的实机跑酷画面(41s)
3D 游戏质感越级 · GPT-6.2 Astra
案例 B:Three.js《秋日黄昏乡村小火车站》治愈系空间沙盘
实机演示 05:GPT-6.2 Astra 用 Three.js 构建的《秋日黄昏乡村小火车站》场景漫游(31s)
Three.js 暖调氛围 · GPT-6.2 Astra
案例 C:喂入一张标杆截图,苦跑 1 个多小时交出极繁《古希腊世界》!
面对极简的一句话《古希腊世界》Prompt,GPT-6.2 Astra 第一版已经不错;随后卡兹克把之前 X 上爆火的一张 Claude 长时构建案例截图喂给 GPT 让它“照着建”——原本没抱太大希望,结果 GPT-6.2 Astra 连续硬刚了 1 个多小时,交出了一份令人惊叹的极繁可交互 3D 古希腊卫城全景 HTML:
实测题 4:Three.js 极繁艺术风格《古希腊世界》可交互 HTML长程 3D 构建
| 1 | 运用Three.js,采用极繁艺术风格尽全力还原出最真实、宏伟壮观且复杂的古希腊世界,要求真实细腻,最后交付一个可交互的HTML文件。 |
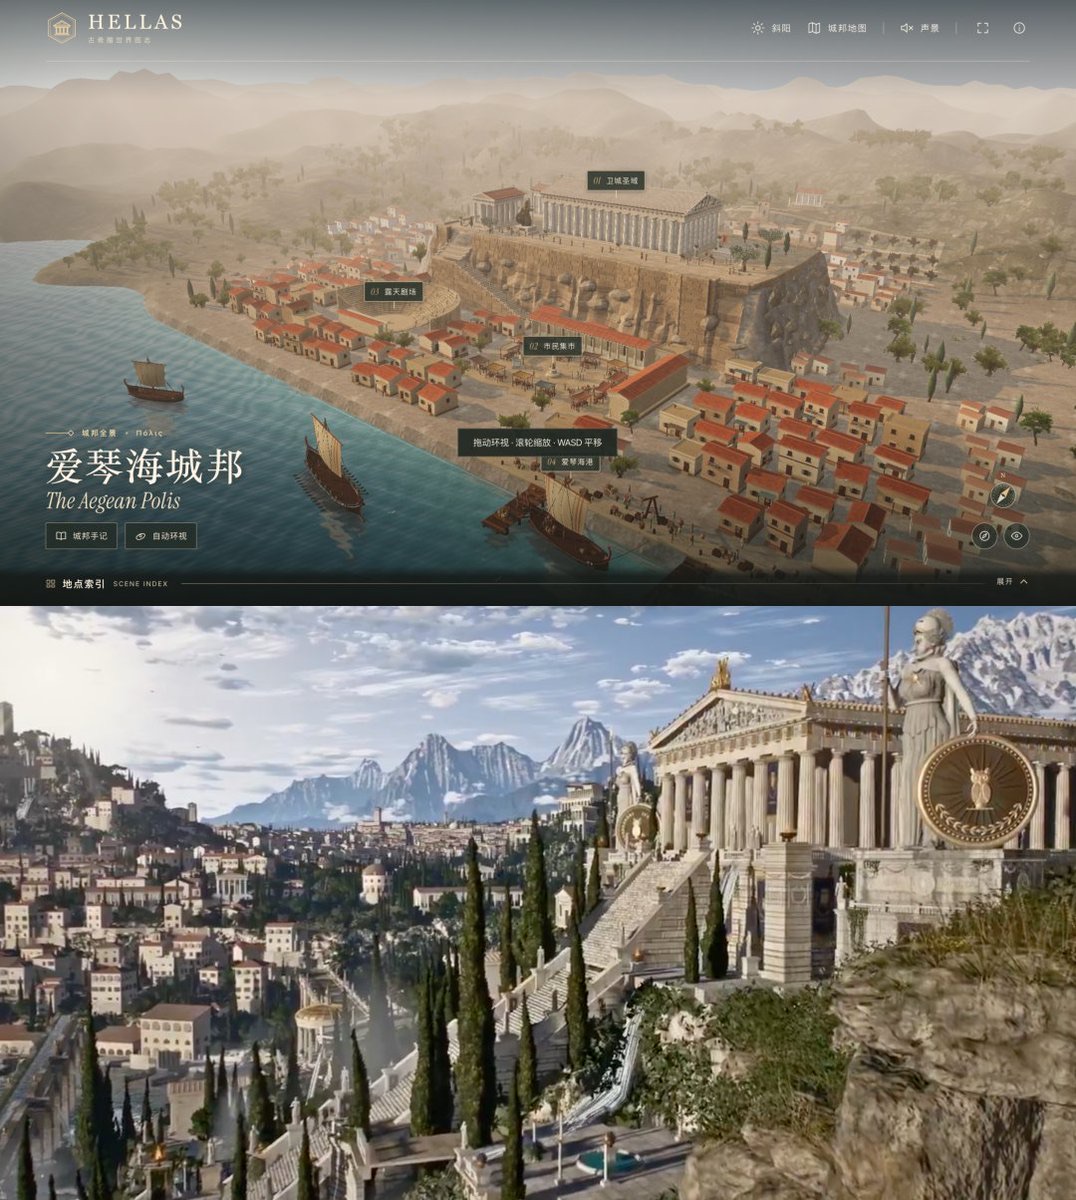 图 19:喂给 GPT-6.2 Astra 作为二轮视觉标杆锚点的 Claude 爆款古希腊场景截图
点击放大原图
图 19:喂给 GPT-6.2 Astra 作为二轮视觉标杆锚点的 Claude 爆款古希腊场景截图
实机演示 06:GPT-6.2 Astra 参照标杆图连续运行 1 小时+ 交付的极繁 Three.js《古希腊世界》(29s)
1小时+ 极限长程工程 · GPT-6.2 Astra
四、写在最后:Claude/Gemini 才是 ToC,GPT 已彻底走向「To 精英工业重器」
过去行业里一直有个刻板印象:“Claude 是做 ToB 的,GPT 才是做 ToC 的”。但走到 6.2 这一代,事实恰恰彻底反过来了:
- Claude 与 Gemini 4 Carbon 才是真正适合普通人(ToC)的模型:它们沟通自然、善于换位思考、表达可读性极高,能够主动帮你拆解模糊想法,去拓展个人过去无法触及的能力边界;
- GPT 系列已演变为纯粹「To 精英」的高密工业仪器:它极度严谨、绝对听话、Token 压缩密度极高,在顶尖科学家与算法大佬手里指哪打哪;但对于没有严密形式化规格书的普通开发者而言,直接跟 GPT 沟通需求既费劲又低效。
终极实战心法:让 Claude 或 Gemini 大人帮你指挥 GPT!
不必硬着头皮直接和 GPT 对话聊需求——把沟通立项、产品拆解、前端审美与主代码编写交给 Claude Fable 5.2 + Gemini 4 Carbon,再让它们生成精确的工程契约去调度 GPT-6.2 Sol xhigh(日常 3 轮代码审查,84% 检出率 / $0.43) 与 GPT-6.2 Astra(科研终端计算、1 小时 3D 空间攻坚及核心发版前 96% 终审),这正是当下体验与成本双赢的最优解。
觉得本文有启发?一键复制标准引用摘要
自带原文归因链接与核心摘要,可直接粘贴至团队飞书/Slack 知识库、技术周报或大模型上下文。